# Introduction

Cẩm nang NQDEV - Nền tảng tri thức chuyên sâu về lập trình, DevOps, Database và kiến trúc hệ thống, được xây dựng bởi Nguyễn Quý DevNet. Hướng dẫn thực chiến cho lập trình viên và kỹ sư công nghệ.

### Giới thiệu về Cẩm nang NQDEV <a href="#gioi-thieu" id="gioi-thieu"></a>

Trong thời đại chuyển đổi số bùng nổ, việc sở hữu một nguồn tri thức đáng tin cậy trở thành lợi thế quan trọng giúp lập trình viên phát triển nhanh và bền vững. **Cẩm nang NQDEV** được xây dựng như một nền tảng hướng dẫn chuyên sâu, mang tính ứng dụng cao, đồng thời là một phần của hệ sinh thái **NQDEV Platform** – dự án tri thức do **Nguyễn Quý DevNet** phát triển và vận hành.

Tại đây, mỗi bài viết không chỉ truyền đạt kiến thức kỹ thuật, mà còn mở ra góc nhìn dài hạn giúp bạn định hình tư duy, nâng cao năng lực và tự tin bước vào những dự án phức tạp hơn.

***

### Tầm nhìn và sứ mệnh <a href="#tam-nhin-va-su-menh" id="tam-nhin-va-su-menh"></a>

**Cẩm nang NQDEV** hướng đến mục tiêu trở thành nền tảng học tập toàn diện cho cộng đồng lập trình viên:

* **Nội dung chuyên sâu, gần gũi:** Giúp người đọc hiểu bản chất và vận dụng dễ dàng vào thực tế.
* **Kinh nghiệm thực chiến:** Tổng hợp từ nhiều năm làm việc và phát triển hệ thống của **Nguyễn Quý DevNet**.
* **Tài nguyên lâu dài:** Xây dựng cho **NQDEV Platform**, tạo hệ sinh thái hỗ trợ phát triển kiến thức xuyên suốt.
* **Tư duy chuẩn doanh nghiệp:** Định hướng giải quyết vấn đề theo phương pháp chuẩn DevOps, chuẩn sản phẩm.

Với định hướng đó, **Cẩm nang NQDEV** trở thành nơi chia sẻ tri thức thiết thực, cập nhật, và đáng tin cậy.

***

### Các chủ đề chính <a href="#chu-de-chinh" id="chu-de-chinh"></a>

Hệ sinh thái **NQDEV Platform** bao gồm nhiều mảng kiến thức được phân bổ hợp lý, giúp người đọc dễ tiếp cận theo từng lĩnh vực:

#### Lập trình & Backend

* **.NET, Node.js, Next.js, API Design:** Các framework và ngôn ngữ phổ biến trong phát triển backend hiện đại.
* **Kiến trúc dịch vụ, tối ưu hiệu năng:** Lập trình tối ưu hiệu năng và best practices trong xây dựng hệ thống thực tế.

#### DevOps & Vận hành hệ thống

* **Docker, HAProxy, CI/CD Pipelines:** Các công cụ container hóa và tự động hóa triển khai.
* **Quản lý hạ tầng, bảo mật:** Tối ưu hệ thống hoạt động liên tục và phương pháp phòng vệ nhiều lớp.

#### Dữ liệu & cơ sở dữ liệu

* **MongoDB, SQL Server, MySQL:** Thiết kế Database chuẩn hóa và tối ưu truy vấn.
* **Xử lý dữ liệu lớn:** Kỹ thuật làm việc với dữ liệu quy mô lớn và phân tán.

#### Sản phẩm công nghệ & Mini apps

* **Case study thực chiến:** Các dự án xây dựng ứng dụng thực tế từ **Nguyễn Quý DevNet**.
* **Chiến lược sản phẩm:** Tạo sản phẩm bền vững, tối ưu chi phí.

Mỗi nội dung không chỉ dừng lại ở hướng dẫn từng bước, mà còn phân tích lý do lựa chọn, sai lầm thường gặp và cách vận dụng khi xây dựng hệ thống quy mô lớn.

***

### Điểm khác biệt <a href="#diem-khac-biet" id="diem-khac-biet"></a>

#### Gắn với thực tế, không lan man lý thuyết

Kiến thức được rút ra từ quá trình triển khai dự án thực tế của **Nguyễn Quý DevNet**, mang tính ứng dụng cao và phù hợp môi trường doanh nghiệp.

#### Tư duy dài hạn – góc nhìn chiến lược

Bài viết không chỉ trả lời "làm thế nào?", mà còn đề cập "vì sao nên làm như thế?", "nếu mở rộng hệ thống thì sao?", đúng định hướng của **NQDEV Platform**.

#### Hệ sinh thái tri thức thống nhất

Toàn bộ nội dung được liên kết chặt chẽ, giúp bạn phát triển theo lộ trình rõ ràng, phù hợp cho cả người mới lẫn lập trình viên lâu năm.

#### Luôn cập nhật theo xu hướng

Các bài viết trong **Cẩm nang NQDEV** được rà soát và cập nhật theo những công nghệ mới để đảm bảo không bị lạc hậu.

***

### Lợi ích dành cho người đọc <a href="#loi-ich" id="loi-ich"></a>

Khi theo dõi **Cẩm nang NQDEV**, bạn sẽ:

* **Nâng cao kỹ năng:** Lập trình, DevOps, quản trị dữ liệu theo chuẩn doanh nghiệp.
* **Giải quyết vấn đề nhanh hơn:** Nhờ các ví dụ thực chiến và hướng dẫn rõ ràng.
* **Có tư duy hệ thống vững vàng:** Điều quan trọng để phát triển sự nghiệp lâu dài.
* **Sở hữu tài nguyên học tập chuyên sâu:** Trong hệ sinh thái **NQDEV Platform**.
* **Kết nối cộng đồng:** Nơi chia sẻ kinh nghiệm và ý tưởng thực tế từ **Nguyễn Quý DevNet**.

***

### Kết luận <a href="#ket-luan" id="ket-luan"></a>

**Cẩm nang NQDEV** không chỉ là nơi học tập mà còn là nguồn cảm hứng giúp bạn phát triển năng lực một cách có định hướng. Với nền tảng tri thức đồng bộ từ **NQDEV Platform** và sự dẫn dắt của **Nguyễn Quý DevNet**, đây sẽ là người bạn đồng hành đáng tin cậy trên con đường trở thành một chuyên gia công nghệ thực thụ.

<p align="center">☕ <strong>Ủng hộ dự án tại</strong>: <a href="https://me.momo.vn/nhquydev">Mua cà phê cho NQDEV</a>.</p>

<figure><img src="https://img.vietqr.io/image/MB-VQRQAAXGO9340-gjSyj8L.png?amount=10000&#x26;accountName=NGUYEN%20HUU%20QUY&#x26;addInfo=Mua%20ca%20phe%20cho%20NQDEV" alt=""><figcaption></figcaption></figure>


# Languages & Frameworks


# dotNET

Lập trình .NET với C#: Hướng dẫn chi tiết, ví dụ minh họa về phát triển ứng dụng web, desktop, di động với C#. Nâng cao kỹ năng lập trình với các công nghệ như ASP.NET, Entity Framework, Blazor.


# ASP.NET Core

ASP.NET Core là một framework mạnh mẽ để tạo các ứng dụng web và dịch vụ với các đặc điểm nổi bật: nhanh, bảo mật, đa nền tảng và hỗ trợ đám mây.


# Hướng dẫn xây dựng ứng dụng web bằng ASP.NET Core và Blazor trên nền .NET 8 LTS

## Tại sao chọn .NET 8 LTS?

.NET 8 được công bố vào tháng 11 năm 2023 và là phiên bản Long‑Term Support (LTS) mới nhất của nền tảng .NET. Theo chính sách hỗ trợ của Microsoft, các bản phát hành LTS được bảo đảm cập nhật và sửa lỗi miễn phí trong ba năm, trong khi các bản Standard Term Support (STS) chỉ được hỗ trợ 18 tháng. Microsoft cũng duy trì chu kỳ phát hành hàng năm; các phiên bản có số chẵn (như .NET 8) là LTS nên phù hợp cho các dự án cần độ ổn định lâu dài.

Ngoài bảo đảm hỗ trợ lâu dài, .NET 8 còn mang lại nhiều cải tiến về hiệu năng và công cụ. Bản phát hành này giới thiệu trình biên dịch **Dynamic Profile‑Guided Optimisation (PGO)** giúp tối ưu mã dựa trên dữ liệu chạy thực tế, giúp các API JSON tăng tới 18 % hiệu suất và kịch bản phức tạp như Fortunes tăng tới 24 %. Bản phát hành cũng bổ sung chế độ biên dịch Ahead‑of‑Time (AOT), hỗ trợ container gọn nhẹ và các công cụ phát triển mới. Đặc biệt, Blazor trong .NET 8 trở thành framework giao diện người dùng **full stack** – có thể kết hợp cả Blazor Server và Blazor WebAssembly trong cùng một ứng dụng.

## Chuẩn bị môi trường

1. **Cài .NET 8 SDK (LTS)** – tải bộ cài từ trang chủ `.NET` và cài đặt đúng phiên bản cho hệ điều hành của bạn. Kiểm tra bằng lệnh `dotnet --version` để chắc chắn đã cài đặt thành công.
2. **IDE/Editor** – Visual Studio 2022 (v17.8 trở lên) hoặc Visual Studio Code kèm các extension C#. Visual Studio mang lại trải nghiệm hoàn chỉnh, còn VS Code phù hợp nếu bạn cần công cụ nhẹ hoặc muốn làm việc đa nền tảng.

## Tạo dự án Blazor trên .NET 8

### 1. Mô hình dự án mới – **Blazor Web App**

Trong .NET 8, Microsoft thống nhất các mẫu dự án Blazor thành một **Blazor Web App** duy nhất. Mẫu này kết hợp ưu điểm của Blazor Server và Blazor WebAssembly, đồng thời hỗ trợ **server‑side rendering tĩnh**, **rendering tương tác trên server**, **rendering tương tác bằng WebAssembly** và **chế độ Auto**. Các mẫu cũ như *Blazor Server* và tuỳ chọn *ASP.NET Core Hosted* trong Blazor WebAssembly đã bị loại bỏ, tuy nhiên các ứng dụng cũ vẫn được hỗ trợ trong .NET 8.

Để tạo dự án:

* **Visual Studio** – chọn **Create a new project → Blazor Web App**. Điền tên dự án và chọn kiểu rendering mặc định (Static, Interactive Server, Interactive WebAssembly hoặc Auto).
* **CLI** – dùng lệnh:

  ```bash
  bashSao chépChỉnh sửadotnet new blazorwebapp -n MyBlazorApp
  ```

  Tham số `--hosted` không còn cần thiết vì mô hình mới đã hỗ trợ cả client và server.

### 2. Các chế độ rendering trong Blazor Web App

| Chế độ                                              | Mô tả & đặc điểm chính                                                                                                                                                                  |
| --------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| **Static server‑side rendering (Static SSR)**       | Tạo HTML tĩnh trên server, phù hợp cho SEO và tốc độ tải lần đầu. Không có tương tác phía client cho tới khi bật chế độ tương tác.                                                      |
| **Interactive Server (interactive SSR)**            | Thành phần được render trên server và duy trì kết nối thời gian thực bằng SignalR. Mọi sự kiện trên giao diện được gửi qua kết nối này và phản hồi lập tức.                             |
| **Interactive WebAssembly (Client‑side rendering)** | Toàn bộ .NET runtime và gói ứng dụng được tải xuống trình duyệt. Ứng dụng chạy trên client nên giảm tải cho server và hỗ trợ làm việc ngoại tuyến, nhưng thời gian tải ban đầu dài hơn. |
| **Interactive Auto**                                | Lần đầu dùng rendering server, sau đó tải gói WebAssembly và chuyển sang chạy client trong các lần truy cập tiếp theo. Giúp khởi động nhanh và tận dụng ưu điểm cả hai mô hình.         |

Chọn chế độ thích hợp phụ thuộc vào nhu cầu: SSR tĩnh cho nội dung SEO cao, Interactive Server cho ứng dụng phụ thuộc server và cập nhật thời gian thực, Interactive WebAssembly cho khả năng chạy offline hoặc tải trọng server thấp, và Auto khi muốn trải nghiệm cân bằng.

### 3. Dự án WebAssembly hoặc Blazor Server cũ

Nếu vẫn muốn tạo dự án riêng biệt như các phiên bản trước, có thể sử dụng lệnh:

* **WebAssembly (client)**:

  ```bash
  bashSao chépChỉnh sửadotnet new blazorwasm -n MyBlazorClientApp
  ```
* **Server**:

  ```bash
  bashSao chépChỉnh sửadotnet new blazorserver -n MyBlazorServerApp
  ```

Tuy nhiên, Microsoft khuyến khích chuyển sang mẫu Blazor Web App để tận dụng khả năng hợp nhất và nâng cấp dễ dàng.

## Cấu trúc dự án và xây dựng giao diện

Trong một dự án Blazor:

* **`App.razor`** định nghĩa router và layout chung: sử dụng `<Router AppAssembly="@typeof(Program).Assembly">` để ánh xạ các route tới component.
* **Thư mục `Pages`** chứa các trang `.razor` định tuyến với `@page "/route"`.
* **Thư mục `Shared`** chứa các component dùng chung như header, footer.
* **`wwwroot`** lưu trữ tệp tĩnh (CSS, ảnh, JS).

### Viết Razor Component

Component được viết trong các file `.razor` chứa markup HTML và mã C#. Ví dụ trang đếm số đơn giản:

```razor
razorSao chépChỉnh sửa@page "/counter"
<h3>Counter</h3>
<p>Current count: @currentCount</p>
<button @onclick="IncrementCount">Click me</button>

@code {
    private int currentCount = 0;
    private void IncrementCount()
    {
        currentCount++;
    }
}
```

Thuộc tính `@page "/counter"` xác định route, trong khi `@onclick="IncrementCount"` liên kết sự kiện click với hàm C# `IncrementCount`. Razor cho phép trộn lẫn C# và HTML một cách linh hoạt, đồng thời hỗ trợ binding dữ liệu hai chiều, validation, và component hóa.

### Điều hướng và cải tiến trong .NET 8

Blazor sử dụng thành phần `Router` để điều hướng. .NET 8 bổ sung cơ chế **enhanced navigation and form handling**: khi người dùng chuyển trang hoặc gửi form, Blazor có thể chặn yêu cầu, thực hiện yêu cầu qua `fetch` và cập nhật DOM mà không tải lại toàn bộ trang. Tính năng này giúp trải nghiệm mượt mà hơn, đồng thời hỗ trợ `NavigationManager.Refresh()` để làm mới trang hiện tại.

## Kết nối cơ sở dữ liệu với Entity Framework Core

### Cấu hình DbContext

Entity Framework Core (EF Core) cung cấp đối tượng `DbContext` làm cầu nối giữa ứng dụng và cơ sở dữ liệu. Trong ASP.NET Core, đăng ký `DbContext` thông qua phương thức `AddDbContext` sẽ tạo một instance cho mỗi yêu cầu. Ví dụ cấu hình trong `Program.cs`:

```csharp
csharpSao chépChỉnh sửavar connectionString = builder.Configuration.GetConnectionString("DefaultConnection")
    ?? throw new InvalidOperationException("Connection string 'DefaultConnection' not found.");

builder.Services.AddDbContext<ApplicationDbContext>(options =>
    options.UseSqlServer(connectionString));
```

Đoạn mã trên đọc chuỗi kết nối từ cấu hình và đăng ký `ApplicationDbContext` như dịch vụ có phạm vi (scoped); ngữ cảnh này sử dụng provider SQL Server. Lớp `ApplicationDbContext` cần có constructor nhận `DbContextOptions<ApplicationDbContext>` và kế thừa `DbContext`.

> **Lưu ý:** Blazor WebAssembly chạy trong sandbox của trình duyệt và không thể kết nối trực tiếp tới cơ sở dữ liệu; bạn cần gọi API hoặc sử dụng phần server của mô hình Blazor Web App để truy cập dữ liệu. Microsoft khuyến cáo chỉ sử dụng EF Core trong Blazor Server hoặc trong phần `Server` của dự án được host.

### Tạo migration và cập nhật DB

Sau khi cấu hình `DbContext` và các entity, chạy các lệnh sau để tạo migration và cập nhật cơ sở dữ liệu:

```bash
bashSao chépChỉnh sửadotnet ef migrations add InitialCreate
dotnet ef database update
```

Kết quả sẽ tạo bảng tương ứng trong cơ sở dữ liệu và cập nhật schema mỗi khi có thay đổi.

## Triển khai ứng dụng

### Deploy lên Azure App Service

1. Đăng nhập Azure và tạo một **App Service** phù hợp (.NET 8).
2. Trong Visual Studio, chọn **Publish → Azure → App Service**.
3. Cấu hình tên, vùng và kết nối. Visual Studio sẽ xây dựng, xuất bản và cấu hình CI/CD nếu cần.

### Triển khai bằng Docker

Tạo file `Dockerfile` sử dụng image .NET 8 và publish ứng dụng ở chế độ Release:

```dockerfile
dockerfileSao chépChỉnh sửaFROM mcr.microsoft.com/dotnet/aspnet:8.0 AS base
WORKDIR /app

FROM mcr.microsoft.com/dotnet/sdk:8.0 AS build
WORKDIR /src
COPY . .
RUN dotnet publish -c Release -o /app/publish

FROM base AS final
WORKDIR /app
COPY --from=build /app/publish .
ENTRYPOINT ["dotnet", "MyBlazorApp.dll"]
```

Dùng lệnh:

```bash
bashSao chépChỉnh sửadocker build -t myblazorapp .
docker run -d -p 80:80 myblazorapp
```

để xây image và chạy container. .NET 8 hỗ trợ xuất bản image không cần Dockerfile và thêm người dùng không root để tăng bảo mật.

## Tính năng nâng cao và thực hành tốt

* **Xác thực & phân quyền** – ASP.NET Core 8 cung cấp UI Identity dựa trên Blazor và cookie authentication sẵn sàng dùng. Bạn có thể tích hợp Identity hoặc xác thực bên ngoài (Google, Facebook).
* **SignalR** – Sử dụng để xây dựng các tính năng thời gian thực như chat, thông báo. Blazor Server sử dụng SignalR để duy trì kết nối, giúp việc tích hợp dễ dàng.
* **JavaScript Interop** – Khi cần sử dụng thư viện JavaScript, Blazor cho phép gọi JS từ C# và ngược lại.
* **Antiforgery** – .NET 8 bổ sung thẻ `AntiforgeryToken` và thuộc tính `[RequireAntiforgeryToken]` để bảo vệ form khỏi tấn công CSRF.
* **Hiệu năng** – Sử dụng Static SSR cho các trang ít tương tác để tận dụng khả năng cache, chuyển sang Interactive khi cần. Tận dụng `InteractiveAuto` để tối ưu trải nghiệm người dùng.

## Kết luận

Blazor và ASP.NET Core trong .NET 8 LTS mang lại bước tiến lớn: **giao diện full stack thống nhất**, lựa chọn linh hoạt giữa server và WebAssembly, kèm theo hiệu năng và bảo mật được cải thiện mạnh mẽ. Việc Microsoft đưa ra chính sách hỗ trợ ba năm cho LTS giúp các nhà phát triển như bạn yên tâm xây dựng những sản phẩm dài hạn. Trong khi đó, những cải tiến về rendering, form handling, EF Core và công cụ triển khai mở ra nhiều cơ hội sáng tạo.

Hãy bắt đầu với dự án đầu tiên của bạn bằng .NET 8, tận dụng Blazor Web App để khai thác sức mạnh full stack, và chia sẻ trải nghiệm của bạn cùng cộng đồng. Tin chắc rằng nền tảng này sẽ giúp các ứng dụng web của bạn không chỉ **ổn định và bền vững** mà còn **đột phá và khác biệt** trong tương lai.


# Message Queue

Message Queue là một cơ chế trong lập trình và kiến trúc phần mềm, được sử dụng để truyền thông tin (thông điệp) giữa các thành phần của hệ thống mà không cần chúng tương tác trực tiếp với nhau.


# ZeroMQ

ZeroMQ (còn được gọi là ØMQ, 0MQ hoặc ZMQ) trông giống như một thư viện mạng có thể nhúng nhưng hoạt động như một khung đồng thời.


# Xây dựng ZeroMQ Server trong dotNET 8 với CSharp

[ZeroMQ](/languages-and-frameworks/dotnet/message-queue/zeromq) (ØMQ) là một thư viện mã nguồn mở mạnh mẽ để xử lý giao tiếp tin nhắn bất đồng bộ trong các hệ thống phân tán. Tuy nhiên, ZeroMQ không cung cấp một server mặc định, thay vào đó, bạn có thể sử dụng thư viện **NetMQ** để triển khai một **ZeroMQ server** trong môi trường **.NET 8** với C#.

## 1. Cài đặt NetMQ trong dự án .NET 8

Trước tiên, bạn cần cài đặt thư viện **NetMQ**, một thư viện thay thế ZeroMQ dành cho .NET:

```bash
dotnet add package NetMQ
```

## 2. Tạo file cấu hình **config.json**

File này giúp chúng ta xác định **cổng lắng nghe** và **các cặp client A - client B** cần định tuyến độc lập.

```json
{
  "port": 5555,
  "routes": [
    {
      "clientA": "ClientA1",
      "clientB": "ClientB1"
    },
    {
      "clientA": "ClientA2",
      "clientB": "ClientB2"
    }
  ]
}
```

## 3. Code ZeroMQ Server

Server sử dụng **RouterSocket** để nhận thông điệp từ Client A và chuyển tiếp đến Client B theo cấu hình.

```csharp
using System;
using System.Collections.Generic;
using System.IO;
using System.Text.Json;
using NetMQ;
using NetMQ.Sockets;

class ZeroMQServer
{
    static void Main(string[] args)
    {
        string configPath = "config.json";
        if (!File.Exists(configPath))
        {
            Console.WriteLine("File cấu hình không tồn tại!");
            return;
        }

        var config = JsonSerializer.Deserialize<ServerConfig>(File.ReadAllText(configPath));
        int port = config.Port;
        var routes = config.Routes;

        Console.WriteLine($"Server chạy trên cổng: {port}");

        using (var routerSocket = new RouterSocket($"@tcp://*:{port}"))
        {
            Console.WriteLine("ZeroMQ Server đang chạy...");

            while (true)
            {
                var clientIdentity = routerSocket.ReceiveFrameString();
                var emptyFrame = routerSocket.ReceiveFrameString();
                var message = routerSocket.ReceiveFrameString();

                Console.WriteLine($"Nhận từ {clientIdentity}: {message}");

                var targetRoute = routes.Find(route => route.ClientA == clientIdentity);
                if (targetRoute != null)
                {
                    routerSocket.SendMoreFrame(targetRoute.ClientB).SendMoreFrame("").SendFrame(message);
                    Console.WriteLine($"Chuyển tiếp đến {targetRoute.ClientB}: {message}");
                }
                else
                {
                    Console.WriteLine($"Không tìm thấy định tuyến cho {clientIdentity}!");
                }
            }
        }
    }
}

public class ServerConfig
{
    public int Port { get; set; }
    public List<Route> Routes { get; set; }
}

public class Route
{
    public string ClientA { get; set; }
    public string ClientB { get; set; }
}
```

## 4. Code Client

### Client A (Gửi thông điệp):

```csharp
using System;
using NetMQ;
using NetMQ.Sockets;

class ZeroMQClientA
{
    static void Main(string[] args)
    {
        using (var dealerSocket = new DealerSocket(">tcp://localhost:5555"))
        {
            dealerSocket.Options.Identity = System.Text.Encoding.UTF8.GetBytes("ClientA1");
            Console.WriteLine("Client A1 đã kết nối với server...");
            
            string message = "Hello from ClientA1";
            dealerSocket.SendFrame(message);
            Console.WriteLine($"Đã gửi: {message}");
        }
    }
}
```

### Client B (Nhận thông điệp):

```csharp
using System;
using NetMQ;
using NetMQ.Sockets;

class ZeroMQClientB
{
    static void Main(string[] args)
    {
        using (var dealerSocket = new DealerSocket(">tcp://localhost:5555"))
        {
            dealerSocket.Options.Identity = System.Text.Encoding.UTF8.GetBytes("ClientB1");
            Console.WriteLine("Client B1 đã kết nối với server...");
            
            var message = dealerSocket.ReceiveFrameString();
            Console.WriteLine($"Client B1 nhận được: {message}");
        }
    }
}
```

## 5. Chạy ứng dụng

* Chạy **Server** trước.
* Chạy **Client A1** để gửi thông điệp.
* Chạy **Client B1** để nhận thông điệp.
* Thử thêm nhiều cặp Client A2 - B2 theo cấu hình JSON.

## 6. Kết quả mong đợi

* Server hiển thị log:

  ```bash
  Nhận từ ClientA1: Hello from ClientA1
  Chuyển tiếp đến ClientB1: Hello from ClientA1
  ```
* Client B1 hiển thị:

  ```bash
  Client B1 nhận được: Hello from ClientA1
  ```

## 7. Tổng kết

Bài viết này đã hướng dẫn bạn cách xây dựng một [**ZeroMQ server trong .NET 8**](/languages-and-frameworks/dotnet/message-queue/zeromq/xay-dung-zeromq-server-trong-dotnet-8-voi-csharp) với C#, sử dụng **Router-Dealer** để định tuyến thông điệp giữa các cặp Client A - Client B độc lập. Bạn có thể mở rộng thêm bằng cách:

* Hỗ trợ nhiều cổng khác nhau trong cấu hình.
* Thêm các lớp bảo mật như xác thực client.
* Ghi log và lưu trữ trạng thái tin nhắn vào database.

Hy vọng bài viết giúp bạn triển khai ZeroMQ hiệu quả trong ứng dụng của mình! 🚀


# Optimize


# Optimize - Một số cách tối ưu code và performance CSharp

Nguồn: viblo.asia

## **Mở đầu**

Trong bài viết này, chúng ta sẽ tìm hiểu một số mẹo và thủ thuật C# hữu ích về cách cải thiện chất lượng và hiệu suất khi viết code.

Đầu tiên, chúng ta sẽ tìm hiểu cách cải thiện chất lượng code của mình bằng một số mẹo liên quan đến khả năng đọc và giảm reducing nesting code.

Sau đó, chúng ta sẽ thấy một số lưu ý khi nói đến việc xử lý ngoại lệ mà chúng ta cần lưu ý. Khi code chúng ta rất hay bắt gặp các trường hợp

* Guarding against null values: Kiểm tra các giá trị null
* If-else statements: Lệnh if-else
* Exception handling: Bắt exception

### **Cách kiểm tra null**

Khá chắc rằng trong bất kỳ dự án lớn nhỏ nào chúng ta đều có đoạn check null. Nếu object return null thì exception NullReferenceException được throw. Bình thường chúng ta sẽ viết

```csharp
    var product = GetProduct();
    if (product == null)
    {
        // Do something if the object is null.
    }
```

Một cách check null khá hay và hiệu với is và is not quả ở C#

```csharp
    var product = GetProduct();
    if (product is not null)
    {
        // Do something if the object is not null.
    }
```

### **Tối ưu code với if- else**

```csharp
    Product PurchaseProduct(int id)
    {
        var product = GetProduct(id);
        if (product.Quantity > 0)
        {
            product.Quantity--;
            return product;
        }
        else
        {
            SendOutOfStockNotification(product);
            return null;
        }
    }
```

Khá loằng ngoằng. Ở đây chúng ta có thể xóa hẳn câu lệnh else ở dưới đi

```csharp
    bool IsProductInStock(int id)
    {
        var product = GetProduct(id);
        if (product is not null)
        {
            if (product.Quantity > 0)
            {
                return true;
            }
        }
        return false;
    }
```

Ở đây chúng ta thấy có 2 cái if lồng nhau. Để đảm bảo [early return principle](https://medium.com/swlh/return-early-pattern-3d18a41bba8) thì chúng ta nên viết

```csharp
    bool IsProductInStock(int id)
    {
        var product = GetProduct(id);
        if (product is null)
        {
            return false;
        }
        if (product.Quantity <= 0)
        {
            return false;
        }
        return true;
    }
```

Gọn hơn một chút thì chúng ta nên gộp 2 câu if kia vào thành 1

```csharp
    bool IsProductInStock(int id)
    {
        var product = GetProduct(id);
        if (product is null || product.Quantity <= 0)
        {
            return false;
        }
        return true;
    }
```

### **Sử dụng using**

Câu lệnh using đảm bảo rằng Dispose (hoặc DisposeAsync) được gọi ngay cả khi một ngoại lệ xảy ra trong khối using. Tìm hiểu thêm về [using](https://docs.microsoft.com/en-us/dotnet/csharp/language-reference/keywords/using-statement)

Một cách bình thường nhất khi chúng ta sử dụng using

```csharp
    using (var streamReader = new StreamReader("..."))
    {
        string content = streamReader.ReadToEnd();
    }
```

* Ở C# thì chúng ta có thể bỏ luôn dấu ngoặc kép sau using nhưng thế này

```csharp
    using var streamReader = new StreamReader("...");
    string content = streamReader.ReadToEnd();
```

### **Tối ưu cách đọc một Logical Expression**

Ví dụ chúng ta có một hàm để check xem ký tự truyền vào có phải một chữ cái hay không

```csharp
    bool IsLetter(char ch) => (ch >= 'a' && ch <= 'z') || (ch >= 'A' && ch <= 'Z');
```

Ở C# thì chúng ta có một cách viết đơn giản hơn. Chúng ta không cần truyền nhiều lần param `ch` vào nữa

```csharp
    bool IsLetter(char ch) => ch is (>= 'a' and <= 'z') or (>= 'A' and <= 'Z');
```

### **Xóa if-else khi check bool values**

Cách viết bình thường

```csharp
    bool IsInStock(Product product)
    {
        if (product.Quantity > 0)
        {
            return true;
        }
        else
        {
            return false;
        }
    }
```

Đơn giản hơn

```csharp
    bool IsInStock(Product product)
    {
        return product.Quantity > 0;
    }
```

hoặc

```csharp
    bool IsInStock(Product product) => product.Quantity > 0;
```

### **Với switch case thì sao**

Ví dụ chúng ta có một đoạn switch check xem hôm nay có phải ngày cuối tuần hay không.

```csharp
    switch (DateTime.Now.DayOfWeek)
    {
        case DayOfWeek.Monday:
            return "Not Weekend";
        case DayOfWeek.Tuesday:
            return "Not Weekend";
        case DayOfWeek.Wednesday:
            return "Not Weekend";
        case DayOfWeek.Thursday:
            return "Not Weekend";
        case DayOfWeek.Friday:
            return "Not Weekend";
        case DayOfWeek.Saturday:
            return "Weekend";
        case DayOfWeek.Sunday:
            return "Weekend";
        default:
            throw new ArgumentOutOfRangeException();
    }
```

Hoàn toàn có thể viết ngắn gọn lại

```csharp
    switch (DateTime.Now.DayOfWeek)
    {
        case DayOfWeek.Monday:
        case DayOfWeek.Tuesday:
        case DayOfWeek.Wednesday:
        case DayOfWeek.Thursday:
        case DayOfWeek.Friday:
            return "Not Weekend";
        case DayOfWeek.Saturday:
        case DayOfWeek.Sunday:
            return "Weekend";
        default:
            throw new ArgumentOutOfRangeException();
    }
```

hoặc với C#

```csharp
    DateTime.Now.DayOfWeek switch
    {
        DayOfWeek.Monday => "Not Weekend",
        DayOfWeek.Tuesday => "Not Weekend",
        DayOfWeek.Wednesday => "Not Weekend",
        DayOfWeek.Thursday => "Not Weekend",
        DayOfWeek.Friday => "Not Weekend",
        DayOfWeek.Saturday => "Weekend",
        DayOfWeek.Sunday  => "Weekend",
        _ => throw new ArgumentOutOfRangeException()
    }
```

với C#

```csharp
    DateTime.Now.DayOfWeek switch
    {
        DayOfWeek.Monday or DayOfWeek.Tuesday or DayOfWeek.Wednesday or DayOfWeek.Thursday or DayOfWeek.Friday => "Not Weekend",
        DayOfWeek.Saturday or DayOfWeek.Sunday => "Weekend",
        _ => throw new ArgumentOutOfRangeException()
    }
```

dùng not trong C#

```csharp
    DateTime.Now.DayOfWeek switch
    {
        not (DayOfWeek.Saturday or DayOfWeek.Sunday) => "Not Weekend",
        DayOfWeek.Saturday or DayOfWeek.Sunday => "Weekend",
        _ => throw new ArgumentOutOfRangeException()
    }
```

### **Cách tối hơn khi filter exception**

Ví dụ chúng ta có một đoạn filter exception 400 bad request với 404 not found

```csharp
    try
    {
        await GetBlogsFromApi();
    }
    catch (HttpRequestException e)
    {
        if (e.StatusCode == HttpStatusCode.BadRequest)
        {
            HandleBadRequest(e);
        }
        else if (e.StatusCode == HttpStatusCode.NotFound)
        {
            HandleNotFound(e);
        }
    }
```

đơn giản và clear hơn khi dùng với `when`

```csharp
    try
    {
        await GetBlogsFromApi();
    }
    catch (HttpRequestException e) when (e.StatusCode == HttpStatusCode.BadRequest)
    {
        HandleBadRequest(e);
    }
    catch (HttpRequestException e) when (e.StatusCode == HttpStatusCode.NotFound)
    {
        HandleNotFound(e);
    }
```

## **Tóm lại**

Ở đây mình tổng hợp một số trick thường được dùng hoặc là mình hay dùng để tối ưu code. Cho dòng code ngắn gọn dễ hiểu và performance tốt hơn trong C#.

Cảm ơn các bạn đã theo dõi


# Dev Blogs


# Versions of .NET

.NET 10 mang đến nhiều cải tiến từ .NET 9 như hỗ trợ AVX10.2, nâng cấp OpenAPI 3.1, tối ưu Entity Framework Core, Blazor và C# 14. Cập nhật đầy đủ tại Versions of .NET. 🚀


# Cập nhật từ .NET 9 lên .NET 10: Những thay đổi quan trọng

.NET 10 Preview 1 cải thiện hiệu suất, hỗ trợ AVX10.2, nâng cấp OpenAPI 3.1, tối ưu Entity Framework Core và Blazor. Những thay đổi này giúp lập trình viên có trải nghiệm tốt hơn và hiệu suất cao hơn.

Microsoft vừa ra mắt **.NET 10 Preview 1**, mang lại nhiều cải tiến đáng kể so với **.NET 9**. Bài viết này sẽ đi sâu vào những thay đổi quan trọng trong **runtime, thư viện, C# 14, ASP.NET Core, .NET MAUI và Entity Framework Core**, giúp bạn hiểu rõ những điểm mới và so sánh với phiên bản trước.

📢 **Nguồn tham khảo**:

* Blog chính thức: [NET 10 Preview 1](https://devblogs.microsoft.com/dotnet/dotnet-10-preview-1/)
* Video cập nhật: [NET Previews Unboxed - .NET 10 Preview 1, C# 14, HybridCache & More](https://youtu.be/VncMk8ryxV8)

## Bảng so sánh thay đổi từ .NET 9 lên .NET 10

| Thành phần                                                   | .NET 9                               | .NET 10                                                        | Ưu điểm                                                            | Nhược điểm                                     |
| ------------------------------------------------------------ | ------------------------------------ | -------------------------------------------------------------- | ------------------------------------------------------------------ | ---------------------------------------------- |
| **Runtime**                                                  | Không hỗ trợ AVX10.2                 | Hỗ trợ AVX10.2, cải thiện hiệu suất trên CPU mới               | Tăng tốc xử lý vector, tối ưu hiệu suất cho phần cứng hiện đại     | Chỉ có lợi khi chạy trên CPU hỗ trợ AVX10.2    |
| **Chứng chỉ (Certificate)**                                  | Chỉ hỗ trợ SHA-1                     | Thêm phương thức `FindByThumbprint` hỗ trợ thuật toán băm khác | Bảo mật cao hơn, linh hoạt hơn trong tìm kiếm chứng chỉ            | Cần cập nhật code nếu đang dùng SHA-1          |
| **Đọc dữ liệu PEM**                                          | Không hỗ trợ ASCII/UTF-8             | Hỗ trợ đọc dữ liệu PEM từ file ASCII hoặc UTF-8                | Dễ dàng thao tác với dữ liệu PEM mà không cần chuyển đổi định dạng | Không ảnh hưởng lớn nếu không làm việc với PEM |
| **Hiệu suất ZipArchive**                                     | Chưa tối ưu                          | Cải thiện hiệu suất và quản lý bộ nhớ                          | Giảm thời gian xử lý file nén, tiết kiệm tài nguyên                | Cần kiểm tra lại trên hệ thống có tải lớn      |
| **C# 14 - `nameof` trong generic**                           | Bị giới hạn                          | Cho phép sử dụng `nameof` trong generic chưa giữ kết           | Linh hoạt hơn trong lập trình, dễ đọc code hơn                     | Chưa có tác động tiêu cực rõ rệt               |
| **Thuộc tính hỗ trợ bởi trường (`field` backed properties)** | Chưa hỗ trợ                          | Hỗ trợ cú pháp mới cho thuộc tính có trường hỗ trợ             | Giảm boilerplate code, dễ bảo trì                                  | Thay đổi cú pháp có thể gây nhầm lẫn ban đầu   |
| **ASP.NET Core - Blazor**                                    | Chưa hỗ trợ `RowClass` cho QuickGrid | Hỗ trợ `RowClass` và script Blazor như tài sản web tĩnh        | Cải thiện khả năng tùy chỉnh giao diện và quản lý script tốt hơn   | Chỉ hữu ích cho dự án Blazor                   |
| **OpenAPI**                                                  | Chỉ hỗ trợ OpenAPI 3.0               | Hỗ trợ OpenAPI 3.1 và YAML                                     | Cập nhật theo chuẩn mới nhất, hỗ trợ định dạng YAML                | Cần kiểm tra tương thích với các hệ thống cũ   |
| **.NET MAUI**                                                | Chưa tối ưu hoàn toàn                | Cải thiện chất lượng và hiệu năng                              | Ứng dụng đa nền tảng chạy mượt hơn, ít lỗi hơn                     | Cần thử nghiệm kỹ trước khi đưa vào sản phẩm   |
| **Entity Framework Core - LINQ & SQL translation**           | Chưa tối ưu                          | Dịch LINQ sang SQL hiệu quả hơn                                | Tối ưu truy vấn, cải thiện hiệu suất                               | Cần kiểm tra kỹ nếu có truy vấn phức tạp       |
| **ExecuteUpdateAsync**                                       | Chỉ chấp nhận biểu thức lambda       | Hỗ trợ lambda thường                                           | Giảm hạn chế khi cập nhật dữ liệu, code dễ viết hơn                | Có thể cần điều chỉnh nếu đang sử dụng cách cũ |

## Phân tích chi tiết một số thay đổi quan trọng

### 1. Hỗ trợ AVX10.2 trong Runtime

**Giải thích:** AVX10.2 là một tập lệnh SIMD mới giúp tối ưu hiệu suất xử lý vector trên các CPU hiện đại. Việc hỗ trợ AVX10.2 trong .NET 10 giúp cải thiện tốc độ thực thi các tác vụ liên quan đến tính toán hiệu năng cao. **Tài liệu tham khảo:** [AVX10.2 và tối ưu hiệu suất](https://devblogs.microsoft.com/dotnet/avx10-2/)

### 2. Cải tiến OpenAPI 3.1 và hỗ trợ YAML

**Giải thích:** OpenAPI 3.1 là phiên bản mới của tiêu chuẩn mô tả API REST, giúp cải thiện khả năng định nghĩa và xác thực API. Việc hỗ trợ YAML giúp việc quản lý cấu hình API dễ dàng hơn. **Tài liệu tham khảo:** OpenAPI 3.1 Overview

### 3. Entity Framework Core - LINQ Translation

**Giải thích:** Việc dịch LINQ sang SQL trong EF Core 10 được tối ưu giúp cải thiện hiệu suất truy vấn. Giảm thời gian phản hồi từ database và tối ưu hóa các câu lệnh SQL được tạo ra từ LINQ. **Tài liệu tham khảo:** [EF Core Query Translation](https://learn.microsoft.com/en-us/ef/core/querying/)

## Kết luận

.NET 10 mang lại nhiều nâng cấp đáng kể về hiệu suất, bổ sung tính năng và tăng tính linh hoạt cho các API. Tuy nhiên, một số thay đổi có thể yêu cầu cập nhật lại code hoặc kiểm tra tương thích với hệ thống hiện tại. Đối với các nhà phát triển, việc nâng cấp từ **.NET 9 lên .NET 10** sẽ giúp cải thiện hiệu suất và dễ dàng tích hợp các tính năng mới.

📢 Đừng quên xem thêm chi tiết trong [**blog chính thức**](https://devblogs.microsoft.com/dotnet/dotnet-10-preview-1/) và video cập nhật [**tại đây**](https://youtu.be/VncMk8ryxV8)!


# ASP.NET Core Web API với ASP.NET Core Web API (Native AOT): Bạn nên chọn loại nào?

Khi xây dựng các ứng dụng web API hiện đại với ASP.NET Core, hiệu suất và khả năng tối ưu hóa bộ nhớ là hai yếu tố được nhiều lập trình viên quan tâm.

Microsoft hiện cung cấp hai tùy chọn chính cho việc phát triển web API: **ASP.NET Core Web API** và **ASP.NET Core Web API (Native AOT)**.

Trong đó, **Native AOT (Ahead-Of-Time Compilation)** đang được xem là một cải tiến mới, giúp ứng dụng đạt hiệu suất cao hơn. Vậy sự khác biệt chính giữa hai phương pháp này là gì? Bài viết này sẽ giúp bạn hiểu rõ ưu nhược điểm của mỗi tùy chọn để từ đó đưa ra quyết định phù hợp nhất cho dự án của mình.

## So sánh chi tiết ASP.NET Core Web API và ASP.NET Core Web API (Native AOT)

* [**Hiệu suất và tốc độ khởi động**](#id-1.-kha-nang-toi-uu-hoa-hieu-suat): Nêu bật sự khác biệt trong cách biên dịch giữa JIT và AOT, cùng tác động đến tốc độ khởi động của ứng dụng.
* [**Kích thước và tài nguyên bộ nhớ**](#id-2.-kich-thuoc-ung-dung): Tập trung vào sự khác biệt về kích thước ứng dụng và mức sử dụng tài nguyên của hai phương pháp.
* [**Tính năng và khả năng tương thích**](#id-3.-tinh-tuong-thich-va-ho-tro-tinh-nang): Làm rõ các tính năng mà mỗi loại API hỗ trợ, đặc biệt với tính năng động và các thư viện của .NET.
* [**Ứng dụng thực tế và trường hợp sử dụng**](#id-4.-truong-hop-su-dung-phu-hop): Đưa ra những tình huống cụ thể để lập trình viên chọn đúng phiên bản theo yêu cầu hiệu suất và môi trường triển khai.

### **1. Khả năng tối ưu hóa hiệu suất**

Một trong những điểm khác biệt đáng chú ý nhất giữa **ASP.NET Core Web API** và **ASP.NET Core Web API (Native AOT)** là cách mà mã nguồn được biên dịch và thực thi.

* **ASP.NET Core Web API**: Đây là bản web API thông thường của .NET Core, hoạt động dựa trên .NET Runtime có sẵn. Mã nguồn được biên dịch qua **JIT (Just-In-Time Compilation)** khi ứng dụng chạy lần đầu, nghĩa là chỉ khi có yêu cầu từ người dùng, mã nguồn mới bắt đầu được biên dịch thành mã máy để thực thi. Dù cách làm này giúp ứng dụng linh hoạt và có thể xử lý nhiều thao tác phức tạp, nhưng lại làm chậm thời gian khởi động ban đầu vì phải thực hiện biên dịch ngay lúc chạy.
* **ASP.NET Core Web API (Native AOT)**: Native AOT sử dụng **biên dịch Ahead-Of-Time (AOT)**, biên dịch toàn bộ mã nguồn trước khi ứng dụng được khởi động. Do đó, thời gian khởi động nhanh hơn đáng kể, vì mã nguồn đã sẵn sàng được thực thi ngay mà không cần chờ biên dịch. Điều này giúp tối ưu hiệu suất, đặc biệt là trong các trường hợp yêu cầu thời gian phản hồi nhanh hoặc trong môi trường hạn chế về tài nguyên.

### **2. Kích thước ứng dụng**

Một yếu tố quan trọng khác là kích thước của ứng dụng, điều này ảnh hưởng đến tài nguyên hệ thống và hiệu suất tổng thể của API.

* **ASP.NET Core Web API**: Vì phải bao gồm .NET Runtime, nên kích thước ứng dụng lớn hơn. Tuy nhiên, kích thước tăng thêm này giúp ứng dụng linh hoạt hơn, hỗ trợ nhiều API của .NET mà Native AOT không có. Do đó, trong những dự án không giới hạn tài nguyên hoặc yêu cầu bộ nhớ quá cao, đây vẫn là một lựa chọn tốt.
* **ASP.NET Core Web API (Native AOT)**: Kích thước của ứng dụng Native AOT nhỏ hơn, do loại bỏ các thành phần không cần thiết và tối ưu hóa mã nguồn để chỉ bao gồm những gì ứng dụng cần. Điều này rất phù hợp khi bạn cần một ứng dụng gọn nhẹ, chẳng hạn như các dịch vụ microservice chạy trên các container nhỏ, IoT hoặc các thiết bị có giới hạn bộ nhớ.

### **3. Tính tương thích và hỗ trợ tính năng**

Tính tương thích với các tính năng động và thư viện .NET đầy đủ là một khía cạnh quan trọng cần xem xét khi lựa chọn giữa ASP.NET Core Web API và ASP.NET Core Web API (Native AOT).

* **ASP.NET Core Web API**: Do sử dụng .NET Runtime đầy đủ, bản thông thường của ASP.NET Core Web API có khả năng hỗ trợ các thư viện và tính năng động của .NET, bao gồm **reflection** và các API động khác. Nếu dự án của bạn cần dùng đến reflection hoặc các thư viện yêu cầu dynamic programming, bản Web API thông thường sẽ là lựa chọn hợp lý hơn.
* **ASP.NET Core Web API (Native AOT)**: Native AOT gặp một số hạn chế trong việc hỗ trợ các tính năng dynamic. Vì mã đã được biên dịch trước thành mã máy, nên không thể dễ dàng sử dụng các tính năng reflection hoặc dynamic API, vốn yêu cầu biên dịch và thực thi tại thời điểm chạy. Do đó, nếu bạn cần sử dụng các thư viện yêu cầu tính năng này, Native AOT sẽ không phải là lựa chọn tối ưu.

### **4. Trường hợp sử dụng phù hợp**

* **ASP.NET Core Web API**: Phù hợp với các ứng dụng cần sự linh hoạt, dễ bảo trì và không yêu cầu tối ưu hóa hiệu suất quá cao. Đây cũng là lựa chọn phổ biến cho các ứng dụng web API lớn với nhiều tính năng phức tạp hoặc các dự án có khả năng mở rộng cao.
* **ASP.NET Core Web API (Native AOT)**: Rất thích hợp cho các ứng dụng nhỏ gọn, cần khởi động nhanh, đặc biệt là các microservice trong hệ thống phân tán hoặc chạy trên các thiết bị hạn chế tài nguyên. Native AOT còn là lựa chọn lý tưởng cho các ứng dụng yêu cầu hiệu suất cao hoặc chạy trong môi trường đám mây, nơi tốc độ khởi động và sử dụng tài nguyên tối ưu là ưu tiên hàng đầu.

## **Bảng tóm tắt so sánh**

Dưới đây là bảng tóm tắt so sánh giữa **ASP.NET Core Web API** và **ASP.NET Core Web API (Native AOT)** để giúp bạn có cái nhìn tổng quan rõ ràng hơn:

| **Tiêu chí**              | **ASP.NET Core Web API**                     | **ASP.NET Core Web API (Native AOT)**                    |
| ------------------------- | -------------------------------------------- | -------------------------------------------------------- |
| **Hiệu suất**             | Tốt nhưng khởi động chậm hơn                 | Nhanh hơn nhờ biên dịch trước với Native AOT             |
| **Thời gian khởi động**   | Lâu hơn do phải biên dịch Just-In-Time (JIT) | Nhanh hơn đáng kể nhờ biên dịch Ahead-Of-Time (AOT)      |
| **Kích thước ứng dụng**   | Lớn hơn do cần thêm .NET Runtime             | Nhỏ gọn vì loại bỏ các thành phần không cần thiết        |
| **Hỗ trợ tính năng động** | Đầy đủ (reflection và dynamic API)           | Hạn chế (không hỗ trợ reflection và một số API động)     |
| **Trường hợp sử dụng**    | Ứng dụng linh hoạt, không cần tối ưu quá cao | Ứng dụng nhỏ gọn, khởi động nhanh, hạn chế về tài nguyên |
| **Khả năng tương thích**  | Hỗ trợ đầy đủ thư viện và tính năng của .NET | Giới hạn trong một số thư viện, không hỗ trợ đầy đủ .NET |

## **Kết luận**

ASP.NET Core Web API và ASP.NET Core Web API (Native AOT) đều có những ưu điểm và hạn chế riêng, và việc chọn lựa phụ thuộc nhiều vào yêu cầu cụ thể của dự án. Nếu bạn cần một ứng dụng linh hoạt, có khả năng mở rộng, hỗ trợ tốt các tính năng động của .NET, thì **ASP.NET Core Web API** là lựa chọn tốt. Trong khi đó, nếu bạn muốn tối ưu hóa kích thước ứng dụng và thời gian khởi động cho các môi trường hạn chế, **ASP.NET Core Web API (Native AOT)** sẽ là lựa chọn sáng giá. Mong rằng bài viết này đã giúp bạn hiểu rõ hơn về các lựa chọn này và có thể đưa ra quyết định phù hợp cho dự án của mình.


# Hướng dẫn xây dựng ứng dụng multi-tenant với .NET Core và MongoDB

## **1. Tổng quan về multi-tenancy**

Multi-tenancy là kiến trúc trong đó một ứng dụng duy nhất phục vụ nhiều khách hàng (tenants), mỗi tenant có dữ liệu và cấu hình độc lập. Trong trường hợp sử dụng MongoDB, có thể cấu hình để mỗi tenant sử dụng một cơ sở dữ liệu riêng biệt.

## **2. Các thách thức**

* **Quản lý kết nối:** Xử lý việc kết nối đến các cơ sở dữ liệu khác nhau dựa trên tenant hiện tại.
* **Tách biệt dữ liệu:** Đảm bảo dữ liệu của các tenants được lưu trữ và truy xuất chính xác.
* **Hiệu suất và bảo mật:** Hạn chế việc rò rỉ dữ liệu giữa các tenants và tối ưu hóa tài nguyên.

## **3. Tạo MongoDB Context Factory**

Để xây dựng ứng dụng multi-tenant với MongoDB, bạn có thể triển khai một MongoDB Context Factory để tạo kết nối cho từng tenant.

### **Bước triển khai MongoDB Context Factory**

**B1. Cài đặt các gói NuGet:**

```bash
dotnet add package MongoDB.Driver
```

**B2. Định nghĩa `TenantConfiguration`** Mỗi tenant sẽ có cấu hình riêng, bao gồm connection string và database name.

```csharp
public class TenantConfiguration
{
    public string TenantId { get; set; }
    public string ConnectionString { get; set; }
    public string DatabaseName { get; set; }
}
```

**B3. Quản lý danh sách tenants** Bạn có thể lưu danh sách cấu hình tenants trong tệp cấu hình (appsettings.json) hoặc cơ sở dữ liệu.

Ví dụ:

```json
"Tenants": [
    {
        "TenantId": "tenant1",
        "ConnectionString": "mongodb://localhost:27017",
        "DatabaseName": "tenant1_db"
    },
    {
        "TenantId": "tenant2",
        "ConnectionString": "mongodb://localhost:27017",
        "DatabaseName": "tenant2_db"
    }
]
```

**B4. Tạo MongoDB Context**

```csharp
public class MongoDbContext
{
    private readonly IMongoDatabase _database;

    public MongoDbContext(string connectionString, string databaseName)
    {
        var client = new MongoClient(connectionString);
        _database = client.GetDatabase(databaseName);
    }

    public IMongoCollection<T> GetCollection<T>(string collectionName)
    {
        return _database.GetCollection<T>(collectionName);
    }
}
```

**B5. Triển khai MongoDbContextFactory**

```csharp
public class MongoDbContextFactory
{
    private readonly IEnumerable<TenantConfiguration> _tenantConfigurations;

    public MongoDbContextFactory(IConfiguration configuration)
    {
        _tenantConfigurations = configuration.GetSection("Tenants").Get<List<TenantConfiguration>>();
    }

    public MongoDbContext CreateContext(string tenantId)
    {
        var tenantConfig = _tenantConfigurations.FirstOrDefault(t => t.TenantId == tenantId);
        if (tenantConfig == null)
        {
            throw new Exception($"Tenant with ID {tenantId} not found.");
        }

        return new MongoDbContext(tenantConfig.ConnectionString, tenantConfig.DatabaseName);
    }
}
```

**B6. Middleware để xác định tenant hiện tại** Middleware giúp xác định tenant từ yêu cầu HTTP (ví dụ: từ header hoặc subdomain).

```csharp
public class TenantMiddleware
{
    private readonly RequestDelegate _next;

    public TenantMiddleware(RequestDelegate next)
    {
        _next = next;
    }

    public async Task InvokeAsync(HttpContext context)
    {
        if (context.Request.Headers.TryGetValue("X-Tenant-ID", out var tenantId))
        {
            context.Items["TenantId"] = tenantId.ToString();
        }

        await _next(context);
    }
}
```

**B7. Đăng ký dịch vụ và Middleware** Trong `Startup.cs` hoặc `Program.cs`:

```csharp
public void ConfigureServices(IServiceCollection services)
{
    services.AddSingleton<MongoDbContextFactory>();
    services.AddScoped(provider =>
    {
        var httpContext = provider.GetRequiredService<IHttpContextAccessor>().HttpContext;
        var tenantId = httpContext.Items["TenantId"]?.ToString();
        var factory = provider.GetRequiredService<MongoDbContextFactory>();
        return factory.CreateContext(tenantId);
    });

    services.AddHttpContextAccessor();
}

public void Configure(IApplicationBuilder app)
{
    app.UseMiddleware<TenantMiddleware>();
}
```

## **4. Sử dụng trong Controller**

Bạn có thể inject `MongoDbContext` để thao tác với cơ sở dữ liệu tương ứng.

```csharp
[ApiController]
[Route("api/[controller]")]
public class SampleController : ControllerBase
{
    private readonly MongoDbContext _dbContext;

    public SampleController(MongoDbContext dbContext)
    {
        _dbContext = dbContext;
    }

    [HttpGet("data")]
    public IActionResult GetData()
    {
        var collection = _dbContext.GetCollection<MyEntity>("MyCollection");
        var data = collection.Find(FilterDefinition<MyEntity>.Empty).ToList();
        return Ok(data);
    }
}
```

## **5. Kết luận**

Triển khai multi-tenancy với .NET Core và MongoDB không quá phức tạp khi sử dụng một kiến trúc hợp lý. Với MongoDB Context Factory và Middleware, bạn có thể dễ dàng quản lý các kết nối đến cơ sở dữ liệu riêng của từng tenant. Cách tiếp cận này đảm bảo tính mở rộng và tách biệt dữ liệu cho ứng dụng.


# Visual Studio 2022 v17.14 (Cập nhật tháng 10/2025) – Kích hoạt Copilot Memories để AI “ghi nhớ”

<figure><img src="https://raw.githubusercontent.com/nqdev-storage/s3-001/refs/heads/main/gitbook/blogs/cong-nghe/visual-studio-2022-v17.14-copilot-memories.png" alt=""><figcaption><p>Copilot Memories</p></figcaption></figure>

### 🌟 Giới thiệu

[GitHub Copilot](broken://spaces/wRgsH8wC380GwDCPj7gi/pages/fUK0s5t9IQkASJfoNuDZ) đã trở thành “người bạn đồng hành” quen thuộc với lập trình viên – giúp viết code nhanh hơn, ít lỗi hơn.\
Nhưng trong bản **Visual Studio 2022 v17.14 (tháng 10/2025)**, Copilot đã tiến thêm một bước rất lớn: **nó bắt đầu có trí nhớ.**

Tính năng mới có tên **Copilot Memories**, cho phép AI hiểu và ghi nhớ **cách bạn – hoặc cả nhóm của bạn – làm việc**.\
Điều đó nghĩa là:

* Nếu bạn thường xuyên chỉnh sửa cách Copilot gợi ý, nó sẽ “học” và nhớ.
* Nếu bạn bảo “hãy nhớ dùng `PascalCase` cho class”, nó sẽ ghi nhận và áp dụng.
* Nếu nhóm bạn có quy tắc riêng về cấu trúc thư mục, cách đặt tên, format code… Copilot có thể **ghi nhớ, tái sử dụng và chia sẻ lại cho cả team**.

***

### ⚙️ Copilot Memories hoạt động như thế nào?

Khi bạn sử dụng Copilot Chat, hệ thống sẽ lắng nghe và ghi nhận **những tín hiệu thể hiện quy chuẩn làm việc của bạn**:

* Khi bạn **chỉnh lại đoạn code mà Copilot đề xuất** → AI hiểu bạn có quy tắc riêng.
* Khi bạn **nhắc Copilot nhớ điều gì đó** → nó hiển thị thông báo “Save this preference?” để bạn xác nhận.
* Khi bạn xác nhận, Copilot sẽ lưu “trí nhớ” đó vào **3 loại tệp cấu hình quen thuộc**:

| Loại tệp          | Chức năng                                                         | Ví dụ nội dung                                                            |
| ----------------- | ----------------------------------------------------------------- | ------------------------------------------------------------------------- |
| `.editorconfig`   | Lưu quy tắc định dạng code, đặt tên biến, dấu cách, dòng trống... | “Luôn dùng tab = 4 spaces, đặt tên class dạng PascalCase”                 |
| `CONTRIBUTING.md` | Ghi lại quy trình làm việc, chuẩn commit, review, guideline nhóm  | “Khi thêm tính năng mới, tạo branch `feature/...` và viết test kèm theo.” |
| `README.md`       | Cung cấp thông tin tổng quan, mô tả dự án                         | “Dự án quản lý khách hàng nội bộ, dùng ASP.NET Core + SQL Server.”        |

Nhờ vậy, Copilot không chỉ hỗ trợ bạn trong một file code, mà **tuân thủ nhất quán toàn bộ văn hóa kỹ thuật của team**.

***

### 🔧 Hướng dẫn bật tính năng Copilot Memories trong Visual Studio

Thao tác rất đơn giản – chỉ vài bước là xong:

#### **Bước 1: Mở Visual Studio 2022**

Chọn menu:\
`Tools → Options → GitHub → Copilot → Copilot Chat`

#### **Bước 2: Bật tùy chọn ghi nhớ**

Tích chọn dòng:

> ✅ *Enable custom instructions to be loaded from .github/instructions/*.instructions.md files and added to requests.\*

Tính năng này cho phép Copilot đọc các tệp hướng dẫn bạn viết trong dự án.

#### **Bước 3: Tạo thư mục chứa hướng dẫn**

Trong thư mục gốc của project, tạo đường dẫn:

```
.github/instructions/
```

***

### 📝 Bước 4: Viết file hướng dẫn đầu tiên (.instructions.md)

Dưới đây là ví dụ file thực tế mà bạn có thể copy – dán và chỉnh sửa theo dự án của mình.

#### 🔹 **File: `.github/instructions/csharp-guidelines.instructions.md`**

```markdown
applyTo: **/*.cs

---
# Quy tắc C# nội bộ của nhóm NQDEV

## 1. Cấu trúc và định dạng
- Luôn dùng 4 khoảng trắng cho mỗi tab.
- Mỗi class, interface, enum phải nằm trong file riêng.
- Không sử dụng `var` nếu kiểu dữ liệu không rõ ràng.

## 2. Đặt tên
- Class, Interface: PascalCase.
- Biến, thuộc tính: camelCase.
- Hằng số: SNAKE_UPPERCASE.
- File phải cùng tên với class chính trong đó.

## 3. Bình luận & tài liệu
- Thêm XML comment (`///`) cho public method.
- Viết mô tả ngắn gọn, nêu rõ mục đích hàm.

## 4. Thực hành tốt
- Khi tạo API mới, viết unit test kèm theo.
- Không push code lên `main` trực tiếp – chỉ thông qua pull request.

## 5. Tham chiếu
- Xem thêm quy tắc chi tiết trong file `CONTRIBUTING.md`.
```

> 💡 **Giải thích nhanh:**
>
> * `applyTo: **/*.cs` nghĩa là file này áp dụng cho **mọi file C#** trong dự án.
> * Copilot sẽ **đọc và tuân theo các quy tắc trong file này khi gợi ý code**.
> * Bạn có thể tạo thêm nhiều file khác, ví dụ:
>   * `api-guidelines.instructions.md`
>   * `frontend-style.instructions.md`

***

### 🧩 Bước 5: Dùng Copilot Chat để “dạy” AI hiểu hướng dẫn

Sau khi tạo file xong, mở cửa sổ **Copilot Chat** và gõ lệnh:

```
@copilot read .github/instructions/csharp-guidelines.instructions.md
```

Hoặc đơn giản hơn, chỉ cần bắt đầu chat với Copilot như bình thường:

> “Hãy dùng chuẩn đặt tên trong hướng dẫn nội bộ nhé.”

Copilot sẽ tự động nhận diện file `.instructions.md` và **áp dụng quy tắc khi gợi ý code**.

***

### 🚀 Kết luận

Với **Copilot Memories**, GitHub Copilot không còn chỉ là AI viết code, mà trở thành **trợ lý lập trình có trí nhớ**, hiểu rõ từng quy tắc và thói quen của đội ngũ.

Bạn chỉ cần thiết lập một lần – sau đó, mọi thành viên trong dự án đều nhận được cùng trải nghiệm thống nhất, đồng bộ và chuyên nghiệp.

👉 **Hãy thử ngay hôm nay trên Visual Studio 2022 v17.14** để biến Copilot thành “đồng đội” thực thụ – biết cách bạn muốn code, và giúp bạn duy trì chất lượng dự án ở mức cao nhất.


# NodeJS

Node.js® là môi trường thời gian chạy JavaScript đa nền tảng, mã nguồn mở, miễn phí, cho phép các nhà phát triển tạo máy chủ, ứng dụng web, công cụ dòng lệnh và tập lệnh.


# NextJS


# Hướng dẫn NextJS cho người mới bắt đầu

Next.js là một framework mạnh mẽ dựa trên React, giúp bạn xây dựng các ứng dụng web hiện đại với khả năng tối ưu hóa SEO, hiệu năng cao và các tính năng tích hợp sẵn như Server-Side Rendering (SSR), Static Site Generation (SSG), và API Routes.

Bài viết này sẽ hướng dẫn bạn các bước cơ bản để bắt đầu với Next.js.

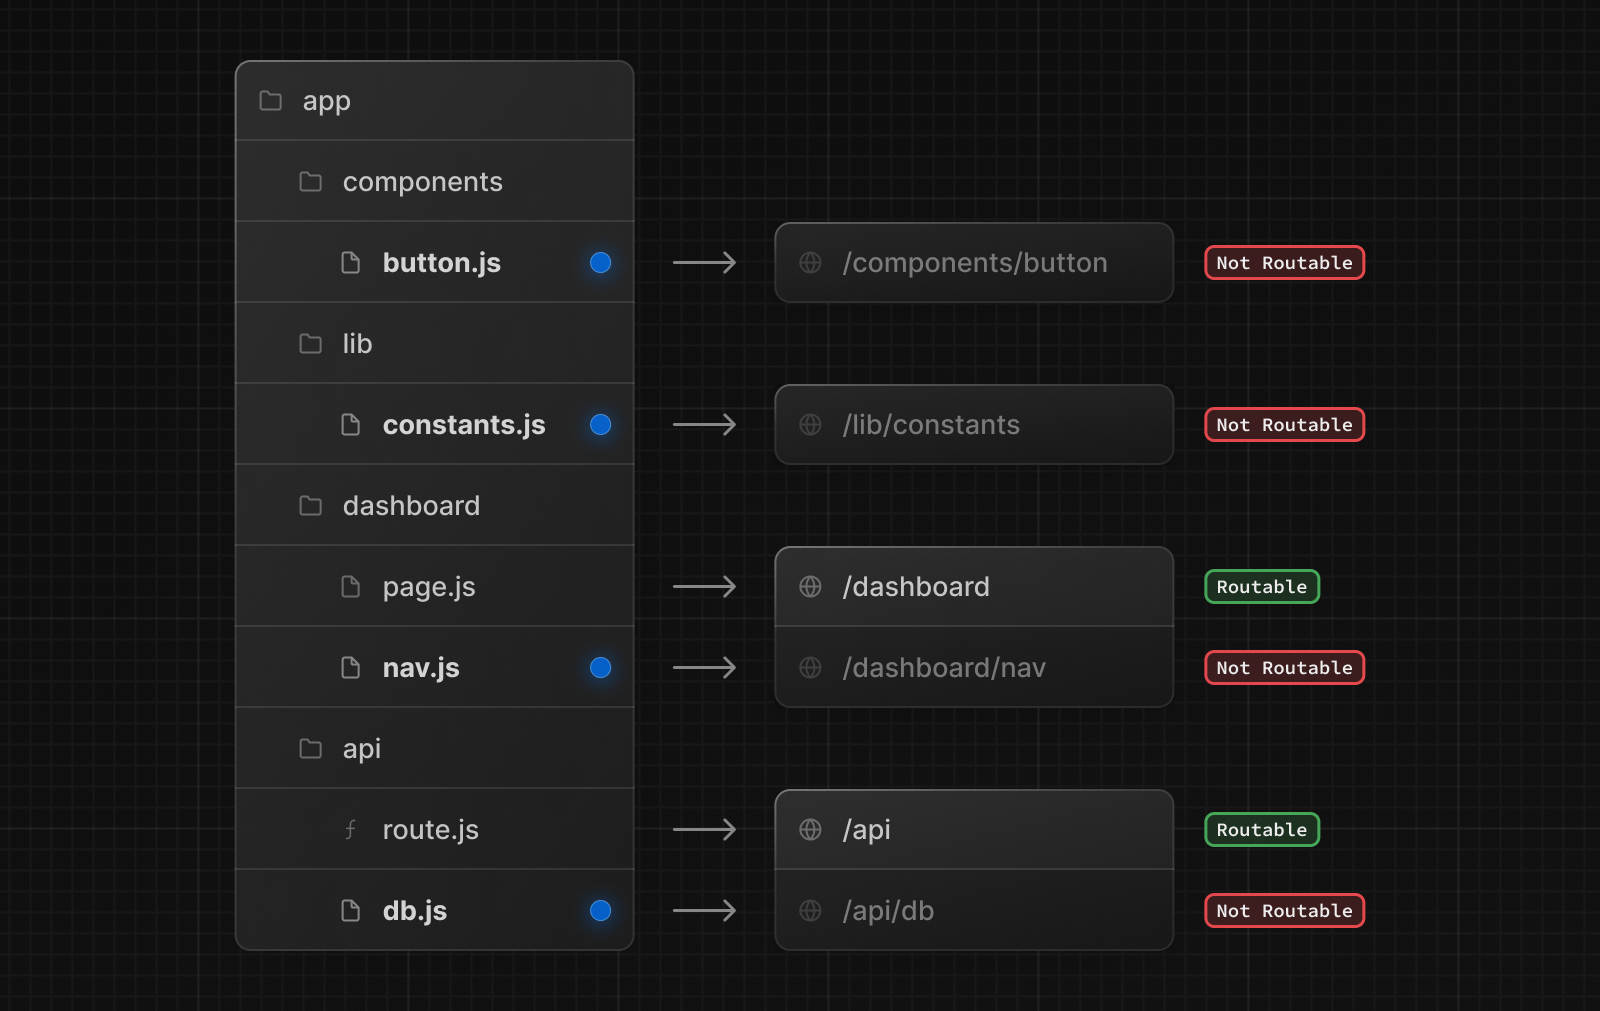
<figure><img src="https://nextjs.org/_next/image?url=%2Fdocs%2Fdark%2Fproject-organization-colocation.png&#x26;w=3840&#x26;q=75" alt=""><figcaption></figcaption></figure>

***

## **1. Cài Đặt Môi Trường**

### **Yêu cầu:**

* **Node.js**: Tải về và cài đặt từ [Node.js](https://nodejs.org/).
* **npm** hoặc **yarn**: Được cài đặt sẵn khi bạn cài Node.js.

{% hint style="success" %}
{% code overflow="wrap" lineNumbers="true" %}

```markdown
- [Node.js®](https://nodejs.org/en)
- [How to set up a Next.js project](https://nextjs.org/docs/app/getting-started/installation)
```

{% endcode %}
{% endhint %}

### **Khởi tạo dự án Next.js:**

Sử dụng lệnh sau để tạo một dự án Next.js mới:

```bash
npx create-next-app@latest my-nextjs-app
```

Lựa chọn các cấu hình theo ý thích (TypeScript, ESLint, Tailwind CSS, v.v.).

Di chuyển vào thư mục dự án:

```bash
cd my-nextjs-app
```

### Chạy ứng dụng:

```bash
npm run dev
```

Truy cập ứng dụng tại <http://localhost:3000>.

***

## **2. Cấu Trúc Thư Mục Next.js**

Khi bạn tạo một dự án Next.js, cấu trúc thư mục cơ bản sẽ như sau:

```bash
my-nextjs-app/
├── pages/          # Chứa các file định nghĩa route
├── public/         # Chứa các tài nguyên tĩnh (hình ảnh, favicon, ...)
├── styles/         # Chứa các file CSS
├── package.json    # File cấu hình dự án
├── next.config.js  # File cấu hình Next.js
```

### **Thư mục quan trọng:**

* **`pages`**: Mỗi file trong thư mục này sẽ tự động trở thành một route.
* **`public`**: Các tài nguyên tĩnh trong thư mục này có thể truy cập qua URL.
* **`styles`**: Chứa các file CSS để định dạng giao diện.

***

## **3. Tạo Trang Đầu Tiên**

### **Tạo một trang đơn giản:**

Tạo file `about.js` trong thư mục `pages`:

```javascript
// pages/about.js
export default function AboutPage() {
  return (
    <div>
      <h1>Giới Thiệu</h1>
      <p>Đây là trang giới thiệu cơ bản.</p>
    </div>
  );
}
```

Truy cập <http://localhost:3000/about> để xem trang.

### **Trang chính (`index.js`):**

File `index.js` trong thư mục `pages` là trang mặc định (home page):

```javascript
// pages/index.js
export default function HomePage() {
  return (
    <div>
      <h1>Chào mừng đến với Next.js</h1>
      <p>Bạn đã bắt đầu với Next.js thành công!</p>
    </div>
  );
}
```

***

## **4. Styles với CSS**

### **Thêm CSS toàn cục:**

Trong file `styles/globals.css`, bạn có thể định nghĩa CSS áp dụng cho toàn bộ ứng dụng:

```css
/* styles/globals.css */
body {
  font-family: Arial, sans-serif;
  margin: 0;
  padding: 0;
}
```

Đừng quên nhập file này trong `_app.js`:

```javascript
// pages/_app.js
import '../styles/globals.css';

export default function MyApp({ Component, pageProps }) {
  return <Component {...pageProps} />;
}
```

### **CSS module:**

Next.js hỗ trợ CSS module để quản lý CSS cục bộ:

```javascript
// components/Button.module.css
.button {
  background-color: blue;
  color: white;
  padding: 10px 20px;
  border: none;
  cursor: pointer;
}
```

### Sử dụng trong component:

```javascript
// components/Button.js
import styles from './Button.module.css';

export default function Button() {
  return <button className={styles.button}>Nhấn vào đây</button>;
}
```

***

## **5. API Routes**

Next.js hỗ trợ xây dựng API dễ dàng. Tạo file `hello.js` trong thư mục `pages/api`:

```javascript
// pages/api/hello.js
export default function handler(req, res) {
  res.status(200).json({ message: 'Xin chào từ API của Next.js!' });
}
```

Truy cập <http://localhost:3000/api/hello> để xem API phản hồi.

***

## **6. Data Fetching**

Next.js hỗ trợ nhiều phương thức để lấy dữ liệu:

### **Server-Side Rendering (SSR):**

Lấy dữ liệu trên server trước khi render trang:

```javascript
// pages/ssr.js
export async function getServerSideProps() {
  return {
    props: {
      message: 'Dữ liệu từ SSR',
    },
  };
}

export default function SSRPage({ message }) {
  return <div>{message}</div>;
}
```

### **Static Site Generation (SSG):**

Lấy dữ liệu tại thời điểm build:

```javascript
// pages/ssg.js
export async function getStaticProps() {
  return {
    props: {
      message: 'Dữ liệu từ SSG',
    },
  };
}

export default function SSGPage({ message }) {
  return <div>{message}</div>;
}
```

***

## **7. Triển Khai Ứng Dụng**

Triển khai ứng dụng Next.js rất dễ dàng với [Vercel](https://vercel.com/), nền tảng được thiết kế để tối ưu hóa cho Next.js.

### **Các bước triển khai:**

1. Đăng ký tài khoản trên Vercel.
2. Kết nối dự án với GitHub/GitLab/Bitbucket.
3. Chọn repository và cấu hình Next.js.
4. Nhấn "Deploy" để hoàn tất.

***

## **Kết Luận**

Next.js là một framework mạnh mẽ và dễ sử dụng, phù hợp cho cả người mới bắt đầu lẫn các dự án lớn. Với các tính năng hiện đại như SSR, SSG, và API Routes, bạn có thể xây dựng các ứng dụng web tối ưu, hiệu quả và dễ bảo trì.

Hãy thử ngay hôm nay và tận hưởng trải nghiệm lập trình với Next.js!


# Parallel Routes trong Next.js

Parallel Routes là một tính năng mạnh mẽ trong Next.js App Router, cho phép bạn định nghĩa và hiển thị nhiều route song song trong một ứng dụng.

Tính năng này đặc biệt hữu ích khi bạn cần hiển thị nhiều nội dung hoặc giao diện trong cùng một cấp độ của giao diện người dùng, chẳng hạn như sidebar và nội dung chính.

{% code title="Tài liệu tham khảo:" overflow="wrap" lineNumbers="true" %}

```http
- https://nextjs.org/docs/app/building-your-application/routing/parallel-routes
```

{% endcode %}

<figure><img src="https://nextjs.org/_next/image?url=%2Fdocs%2Fdark%2Fparallel-routes.png&#x26;w=3840&#x26;q=75" alt=""><figcaption><p>parallel-routes</p></figcaption></figure>

***

## **Khái niệm chính**

Khi sử dụng **Parallel Routes**, bạn có thể định nghĩa các route song song bằng cách sử dụng cấu trúc thư mục và cách định danh trong Next.js. Điều này giúp bạn linh hoạt hơn trong việc tổ chức giao diện và quản lý trạng thái của các phần khác nhau trong ứng dụng.

Ví dụ: Một ứng dụng blog có thể sử dụng **Parallel Routes** để hiển thị:

* Một sidebar chứa danh sách bài viết.
* Một phần chính hiển thị nội dung bài viết chi tiết.

***

## **Cách hoạt động của Parallel Routes**

**Parallel Routes** dựa trên việc cấu hình các route song song thông qua việc sử dụng các tệp đặc biệt trong App Router của Next.js:

### **Thư mục định danh**

* Bạn sử dụng các thư mục có định danh để định nghĩa các route song song.
* Các thư mục này được đặt trong cấu trúc thư mục của **App Router** và được định nghĩa trong file layout hoặc page.

Ví dụ:

```bash
app/
  layout.js
  @sidebar/
    layout.js
    page.js
  @main/
    page.js
```

Trong cấu trúc trên:

* `@sidebar` đại diện cho khu vực sidebar.
* `@main` đại diện cho khu vực nội dung chính.

***

## **Triển khai Parallel Routes**

### **1. Cấu trúc thư mục**

Tạo các thư mục đại diện cho các khu vực giao diện mà bạn muốn render song song. Trong mỗi thư mục, bạn có thể sử dụng các file `layout.js`, `page.js`, hoặc `loading.js` để quản lý route.

### **2. Sử dụng layout để quản lý Parallel Routes**

Trong file `layout.js`, bạn có thể định nghĩa cách các route song song được hiển thị.

Ví dụ:

```jsx
// app/layout.js
export default function RootLayout({ children }) {
  return (
    <html>
      <body>
        <div style={{ display: 'flex' }}>
          {children}
        </div>
      </body>
    </html>
  );
}
```

### **3. Kết hợp các khu vực song song**

Kết hợp các route song song bằng cách sử dụng `children` và props.

Ví dụ:

```jsx
// app/@sidebar/layout.js
export default function SidebarLayout({ children }) {
  return <aside>{children}</aside>;
}

// app/@sidebar/page.js
export default function Sidebar() {
  return <div>Danh sách bài viết</div>;
}

// app/@main/page.js
export default function MainContent() {
  return <div>Nội dung bài viết</div>;
}
```

Kết quả là giao diện sẽ hiển thị cả hai phần **Sidebar** và **Main Content** song song.

***

## **Lợi ích của Parallel Routes**

1. **Tăng tính linh hoạt**: Giúp bạn tổ chức và quản lý giao diện theo cách dễ dàng và rõ ràng hơn.
2. **Tối ưu hiệu năng**: Cho phép tải các phần của giao diện độc lập, giảm thời gian tải và cải thiện trải nghiệm người dùng.
3. **Hỗ trợ cấu trúc phức tạp**: Parallel Routes đặc biệt hữu ích khi bạn làm việc với giao diện có nhiều khu vực động, như ứng dụng quản lý, bảng điều khiển, hay blog.

***

## **Khi nào nên sử dụng Parallel Routes?**

* Khi giao diện của bạn cần hiển thị nhiều khu vực độc lập.
* Khi bạn cần quản lý trạng thái và logic của từng phần riêng biệt.
* Khi muốn tăng tốc độ tải trang bằng cách chia nhỏ giao diện thành các thành phần có thể tải riêng lẻ.

***

## **Kết luận**

**Parallel Routes** là một tính năng mạnh mẽ trong Next.js App Router, giúp bạn dễ dàng xây dựng các giao diện phức tạp, hiện đại và tối ưu hiệu năng. Với cách triển khai linh hoạt và khả năng mở rộng, Parallel Routes là một công cụ không thể thiếu cho các nhà phát triển Next.js.

Hãy tận dụng **Parallel Routes** để xây dựng ứng dụng web chuyên nghiệp, nhanh chóng và hiệu quả hơn!


# Hướng dẫn cấu hình Swagger trong NextJS

Swagger là một công cụ mạnh mẽ giúp tự động tạo tài liệu API và cung cấp giao diện thử nghiệm API một cách trực quan. Trong bài viết này, chúng ta sẽ tìm hiểu cách cấu hình Swagger trong Next.js để hiển thị tài liệu API cho ứng dụng của bạn.

### 1. Mục tiêu

* **Cấu hình Swagger cho API**: Tạo tài liệu API từ các route API trong ứng dụng Next.js.
* **Hiển thị Swagger UI**: Sử dụng Swagger UI để hiển thị tài liệu API dưới dạng giao diện người dùng.
* **Cấu hình linh hoạt**: Cho phép loại bỏ layout mặc định cho trang Swagger riêng biệt.

### 2. Cài đặt các thư viện cần thiết

Trước tiên, chúng ta cần cài đặt các thư viện hỗ trợ Swagger:

```bash
npm install swagger-jsdoc swagger-ui-dist
npm install @types/swagger-jsdoc @types/swagger-ui-dist --save-dev
```

* **swagger-jsdoc**: Tự động tạo tài liệu Swagger từ mã nguồn API.
* **swagger-ui-dist**: Hiển thị giao diện Swagger UI trong ứng dụng.

### 3. Tạo API Route để trả về Swagger JSON

Chúng ta cần tạo một API route để trả về tài liệu Swagger dưới dạng JSON, giúp Swagger UI hiển thị thông tin về các endpoint API.

#### Tạo file **pages/api/swagger.ts**:

```javascript
import { NextApiRequest, NextApiResponse } from 'next';
import swaggerJSDoc from 'swagger-jsdoc';

const swaggerDefinition = {
  openapi: '3.0.0',
  info: {
    title: 'My API',
    version: '1.0.0',
    description: 'API documentation for My App',
  },
  servers: [
    { url: 'http://localhost:3000' },
  ],
};

const options = {
  swaggerDefinition,
  apis: ['./pages/api/**/*.ts'],
};

const swaggerSpec = swaggerJSDoc(options);

export default function handler(req: NextApiRequest, res: NextApiResponse) {
  if (req.method === 'GET') {
    res.status(200).json(swaggerSpec);
  } else {
    res.status(405).json({ message: 'Method Not Allowed' });
  }
}
```

### 4. Tạo trang Swagger UI để hiển thị tài liệu API

Tiếp theo, chúng ta tạo một trang riêng biệt để hiển thị Swagger UI.

#### Tạo file **pages/swagger.tsx**:

```javascript
'use client';
import { useEffect } from 'react';
import SwaggerUI from 'swagger-ui-dist/swagger-ui-bundle';
import 'swagger-ui-dist/swagger-ui.css';

export const metadata = {
  title: 'Swagger UI - My API',
  description: 'API documentation for My App',
};

export default function SwaggerPage() {
  useEffect(() => {
    SwaggerUI({
      dom_id: '#swagger-ui',
      url: '/api/swagger',
      deepLinking: true,
      presets: [SwaggerUI.presets.apis],
    });
  }, []);

  return (
    <div>
      <h1>Swagger API Documentation</h1>
      <div id="swagger-ui"></div>
    </div>
  );
}
```

### 5. Tắt Layout cho trang Swagger

Để tránh layout mặc định ảnh hưởng đến Swagger UI, bạn có thể điều chỉnh trong **app/layout.tsx**:

```javascript
import { ReactNode } from 'react';
import { usePathname } from 'next/navigation';

export default function Layout({ children }: { children: ReactNode }) {
  const pathname = usePathname();
  if (pathname === '/swagger') {
    return <>{children}</>;
  }
  return (
    <html lang="en">
      <body>
        <header>
          <h1>My App Header</h1>
        </header>
        <main>{children}</main>
        <footer>Footer Content</footer>
      </body>
    </html>
  );
}
```

### 6. Thêm các Comment JSDoc vào API Route

Swagger sử dụng JSDoc để tự động tạo tài liệu API. Hãy thêm comment vào các API route của bạn như sau:

```javascript
import { NextApiRequest, NextApiResponse } from 'next';

/**
 * @openapi
 * /api/users:
 *   get:
 *     description: Returns a list of users
 *     responses:
 *       200:
 *         description: A list of users
 *         content:
 *           application/json:
 *             schema:
 *               type: array
 *               items:
 *                 type: object
 *                 properties:
 *                   id:
 *                     type: integer
 *                   name:
 *                     type: string
 */
export default function handler(req: NextApiRequest, res: NextApiResponse) {
  const users = [
    { id: 1, name: 'John Doe' },
    { id: 2, name: 'Jane Doe' },
  ];
  res.status(200).json(users);
}
```

### 7. Truy cập Swagger UI

Sau khi hoàn thành các bước trên, bạn có thể truy cập tài liệu API tại địa chỉ:

```http
http://localhost:3000/swagger
```

### 8. Tóm tắt

| Bước                             | Nội dung                                     |
| -------------------------------- | -------------------------------------------- |
| **Cài đặt thư viện**             | Cài đặt `swagger-jsdoc` và `swagger-ui-dist` |
| **Tạo API Route**                | Trả về tài liệu Swagger JSON                 |
| **Tạo trang Swagger UI**         | Hiển thị tài liệu API với Swagger UI         |
| **Tắt layout cho trang Swagger** | Đảm bảo Swagger UI hiển thị độc lập          |
| **Thêm Comment JSDoc**           | Giúp Swagger tự động tạo tài liệu API        |

Với các bước trên, bạn đã có một hệ thống Swagger UI hoàn chỉnh trong Next.js để tài liệu hóa và thử nghiệm API của mình một cách dễ dàng. Chúc bạn thành công!


# ReactJS

React là một thư viện JavaScript front-end mã nguồn mở và miễn phí để xây dựng giao diện người dùng dựa trên các thành phần UI riêng lẻ.


# Hiểu về hook useRef của React như thế nào cho đúng

Bài viết được sự cho phép của tác giả Lưu Bình An

Câu nói chào hàng của `useState` vẫn thường được nghe: thêm state vào trong function component.

```jsx
const [value, setValue] = React.useState("init value");
```

Giả dụ tình huống là thế này, bạn làm gì đó mà nó ko liên quan đến UI, **không cần re-render**, nhưng vẫn muốn giá trị này cố định giữa các lần render? `useState` có thể cố định giá trị, nhưng ngặt nỗi nó sẽ trigger re-render nếu bị thay đổi

```js
function usePersistentValue(initValue) {
  return React.useState({
    current: initialValue,
  })[0];
}
```

Vì chúng ta không muốn trigger re-render, nên chỉ trả về giá trị của state (phần tử đầu tiên trong mảng), không trả về hàm để cập nhập nó.

Vẫn còn chưa rõ ràng lắm nhỉ, thí dụ trong trong ứng dụng chúng ta muốn có một giá trị counter tăng lên 1 từng giây, một button đế stop việc đó.

```jsx
function Counter() {
  const [count, setCount] = React.useState(0);

  let id;

  const clear = () => {
    window.clearInterval(id);
  };

  React.useEffect(() => {
    id = window.setInterval(() => {
      setCount((c) => c + 1);
    }, 1000);

    return clear;
  }, []);

  return (
    <div>
      <h1>{count}</h1>
      <button onClick={clear}>Stop</button>
    </div>
  );
}
```

Code này chạy không? *Không*, lý do? bạn có để ý biến `id` giữa các lần chạy (render) là khác nhau, nói cách khác bạn không clear được cái interval đã setup.

Bạn sẽ phải viết lại sử dụng cách `usePersistentValue` ở trên

```jsx
function usePersistentValue(initialValue) {
  return React.useState({
    current: initialValue,
  })[0];
}

function Counter() {
  const [count, setCount] = React.useState(0);
  const id = usePersistentValue(null);

  const clearInterval = () => {
    window.clearInterval(id.current);
  };

  React.useEffect(() => {
    id.current = window.setInterval(() => {
      setCount((c) => c + 1);
    }, 1000);

    return clearInterval;
  }, []);

  return (
    <div>
      <h1>{count}</h1>
      <button onClick={clearInterval}>Stop</button>
    </div>
  );
}
```

Nói có cảm giác hơi *sai trái* khi hack như vậy, nhưng nó chạy được.

Tuy nhiên không khuyến khích bạn tự viết như vậy, vì việc cố định giá trị giữa các lần render là nhu cầu khá *bình thường* nên bạn sẽ được team React làm sẵn cho một API mà xài: **useRef**

Vẫn là đoạn ứng dụng trên nhưng giờ chúng ta viết lại nó bằng `useRef`

```jsx
function Counter() {
  const [count, setCount] = React.useState(0);
  const id = React.useRef(null);

  const clearInterval = () => {
    window.clearInterval(id.current);
  };

  React.useEffect(() => {
    id.current = window.setInterval(() => {
      setCount((c) => c + 1);
    }, 1000);

    return clearInterval;
  }, []);

  return (
    <div>
      <h1>{count}</h1>
      <button onClick={clearInterval}>Stop</button>
    </div>
  );
}
```

Công dụng của `useRef` như đã đề cập, cố định dữ liệu giữa các lần re-render, truy xuất giá trị đó qua thuộc tính `current`

Một ứng dụng rất phổ biến của `useRef` là truy xuất đến DOM node. Thí dụ để set focus của input

```jsx
function Form() {
  const nameRef = React.useRef();
  const emailRef = React.useRef();
  const passwordRef = React.useRef();

  const handleSubmit = (e) => {
    e.preventDefault();

    const name = nameRef.current.value;
    const email = emailRef.current.value;
    const password = passwordRef.current.value;

    console.log(name, email, password);
  };

  return (
    <React.Fragment>
      <label>
        Name:
        <input placeholder="name" type="text" ref={nameRef} />
      </label>
      <label>
        Email:
        <input placeholder="email" type="text" ref={emailRef} />
      </label>
      <label>
        Password:
        <input placeholder="password" type="text" ref={passwordRef} />
      </label>

      <hr />

      <button onClick={() => nameRef.current.focus()}>Focus Name Input</button>
      <button onClick={() => emailRef.current.focus()}>
        Focus Email Input
      </button>
      <button onClick={() => passwordRef.current.focus()}>
        Focus Password Input
      </button>

      <hr />

      <button onClick={handleSubmit}>Submit</button>
    </React.Fragment>
  );
}
```

**Bài viết gốc được đăng tải tại** [**Vui Lập Trình**](https://vuilaptrinh.com/hieu-ve-hook-use-ref-cua-react-nhu-the-nao-cho-dung/)

**Có thể bạn quan tâm**

* [Tìm hiểu sâu hơn về useEffect từ A-Z](/languages-and-frameworks/nodejs/reactjs/tim-hieu-sau-hon-ve-useeffect-tu-a-z)


# Tìm hiểu sâu hơn về useEffect từ A-Z

Đây là một bài viết tương đối dài dòng về useEffect, bạn cần biết và đã đọc qua tài liệu về useEffect trên trang chính thức của React trước, và nếu chỉ thực sự cần biết sử dụng useEffect ra sao

### Mỗi lần render là một giá trị Prop và State độc lập <a href="#mi-ln-render-l-mt-gi-tr-prop-v-state-c-lp" id="mi-ln-render-l-mt-gi-tr-prop-v-state-c-lp"></a>

Trước khi bắt đầu nói về `useEffect` chúng ta cần nhắc lại quá trình render

```
function Counter() {
  const [count, setCount] = useState(0);

  return (
    <div>
      <p>You clicked {count} times</p> ...
      <button onClick={() => setCount(count + 1)}></button>
    </div>
  );
}
```

Khác với Vue, nó không phải là một dạng *data binding*, *watcher*, *proxy*, nó chỉ là một giá trị thông thường.

```
const count = 42;

<p> {count} </p>;
```

Đầu tiên giá trị khởi tạo của `count` sẽ =0. Khi chúng ta gọi `setCount(1)`, React sẽ gọi lại component một lần nữa, với giá trị `count` lúc này là `1`. Cứ vậy

```
// Lần đầu render
function Counter() {
  const count = 0; // trả về bởi useState()  // ...
  <p>You clicked {count} times</p>;
  // ...
}

// sau khi click, function này được gọi lại lần nữa
function Counter() {
  const count = 1; // trả về bởi `useState()  // ...
  <p>You clicked {count} times</p>;
  // ...
}

// sau khi click, function được gọi lại lần nữa
function Counter() {
  const count = 2; // trả về bởi useState()  // ...
  <p>You clicked {count} times</p>;
  // ...
}
```

Khi update một state, React gọi lại component, mỗi lần render như vậy, nó sẽ **thấy** một giá trị `count` mới. Sau đó React sẽ update lại DOM tương ứng.

Vấn đề mấu chốt cần nắm là giá trị `count` **trong các lần render khác nhau là khác nhau.**

```
function Counter() {
  const [count, setCount] = useState(0);

  function handleAlertClick() {
    setTimeout(() => {
      alert(`You clicked on: ${count}`);
    }, 3000);
  }

  return (
    <div>
      <p>{count}</p>
      <button onClick={() => setCount(count + 1)}>Click me</button>
      <button onClick={handleAlertClick}>Show alert</button>
      ...
    </div>
  );
}
```

Chúng ta thực hiện các bước sau

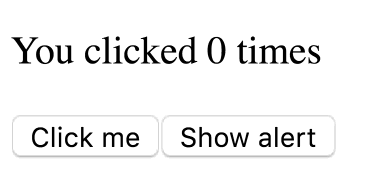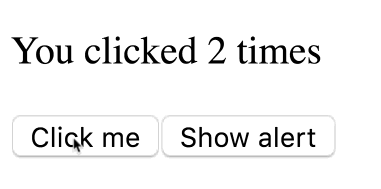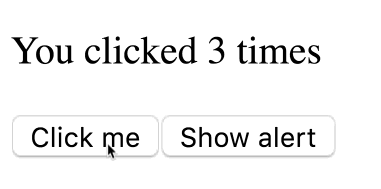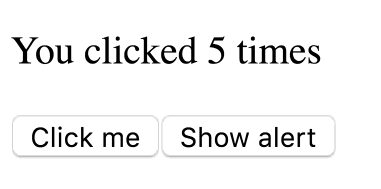
* Bấm counter lên 3
* Bấm “Show alert”
* Bấm tiếp `Click me` cho counter lên 5 trước khi bị gọi timeout

<img src="https://topdev.vn/blog/wp-content/uploads/2020/03/counter.gif" alt="Tìm hiểu sâu hơn về useEffect từ a tới z" height="189" width="381">

Câu hỏi ở đây là nó sẽ alert ra 5 – giá trị cuối cùng, hay là 3 giá trị lúc chúng ta click

Chạy thử

*Bạn có thấy kết quả quá vô lý?*

Như đã nói ở trên, giá trị `count` là hằng số trên mỗi lần render. **Function của chúng ta được gọi nhiều lần, mỗi lần gọi như vậy giá trị `count` bên trong là một số độc lập hoàn toàn với giá trị trước đó**

Không phải **đặc sản** của React, viết dạng function như thế này bạn sẽ dễ hình dung hơn.

```
function sayHi(person) {
  const name = person.name;
  setTimeout(() => {
    alert(`Hello, ${name}`);
  }, 3000);
}

let someone = { name: "Dan" };
sayHi(someone);

someone = { name: "Yuzhi" };
sayHi(someone);

someone = { name: "Dominic" };
sayHi(someone);
```

Thế còn hàm xử lý event thì sao? cụ thể là hàm `handleAlertClick`? Cũng như trên, hàm này là có các **version** khác nhau ở các lần render khác nhau.

Bài viết được **quảng cáo** là nói về `useEffect` mà nãy giờ chưa đá động gì!

Quay lại với ví dụ từ trang chính thức của React

```
function Counter() {
  const [count, setCount] = useState(0);

  useEffect(() => {
    document.title = `You clicked ${count} times`;
  });

  return (
    <div>
      <p>You clicked {count} times</p>
      <button onClick={() => setCount(count + 1)}>Click me</button>
    </div>
  );
}
```

Câu hỏi là `useEffect` đã làm cách nào để lấy được giá trị cuối cùng của `count`?

Lẽ nào đó có một dạng “data binding” hay “watching” ở đây để update giá trị `count` bên trong hàm effect? Hoặc giả React *chơi chiêu* dùng biến mutable bên trong component để luôn có được giá trị cuối?

*Không hề!*

Chúng ta đã biết: giá trị `count` là hằng số cho các lần render, event handle cũng độc lập trên các lần render khác nhau, effect cũng vậy luôn.

Không phải giá trị `count` thay đổi bên trong `useEffect` **bất biến**, mà là `useEffect` cũng bị thay đổi trên từng lần render.

```
// lần render đầu tiên
function Counter() {
  // ...
  useEffect(() => {
    document.title = `You clicked ${0} times`;
  });
  // ...
}

// sau khi click
function Counter() {
  // ...
  useEffect(() => {
    document.title = `You clicked ${1} times`;
  });
  // ...
}

// click thêm lần nữa
function Counter() {
  // ...
  useEffect(() => {
    document.title = `You clicked ${2} times`;
  });
  // ..
}
```

> Có thể mường tượng effect là một phần của kết quả lúc render

Giờ thử với `setTimeout`

```
function Counter() {
  const [count, setCount] = useState(0);

  useEffect(() => {
    ...
    setTimeout(() => {
          console.log(`You clicked ${count} times`);
        }, 3000);
    ...
  });

  return (
    <div>
      <p>You clicked {count} times</p>
      <button onClick={() => setCount(count + 1)}>
        Click me
      </button>
    </div>
  );
}
```

Nếu mà click vài lần với một khoảng thời gian *bỏ nhỏ* thì kết quả log ra là gì?

[Thử ở đây](https://codesandbox.io/s/lyx20m1ol)

Bạn không chỉ nhận được 1 mà là một chuỗi các đoạn log ứng với số lần click.

<img src="https://topdev.vn/blog/wp-content/uploads/2020/03/timeout_counter.gif" alt="Tìm hiểu sâu hơn về useEffect từ a tới z" height="325" width="277">

*Đương nhiên phải chạy như vậy mới đúng chứ, đâu có gì phải thắc mắc?*

Bạn đã thử với `this.state` trong class component chưa?

```
componentDidUpdate() {
    setTimeout(() => {
        console.log(`You clicked ${this.state.count} times`);
    }, 3000)
}
```
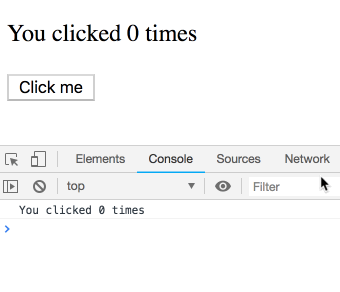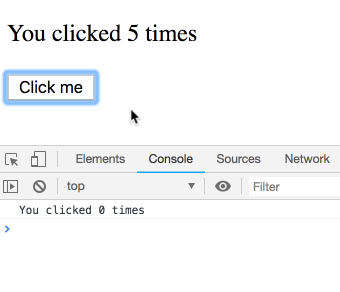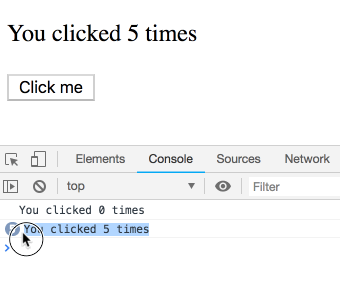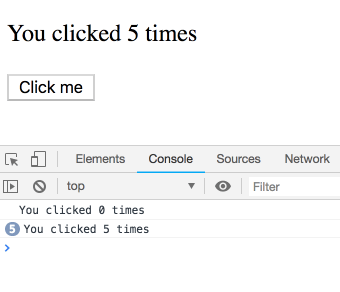
<img src="https://topdev.vn/blog/wp-content/uploads/2020/03/timeout_counter_class.gif" alt="Tìm hiểu sâu hơn về useEffect từ a tới z" height="292" width="340">

*Lý do?* Giá trị `this.state` bên trong class component là một mutation (có thể thay đổi).

Nếu luôn muốn lấy giá trị sau cùng bên trong effect, cách dễ nhất là dùng `refs`

```
function Example() {
    const [count, setCount] = useState(0);
    ...
    const latestCount = useRef(count);
    ...

    useEffect(() => {
        ...
        latestCount.current = count;
        ...
        setTimeout(() => {
            ...
                console.log(`You clicked ${latestCount.current} times`);
            ...
        }, 3000);
    });
}
```

```
function Greeting({ name }) {
  return <h1 className="Greeting">Hello, {name}</h1>;
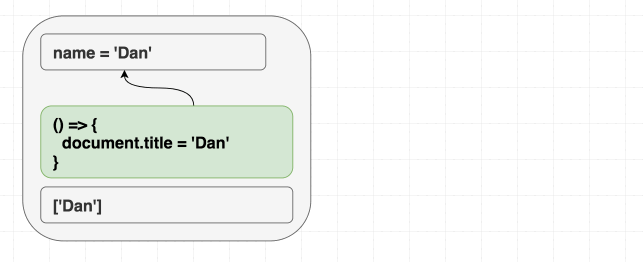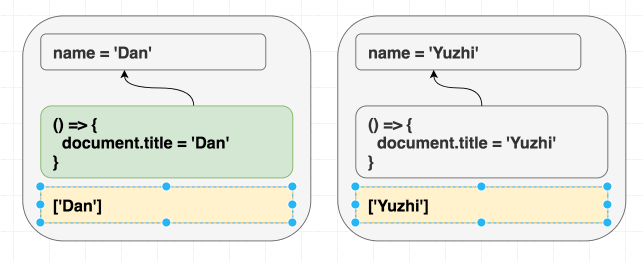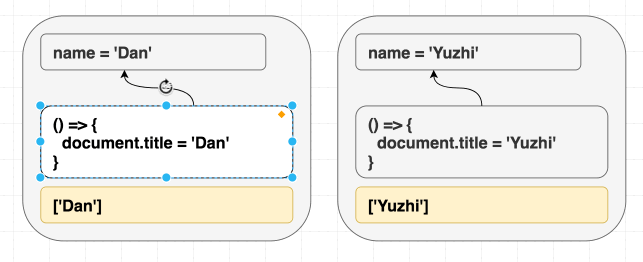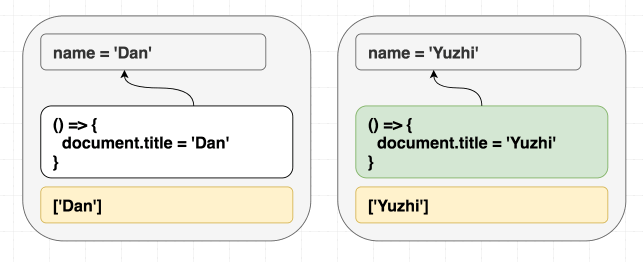
}
```

Nếu chúng ta render `<Greeting name="Dan" />`, sau đó render `<Greeting name="Luu" />`. Cuối cùng chúng ta luôn nhận được *Hello, Luu*

React luôn đồng bộ cục DOM với giá trị hiện tại của `prop` và `state`. Không cần phân biệt giữa `mount` và `update` khi render. Có thể hình dung effect cũng tương tự như vậy, **`useEffect` cho phép đồng bộ những phần không nằm trong React tree với giá trị của `prop` và `state`**

```
function Greeting({ name }) {
  useEffect(() => {
    document.title = "Hello, " + name;
  });

  return <h1 className="Greeting">Hello, {name}</h1>;
}
```

Câu thần chú cho việc này là: **Quan trọng là đích đến, không phải quá trình**

Chạy effect trên tất cả lúc chạy render sẽ không hay lắm, đôi khi có trường hợp lặp vô tận.

Trong quá trình re-render, React chỉ cập nhập đúng phần DOM đã thay đổi.

Ví dụ như

```
<h1 className="Greeting">Hello, Dan</h1>
```

Sang

```
<h1 className="Greeting">Hello, Luu</h1>
```

React sẽ thấy 2 object

```
const oldProps = { className: "Greeting", children: "Hello, Dan" };
const newProps = { className: "Greeting", children: "Hello, Yuzhi" };
```

Nó sẽ xác định được `children` bị thay đổi và cần update, còn `className` thì không, nó sẽ làm như sau

```
domNode.innerText = "Hello, Luu";
```

Chúng ta cũng muốn effect làm điều tương tự, khi re-render chỉ apply những update cần thiết

Ví dụ với component này

```
function Greeting({ name }) {
  const [counter, setCounter] = useState(0);

  useEffect(() => {
    document.title = "Hello, " + name;
  });

  return (
    <h1 className="Greeting">
      Hello, {name}
      <button onClick={() => setCounter(count + 1)}></button>
    </h1>
  );
}
```

`useEffect` không hề liên quan tới giá trị state `counter`, gọi `document.title` khi giá trị `counter` thay đổi không phải là ý hay.

Đó là lý do tại sao chúng ta có thêm tham số `dependency` (một mảng) khi dùng `useEffect`

```
useEffect(() => {
  document.title = "Hello, " + name;
}, [name]); // deps
```

Dịch ra ngôn ngữ con người là thế này: “Tao biết React mày không phân biệt được sự khác nhau bên trong function, nên tao hứa là tao chỉ dùng đến `name` bên trong function này thôi, và chỉ giá trị `name` này update thì mày hả gọi nó”

### Một là không nói dối, 2 là không nói dối nhiều lần <a href="#mt-l-khng-ni-lo-2-l-khng-ni-lo-nhiu-ln" id="mt-l-khng-ni-lo-2-l-khng-ni-lo-nhiu-ln"></a>

Đừng bao giờ lừa gạt React bằng cách đưa dependency không đúng cho nó, hậu quả nhãn tiền. Hợp lý, nhưng nhiều lập trình viên quen sử dụng `class` sẽ cố tình qua mặt

```
function SearchResults() {
  async function fetchData() {
    // ...
  }

  useEffect(() => {
    fetchData();
  }, []);
  // việc ntn được hôn? không phải lúc nào cũng đúng
  // có cách viết tốt hơn
}
```

Bạn sẽ nghĩ là “Tao chỉ muốn chạy nó lúc mount thôi”. Nếu chúng ta chỉ định một dependency, **tất cả giá trị bên trong component sử dụng bởi effect phải được khai báo cụ thể**. Bao gồm prop, state, function

Đôi khi mà làm như vậy nó phát sinh lỗi. Thí dụ như gọi fetch data liên tục hoặc socket được tạo không cần thiết. Cách giải quyets là **không xóa chúng khỏi dependency**

Trước khi nói về cách giải quyết, chúng ta xem vấn đề ở đây là gì khi so sánh Dependency

### Hậu quả của việc dối trá <a href="#hu-qu-ca-vic-di-tr" id="hu-qu-ca-vic-di-tr"></a>

Nếu mảng dependency chứa tất cả giá trị sử dụng trong `useEffect`, React biết được khi nào thì re-run nó

```
useEffect(() => {
  document.title = "Hello, " + name;
}, [name]);
```

<img src="https://topdev.vn/blog/wp-content/uploads/2020/03/deps-compare-correct.gif" alt="Tìm hiểu sâu hơn về useEffect từ a tới z" height="262" width="643">

Nhưng nếu chúng ta chỉ định `[]`, nó không re-run sau lần đầu tiên

```
useEffect(() => {
  document.title = "Hello, " + name;
}, []); // thiếu name
```
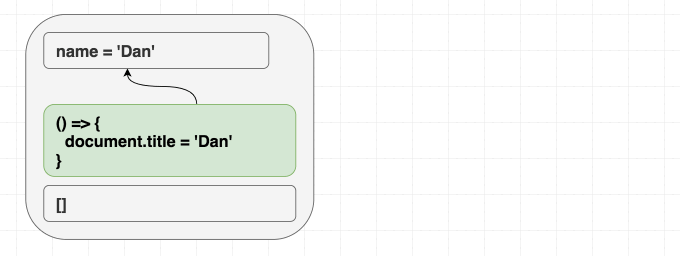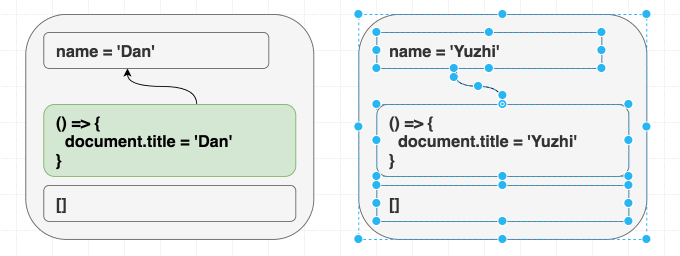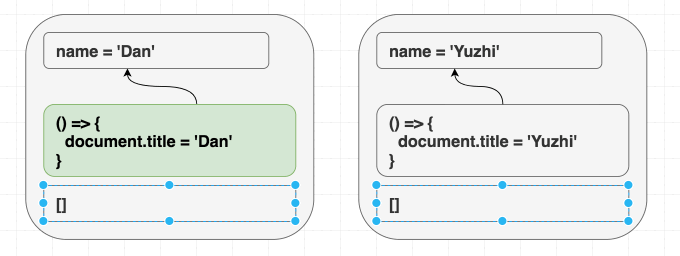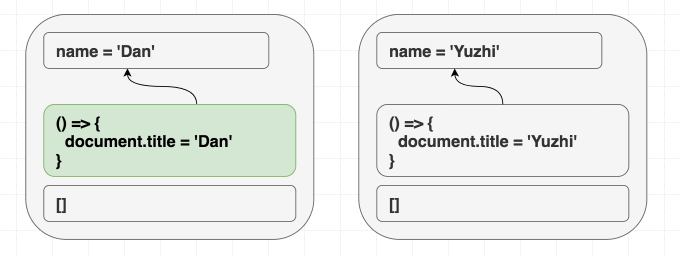
<img src="https://topdev.vn/blog/wp-content/uploads/2020/03/deps-compare-wrong.gif" alt="Tìm hiểu sâu hơn về useEffect từ a tới z" height="256" width="680">

```
useEffect(() => {
  document.title = "Hello, " + name;
}, []); // Sai: không được phép bỏ qua thằng name
```

Rõ ràng là 2 thằng dependency không khác nhau, nên nó sẽ không chạy effect

Trong tình huống này, vấn đề khá là hiển nhiên, nhưng trực giác có thể đánh lừa bạn trong các tình huống khác, lấy ví dụ, chúng ta muốn giá trị `counter` tăng đều sau mỗi giây. Với một class, trực giác sẽ mách bảo: “Set up cái interval một lần, rồi dứt tình vứt áo một lần”, kiểu như [thế này](https://codesandbox.io/s/n5mjzjy9kl), khi chuyển qua dùng `useEffect` bạn sẽ nghĩ đến dùng `[]` cho mảng phụ thuộc “Tao chỉ muốn tình một đêm”, đúng không?

```
function Counter() {
  const [count, setCount] = useState(0);

  useEffect(() => {
    const id = setInterval(() => {
      setCount(count + 1);
    }, 1000);
    return () => clearInterval(id);
  }, []);

  return <h1>{count}</h1>;
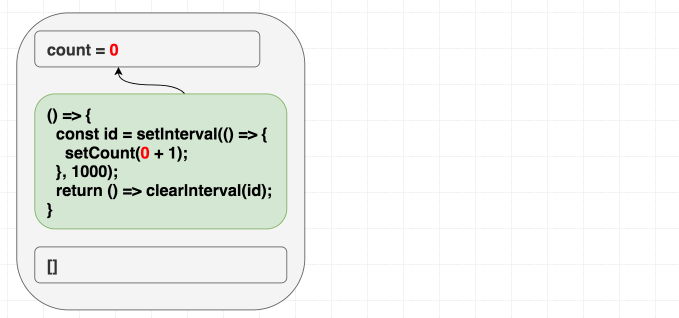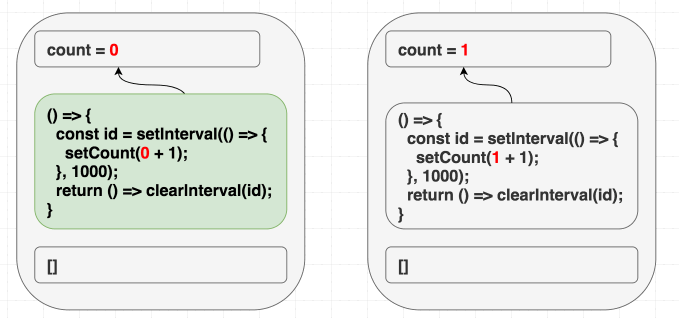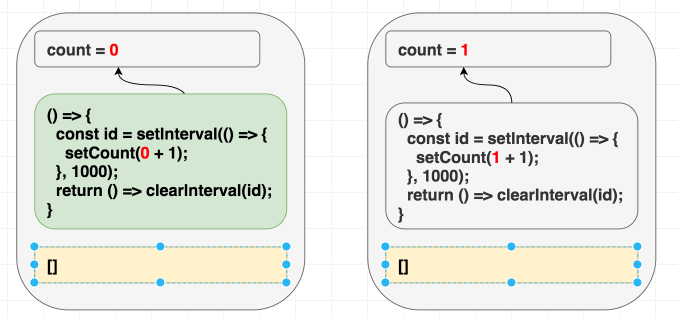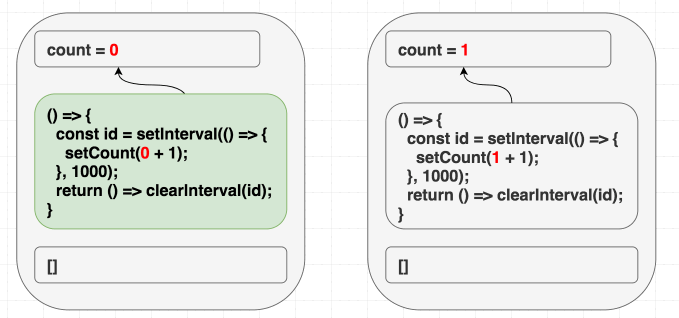
}
```

Theo như lập luận rất hay gặp “danh sách phụ thuộc cho phép chúng ta chỉ định việc re-render effect khi nào”, và ở đây ta chỉ muốn trigger nó một lần vì nó là interval, *nhưng tại sao lại có vấn đề ở đây?*

Chúng ta đang muốn effect này chỉ chạy lần đầu tiên mà thôi, đưa vào dependencies là `[]` có vẻ hợp lý, React sẽ bỏ qua hết những lần sau, nhưng chúng ta đang lừa dối React, vì bên trong chúng ta có sử dụng giá trị `count`, chúng ta có giá trị phụ thuộc mà không khai báo. Thực tế `setCount()` sẽ gọi liên tục sau 1 giây, chứ không dừng lại sau lần gọi đầu tiên.

Ở lần render đầu tiên, `count` = 0, vì thế `setCount(count + 1)` ở lần render đầu tiên nghĩa là `setCount(0+1)`, nhưng vì không re-run effect thêm lần nào nữa, chúng ta cứ gọi mãi `setCount(0+1)` ở những lần tiếp theo

```
// state = 0
function Counter() {
  // ...
  useEffect(
    // lần đầu
    () => {
      const id = setInterval(() => {
        setCount(0 + 1); // luôn là setCount(1)      }, 1000);
      return () => clearInterval(id);
    },
    [] // không re-run  );
  // ...
}

// state = 1
function Counter() {
  // ...
  useEffect(
    // không bao giờ chạy    () => {
      const id = setInterval(() => {
        setCount(1 + 1);
      }, 1000);
      return () => clearInterval(id);
    },
    []
  );
  // ...
}
```

Những con bug như thế này sẽ rất rất khó để mò ra được, vì thế hãy luôn thành thật với React, khai báo hết dependency đang có.

<img src="https://topdev.vn/blog/wp-content/uploads/2020/03/interval-wrong.gif" alt="Tìm hiểu sâu hơn về useEffect từ a tới z" height="318" width="679">

### 2 cách để thú thật với React về dependency <a href="#id-2-cch--th-tht-vi-react-v-dependency" id="id-2-cch--th-tht-vi-react-v-dependency"></a>

*Nên chọn cách một, cách 2 chỉ áp dụng khi cần thiết*

**Cách 1: luôn là người trung thực, chính trực đạo đức hết mực, luôn khai báo đầy đủ thông tin bạn trai, bạn gái, ba má, chú bác nào bạn đang phụ thuộc cho cơ quan thuế**

```
useEffect(() => {
  const id = setInterval(() => {
    etCount(count + 1);
  }, 1000);
  return () => clearInterval(id);
}, [count]);
```

Tuy nhiên thế này, khi giá trị `count` thay đổi, cái interval của chúng ta sẽ bị xóa và đặt lại lần nữa sau những lần render, nó không phải là cái chúng ta mong muốn nó hoạt động như vậy
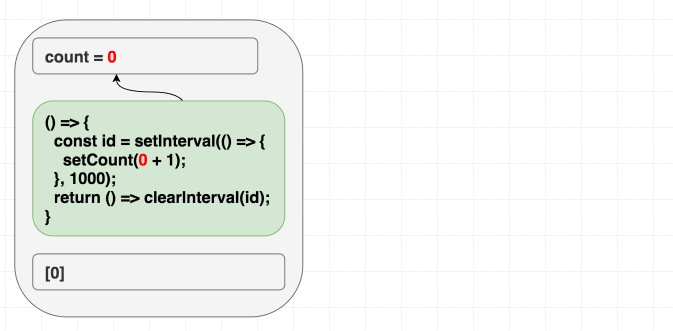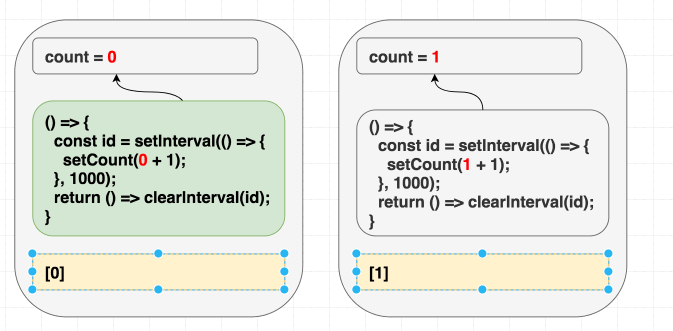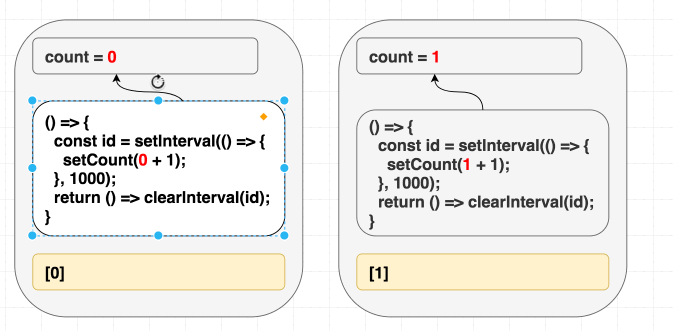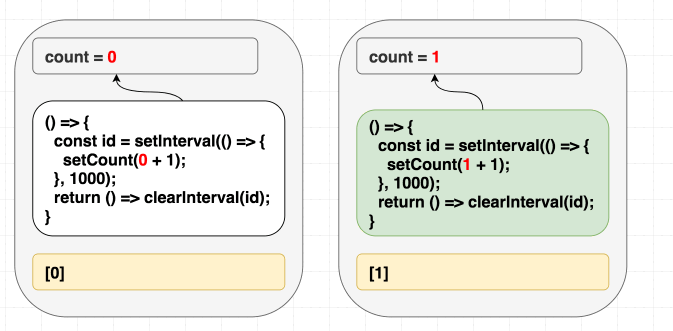
<img src="https://topdev.vn/blog/wp-content/uploads/2020/03/interval-rightish.gif" alt="Tìm hiểu sâu hơn về useEffect từ a tới z" height="331" width="673">

**Cách 2 là thay đổi tư duy, giảm bớt anh trai nuôi, em gái nuôi không cần thiết**

Chúng ta không nói xạo, chúng ta giảm bớt số lượng những thứ phụ thuộc cho việc re-run effect

Để làm được việc này, chúng ta phải hỏi bản thân: **chúng ta dùng count để làm gì?** Có vẻ như chúng ta chỉ dùng nó cho việc gọi hàm `setCount`, chúng ta không thực sự cần giá trị `count` nếu chúng ta biết được giá trị trước đó, trường hợp trên, chúng ta có thể không cần dùng đến giá trị `count` mà dùng *previous state*

```
useEffect(() => {
  const id = setInterval(() => {
    setCount(c => c + 1);
  }, 1000);
  return () => clearInterval(id);
}, []);
```
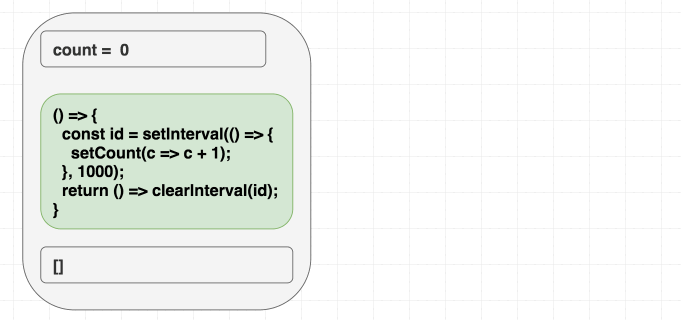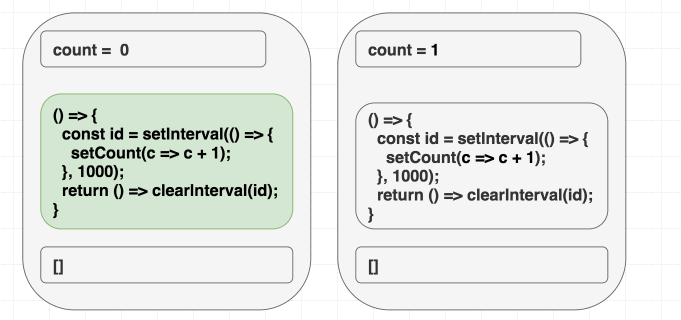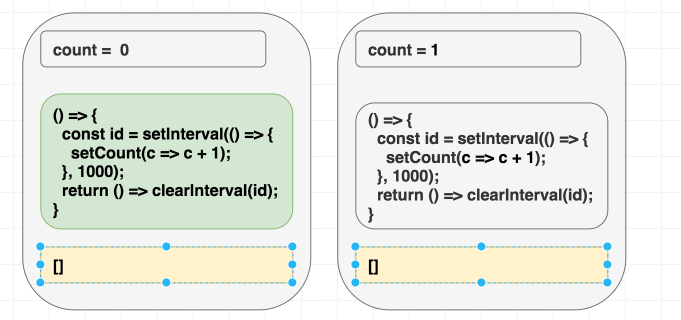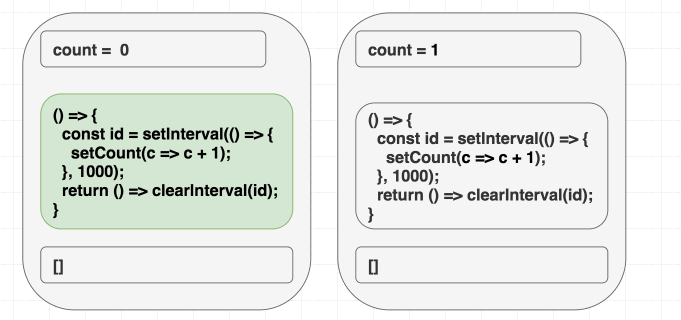
<img src="https://topdev.vn/blog/wp-content/uploads/2020/03/interval-right.gif" alt="Tìm hiểu sâu hơn về useEffect từ a tới z" height="320" width="681">

Chạy thử

### Tính năng update của Google Docs <a href="#tnh-nng-update-ca-google-docs" id="tnh-nng-update-ca-google-docs"></a>

Khi nói về effect, định hướng lập trình chúng ta là **đồng bộ hóa**, có một khái niệm khá thú vị khi thực hiện đồng bộ hóa là chúng ta thường không đồng bộ toàn bộ nội dung. Lấy ví dụ như Google Docs, nó không thực sự truyền tải **cả trang** lên phía server, làm như vậy hiệu năng sẽ rất tệ, cái nó làm là gửi đi một thông tin chứa cái mà user đang muốn thực hiện.

**Tốt nhất truyền đi thật ít thông tin từ effect (chỉ những thông tin cần thiết nhất) vào trong component**. Hàm `setCount(c => c + 1)` sẽ gửi đi ít thông tin hơn so với hàm `setCount(count + 1)` đứng trên một khía cạnh nào đó vì nó không phụ thuộc giá trị hiện tại, sử dụng ít state nhất có thể để đạt được kết quả là một trong các nguyên lý chính của đợt cập nhập React với effect

Tuy nhiên không phải lúc nào cuộc sống cũng đơn giản với bạn như vậy, nếu chúng ta muốn tính toán giá trị của state mới dựa trên một prop, 2 giá trị state phụ thuộc lẫn nhau, `setState` là không đủ. Chúng ta có người chị em hàng xóm tên `useReducer`

```
function Counter({ step }) {
  const [count, dispatch] = useReducer(reducer, 0);

  function reducer(state, action) {
    if (action.type === "tick") {
      return state + step;
    } else {
      throw new Error();
    }
  }

  useEffect(() => {
    const id = setInterval(() => {
      dispatch({ type: "tick" });
    }, 1000);
    return () => clearInterval(id);
  }, [dispatch]);

  return <h1>{count}</h1>;
}
```

Cách dùng `useReducer` như vậy là một dạng **cheat mode** của hook, cho phép chúng ta bỏ qua các dependency *ngầm* khỏi effect, và chặn re-run không không cần thiết

[Chạy thử](https://codesandbox.io/s/7ypm405o8q)

Bài viết này vẫn còn, và nếu bạn vẫn còn muốn đào sâu hơn nữa, có thể tìm đọc bài viết gốc của Dan [A Complete Guide to useEffect](https://overreacted.io/a-complete-guide-to-useeffect/)

**Bài viết gốc được đăng tải tại** [**Vuilaptrinh**](https://vuilaptrinh.com/)


# LoopBack


# Hướng dẫn cài đặt LoopBack 4 và khởi tạo dự án đầu tiên

LoopBack là một framework Node.js và TypeScript mã nguồn mở, có khả năng mở rộng cao, từng đoạt giải thưởng dựa trên Express.

<figure><img src="https://loopback.io/pages/en/lb4/imgs/lb4-high-level.png" alt=""><figcaption><p>LoopBack 4</p></figcaption></figure>

## **1. Cài đặt LoopBack CLI**

Để bắt đầu, bạn cần cài đặt CLI của LoopBack 4. CLI là công cụ hỗ trợ tạo và quản lý các thành phần trong ứng dụng LoopBack.

* **Bước 1:** Cài đặt Node.js (nếu chưa có). Bạn có thể tải Node.js từ [Node.js Download](/languages-and-frameworks/nodejs). LoopBack yêu cầu Node.js phiên bản từ 14 trở lên.
* **Bước 2:** Cài đặt LoopBack CLI bằng cách chạy lệnh sau trong terminal:

  ```bash
  npm install -g @loopback/cli
  ```

  **Lưu ý:** Sử dụng `sudo` nếu cần quyền admin:

  ```bash
  sudo npm install -g @loopback/cli
  ```
* Kiểm tra CLI đã được cài đặt thành công:

  ```bash
  lb4 --version
  ```

## **2. Khởi tạo dự án LoopBack**

* **Bước 1:** Tạo một thư mục mới cho dự án (không bắt buộc nhưng nên thực hiện).

  ```bash
  mkdir my-loopback-app
  cd my-loopback-app
  ```
* **Bước 2:** Sử dụng lệnh CLI để tạo dự án LoopBack:

  ```bash
  lb4 app
  ```
* **Bước 3:** Bạn sẽ được yêu cầu cung cấp một số thông tin:
  * **Project name:** (Tên dự án, mặc định là `my-loopback-app`).
  * **Description:** (Mô tả dự án, tùy chọn).
  * **Application class name:** (Tên lớp chính của ứng dụng, mặc định là `Application`).
  * **Select features to enable:** (Các tính năng bạn muốn bật như ESLint, Prettier, etc.).
* Sau khi cung cấp thông tin, CLI sẽ tự động tạo cấu trúc thư mục và các tệp mã nguồn.

## **3. Cài đặt các gói phụ thuộc**

* Trong thư mục dự án vừa tạo, chạy lệnh sau để cài đặt tất cả các gói phụ thuộc:

  ```bash
  npm install
  ```

## **4. Chạy ứng dụng**

* Để khởi động ứng dụng, chạy lệnh:

  ```bash
  npm start
  ```
* Nếu thành công, bạn sẽ thấy thông báo tương tự:

  ```markdown
  Server is running at http://127.0.0.1:3000
  Try http://127.0.0.1:3000/ping
  ```

## **5. Kiểm tra API**

* Mở trình duyệt và truy cập:
  * *<http://127.0.0.1:3000/explorer>*: Đây là giao diện **API Explorer** tự động được tạo dựa trên OpenAPI.
  * *<http://127.0.0.1:3000/ping>*: Endpoint `/ping` để kiểm tra xem ứng dụng hoạt động.

## **6. Cấu trúc thư mục dự án**

Khi tạo xong, dự án sẽ có cấu trúc cơ bản như sau:

```markdown
my-loopback-app/
├── src/
│   ├── controllers/       # Nơi chứa các controller
│   ├── models/            # Định nghĩa các model
│   ├── repositories/      # Repository truy cập dữ liệu
│   ├── datasources/       # Kết nối cơ sở dữ liệu
│   ├── application.ts     # Lớp chính của ứng dụng
│   ├── index.ts           # Điểm vào của ứng dụng
├── package.json           # Thông tin về dự án và các gói npm
├── tsconfig.json          # Cấu hình TypeScript
├── .eslintrc.js           # Cấu hình ESLint
```

## **7. Tiếp theo: Tạo các thành phần trong ứng dụng**

* Sử dụng CLI để tạo thêm các thành phần:
  * **Controller:**

    ```bash
    lb4 controller
    ```
  * **Model:**

    ```bash
    lb4 model
    ```
  * **Repository:**

    ```bash
    lb4 repository
    ```
  * **Datasource:**

    ```bash
    lb4 datasource
    ```

### **Ví dụ: Tạo ứng dụng Todo**

* Tham khảo tài liệu Todo Tutorial để thực hành xây dựng ứng dụng Todo từ đầu.

Vậy là bạn đã hoàn tất việc cài đặt và khởi tạo dự án LoopBack đầu tiên. Hãy tiếp tục phát triển API của bạn!


# Developer Roadmaps

Trang sẽ cung cấp một tập hợp các lộ trình học tập và phát triển kỹ năng dành cho các lập trình viên và kỹ sư phần mềm.


# Developer Roadmaps: Mô tả chi tiết

Trang **Developer Roadmaps** (<https://roadmap.sh/>) cung cấp một tập hợp các lộ trình học tập và phát triển kỹ năng dành cho các lập trình viên và kỹ sư phần mềm. Các lộ trình này được thiết kế để định hướng cho các cá nhân từ người mới bắt đầu cho đến chuyên gia trong lĩnh vực công nghệ thông tin, dựa trên kinh nghiệm thực tiễn và yêu cầu thực tế của ngành công nghiệp.

Dưới đây là mô tả chi tiết về những gì bạn có thể mong đợi từ trang **Developer Roadmaps**:

***

## **1. Các loại lộ trình phổ biến**

Trang web cung cấp các lộ trình học tập theo từng vai trò và lĩnh vực cụ thể:

### **1.1. Lộ trình theo vai trò**

* **Frontend Developer Roadmap**:\
  Hướng dẫn từ cơ bản đến nâng cao về phát triển giao diện người dùng, bao gồm:
  * Kiến thức cơ bản về HTML, CSS, JavaScript.
  * Frameworks/Thư viện như React, Angular, Vue.js.
  * Các công cụ xây dựng như Webpack, Vite.
  * Tối ưu hóa hiệu suất frontend.
* **Backend Developer Roadmap**:\
  Tập trung vào phát triển phía server, bao gồm:
  * Các ngôn ngữ backend như Python, Java, Node.js, C#.
  * Làm việc với cơ sở dữ liệu (SQL, NoSQL).
  * Xây dựng và tối ưu hóa API.
  * Quản lý hạ tầng và DevOps.
* **Fullstack Developer Roadmap**:\
  Kết hợp các kỹ năng frontend và backend, cho phép phát triển ứng dụng hoàn chỉnh.
* **DevOps Roadmap**:\
  Tập trung vào tự động hóa, triển khai và quản lý hạ tầng.
  * Sử dụng công cụ như Docker, Kubernetes.
  * CI/CD pipelines.
  * Quản lý server, cloud (AWS, Azure, GCP).

### **1.2. Lộ trình theo lĩnh vực**

* **Machine Learning Roadmap**:
  * Hiểu toán học nền tảng: xác suất, thống kê, đại số tuyến tính.
  * Các thư viện và framework phổ biến như TensorFlow, PyTorch.
  * Xử lý dữ liệu, xây dựng mô hình, triển khai mô hình AI.
* **Blockchain Developer Roadmap**:
  * Học về công nghệ blockchain cơ bản (Ethereum, Solana).
  * Xây dựng và triển khai smart contracts.
  * Kỹ năng bảo mật và tối ưu hóa hệ thống blockchain.
* **QA Engineer Roadmap**:
  * Phương pháp kiểm thử: manual, automation.
  * Công cụ kiểm thử: Selenium, Cypress.
  * CI/CD integration và báo cáo lỗi.

***

## **2. Định hướng cụ thể trong từng lộ trình**

* **Chia nhỏ từng bước**: Mỗi lộ trình được chia thành các bước cụ thể, giúp người học biết mình cần học gì trước, học gì sau.
* **Định hướng tài nguyên**: Cung cấp danh sách tài liệu, khóa học, hoặc công cụ hữu ích để hỗ trợ việc học.
* **Cập nhật theo xu hướng mới**: Các lộ trình được duy trì và cập nhật để phù hợp với công nghệ hiện đại.

***

## **3. Lợi ích của việc sử dụng Developer Roadmaps**

* **Tính hệ thống**: Bạn sẽ không phải bối rối với câu hỏi "Học gì trước?" hoặc "Học gì tiếp theo?".
* **Phù hợp mọi cấp độ**: Từ người mới bắt đầu cho đến chuyên gia, các roadmap đều phù hợp.
* **Tập trung thực hành**: Khuyến khích bạn thực hành qua các dự án và công việc thực tế.
* **Xây dựng sự nghiệp**: Các lộ trình được thiết kế dựa trên yêu cầu thực tế của ngành, giúp bạn chuẩn bị tốt hơn cho sự nghiệp.

***

## **4. Lời khuyên khi sử dụng lộ trình**

1. **Không ôm đồm**: Chọn lộ trình phù hợp với mục tiêu hiện tại của bạn.
2. **Thực hành nhiều**: Lý thuyết là chưa đủ; bạn cần áp dụng vào các dự án thực tế.
3. **Tùy chỉnh theo nhu cầu cá nhân**: Không phải mọi bước trong lộ trình đều phù hợp; bạn có thể điều chỉnh để tập trung vào những gì bạn cần.

***

Trang **Developer Roadmaps** là một công cụ tuyệt vời giúp bạn định hướng và phát triển kỹ năng một cách có hệ thống, đồng thời chuẩn bị tốt nhất cho các vai trò trong ngành công nghệ. Nếu bạn quan tâm đến lộ trình cụ thể nào, tôi có thể hỗ trợ chi tiết hơn!


# Roadmaps: ASP.NET Core Developer

Hướng dẫn từng bước để trở thành nhà phát triển lõi ASP.NET vào năm 2024

{% hint style="success" %}
<https://roadmap.sh/aspnet-core>
{% endhint %}


# Bảng phân loại cấp độ nhà phát triển .NET

Lập trình viên .NET (hay .NET Developer) là một trong những vị trí quan trọng trong ngành công nghệ thông tin, đóng vai trò xây dựng các ứng dụng từ nhỏ đến quy mô lớn. Dựa trên kinh nghiệm và mức độ thành thạo công nghệ, nhà phát triển .NET có thể được phân chia thành các cấp độ từ thấp đến cao, bao gồm **Junior Developer**, **Mid-Level Developer**, **Senior Developer**, **Tech Lead/Architect**, và **Principal Engineer**. Dưới đây là chi tiết về từng cấp độ, kỹ năng cần có, và trách nhiệm chính.

***

## Bảng phân loại cấp độ

| Cấp độ                                                | Kinh nghiệm | Kỹ năng/Kiến thức                                                                                                                                                   | Trách nhiệm chính                                                                                                                 |
| ----------------------------------------------------- | ----------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------- | --------------------------------------------------------------------------------------------------------------------------------- |
| [**Junior Developer**](#id-1.-junior-developer)       | 0-2 năm     | <p>- Cơ bản về C#, OOP.<br>- Làm việc với ASP.NET Core MVC.<br>- Hiểu Entity Framework Core và SQL cơ bản.<br>- Sử dụng Visual Studio, Git cơ bản.</p>              | <p>- Xây dựng các module nhỏ.<br>- Fix bug cơ bản.<br>- Học hỏi từ senior.<br>- Viết unit test đơn giản.</p>                      |
| [**Mid-Level Developer**](#id-2.-mid-level-developer) | 2-5 năm     | <p>- Thành thạo C#, LINQ, async/await.<br>- Sử dụng tốt ASP.NET Core Web API, SignalR.<br>- Làm việc với Docker, CI/CD.<br>- Sử dụng cả SQL và NoSQL.</p>           | <p>- Phát triển các tính năng phức tạp.<br>- Hỗ trợ Junior Developer.<br>- Viết tài liệu kỹ thuật.<br>- Tối ưu hóa hiệu suất.</p> |
| [**Senior Developer**](#id-3.-senior-developer)       | >5 năm      | <p>- Hiểu sâu về DDD, CQRS, Microservices.<br>- Thành thạo với Kubernetes, Terraform.<br>- Kinh nghiệm về cloud (Azure, AWS).</p>                                   | <p>- Thiết kế kiến trúc hệ thống.<br>- Định hướng công nghệ.<br>- Mentor nhóm.<br>- Xử lý vấn đề kỹ thuật phức tạp.</p>           |
| [**Tech Lead/Architect**](#id-4.-tech-lead-architect) | >7 năm      | <p>- Kiến thức sâu về Event-driven architecture, Serverless.<br>- Quản lý hạ tầng với Terraform, Ansible.<br>- Làm việc với stakeholders.<br>- Quản lý đội ngũ.</p> | <p>- Thiết kế và định hướng kiến trúc hệ thống.<br>- Đưa ra quyết định công nghệ chiến lược.<br>- Đảm bảo chất lượng dự án.</p>   |
| [**Principal Engineer**](#id-5.-principal-engineer)   | >10 năm     | <p>- Am hiểu toàn diện về phần mềm.<br>- Thành thạo AI/ML, IoT, Blockchain.<br>- Xây dựng chiến lược công nghệ dài hạn.</p>                                         | <p>- Định hướng công nghệ tổ chức.<br>- Dẫn đầu các sáng kiến lớn.<br>- Tạo framework và công cụ dùng chung.</p>                  |

***

## 1. Junior Developer

### **Mô tả vai trò:**

Junior Developer thường là những người mới bắt đầu sự nghiệp lập trình, có kinh nghiệm từ 0 đến 2 năm. Ở cấp độ này, họ tập trung học hỏi và thực hành các kỹ năng cơ bản trong .NET.

### **Kỹ năng cần có:**

* Kiến thức cơ bản về **C#**, **OOP (Object-Oriented Programming)**.
* Hiểu biết về **.NET Framework** hoặc **.NET Core**.
* Làm việc với **ASP.NET Core MVC** để xây dựng ứng dụng web cơ bản.
* Sử dụng cơ sở dữ liệu như **SQL Server** hoặc **SQLite**.
* Thành thạo các công cụ cơ bản như **Visual Studio**, **Git**.

### **Trách nhiệm chính:**

* Phát triển và duy trì các module nhỏ trong dự án.
* Fix lỗi (bug) và thực hiện các yêu cầu đơn giản.
* Viết **Unit Test** cơ bản.
* Học hỏi từ các thành viên cấp cao hơn trong nhóm.

***

## 2. Mid-Level Developer

### **Mô tả vai trò:**

Mid-Level Developer có kinh nghiệm từ 2-5 năm, đủ khả năng để thực hiện các nhiệm vụ phức tạp hơn và bắt đầu đưa ra các giải pháp kỹ thuật.

### **Kỹ năng cần có:**

* Thành thạo **C#**, hiểu rõ **LINQ**, **async/await**, và các mẫu thiết kế cơ bản (Design Patterns).
* Làm việc tốt với **ASP.NET Core Web API**, **SignalR**, và **Entity Framework Core**.
* Kinh nghiệm với **CI/CD pipelines** (Azure DevOps, GitHub Actions) và **Docker**.
* Sử dụng các cơ sở dữ liệu nâng cao: **SQL Server**, **NoSQL (MongoDB, Redis)**.
* Hiểu biết cơ bản về một framework frontend như **React**, **Angular**.

### **Trách nhiệm chính:**

* Phát triển các tính năng mới phức tạp hơn.
* Tối ưu hóa hiệu suất ứng dụng và khắc phục lỗi.
* Hỗ trợ và mentor Junior Developer.
* Viết tài liệu kỹ thuật cho các module.

***

## 3. Senior Developer

### **Mô tả vai trò:**

Senior Developer là người có kinh nghiệm trên 5 năm, chuyên sâu vào các công nghệ .NET và có khả năng dẫn dắt nhóm.

### **Kỹ năng cần có:**

* Thành thạo các khái niệm nâng cao trong **C#** như **Delegates**, **Events**, **Reflection**.
* Hiểu sâu về các mô hình kiến trúc như **Microservices**, **CQRS**, và **DDD (Domain-Driven Design)**.
* Sử dụng các công cụ nâng cao như **Kubernetes**, **Terraform**.
* Kinh nghiệm làm việc với các giải pháp cloud: **Azure**, **AWS**.

### **Trách nhiệm chính:**

* Thiết kế kiến trúc hệ thống, đảm bảo khả năng mở rộng và hiệu suất.
* Định hướng công nghệ cho nhóm, chọn lựa công cụ phù hợp.
* Mentor và đào tạo các thành viên trong nhóm.
* Xử lý các vấn đề kỹ thuật phức tạp nhất trong dự án.

***

## 4. Tech Lead/Architect

### **Mô tả vai trò:**

Tech Lead/Architect chịu trách nhiệm định hướng kỹ thuật và thiết kế kiến trúc cho toàn bộ dự án.

### **Kỹ năng cần có:**

* Kiến thức sâu về thiết kế phần mềm: **Event-driven architecture**, **Serverless**.
* Thành thạo các công cụ quản lý hạ tầng như **Terraform**, **Ansible**.
* Kỹ năng phân tích yêu cầu và giao tiếp với các bên liên quan (stakeholders).

### **Trách nhiệm chính:**

* Đưa ra các quyết định công nghệ chiến lược.
* Thiết kế kiến trúc hệ thống phức tạp.
* Xây dựng quy trình phát triển và đảm bảo chất lượng dự án.
* Giám sát việc triển khai và hỗ trợ kỹ thuật cho toàn nhóm.

***

## 5. Principal Engineer

### **Mô tả vai trò:**

Principal Engineer là vị trí chuyên môn cao nhất, tập trung vào chiến lược công nghệ và dẫn đầu các sáng kiến đổi mới.

### **Kỹ năng cần có:**

* Am hiểu toàn diện về tất cả các nguyên lý phần mềm và hệ thống phân tán.
* Thành thạo các công nghệ mới như **AI/ML**, **IoT**, **Blockchain**.
* Kỹ năng lãnh đạo và định hướng dài hạn trong tổ chức.

### **Trách nhiệm chính:**

* Định hướng công nghệ dài hạn cho tổ chức.
* Xây dựng các công cụ/framework dùng chung.
* Lãnh đạo các sáng kiến lớn trong tổ chức, áp dụng công nghệ mới.

***

## Tổng kết

Bảng phân loại cấp độ giúp nhà phát triển .NET có cái nhìn rõ ràng hơn về con đường sự nghiệp của mình. Mỗi cấp độ đều đòi hỏi sự học hỏi, kỹ năng mới và trách nhiệm lớn hơn. Lộ trình từ Junior Developer đến Principal Engineer không chỉ là một hành trình nâng cao kỹ thuật mà còn đòi hỏi khả năng lãnh đạo và chiến lược.

Nếu bạn đang ở bất kỳ cấp độ nào, hãy tập trung phát triển các kỹ năng cần thiết và tìm kiếm cơ hội học hỏi để thăng tiến trong sự nghiệp!


# ClearPath cho Team .NET Core

Để xây dựng một file ClearPath hoàn chỉnh cho team .NET Core, bạn cần định hướng rõ ràng các mục tiêu, kỹ năng cần phát triển, công nghệ cần sử dụng, và các tiêu chí đánh giá theo từng giai đoạn.

## **1. Mục tiêu tổng quan**

* Đảm bảo đội ngũ nắm vững công nghệ .NET Core để phát triển các ứng dụng hiện đại, có khả năng mở rộng, hiệu suất cao.
* Xây dựng quy trình làm việc chuẩn hóa, hiệu quả, và tích hợp DevOps.
* Tập trung vào phát triển kỹ năng chuyên môn, khả năng cộng tác và giải quyết vấn đề.
* Áp dụng các tiêu chuẩn mới nhất của ngành công nghiệp, như Cloud-Native, Microservices, và CI/CD.

***

## **2. Các giai đoạn phát triển và mục tiêu cụ thể**

<table data-full-width="true"><thead><tr><th width="150">Giai đoạn</th><th width="226">Mục tiêu chính</th><th width="316">Kỹ năng/Kiến thức cần đạt được</th><th>Kết quả mong đợi</th></tr></thead><tbody><tr><td><strong>Junior</strong></td><td>- Hiểu và áp dụng các kiến thức cơ bản về .NET Core.<br>- Thành thạo lập trình backend cơ bản với C# và Entity Framework.</td><td>- C# cơ bản: OOP, LINQ, async/await.<br>- ASP.NET Core MVC, Entity Framework Core.<br>- SQL cơ bản.<br>- Làm việc với Git.<br>- Viết unit test đơn giản.</td><td>- Xây dựng các module nhỏ.<br>- Làm việc với các tính năng CRUD cơ bản.<br>- Thành thạo quy trình code review.</td></tr><tr><td><strong>Intermediate</strong></td><td>- Làm việc với các dự án có quy mô trung bình.<br>- Hiểu sâu hơn về kiến trúc và tối ưu hóa hiệu suất.</td><td>- API RESTful nâng cao (authentication, rate-limiting).<br>- Sử dụng Docker để container hóa ứng dụng.<br>- Làm việc với CI/CD cơ bản.<br>- Làm việc với NoSQL (MongoDB, Redis).</td><td>- Phát triển các module quan trọng.<br>- Viết và tối ưu hóa unit test.<br>- Hỗ trợ các thành viên junior.<br>- Tích hợp CI/CD trong các dự án nhóm.</td></tr><tr><td><strong>Senior</strong></td><td>- Thiết kế và lãnh đạo phát triển kiến trúc hệ thống.<br>- Tối ưu hóa ứng dụng và quản lý các thành viên cấp dưới.</td><td>- Kiến trúc Microservices (gRPC, MediatR).<br>- Làm việc với các dịch vụ cloud (Azure, AWS).<br>- Thiết kế cơ sở dữ liệu nâng cao (indexing, transactions).<br>- DevOps với Kubernetes và Terraform.</td><td>- Đảm bảo hệ thống ổn định và hiệu quả.<br>- Định hướng phát triển công nghệ cho team.<br>- Xử lý các vấn đề kỹ thuật phức tạp.<br>- Mentor các thành viên trong nhóm.</td></tr><tr><td><strong>Tech Lead</strong></td><td>- Đưa ra quyết định chiến lược về công nghệ.<br>- Quản lý và giám sát dự án lớn từ đầu đến cuối.</td><td>- Kiến thức toàn diện về kiến trúc phần mềm.<br>- Tích hợp DevSecOps vào quy trình phát triển.<br>- Xây dựng quy trình tiêu chuẩn hóa cho team.<br>- Lập kế hoạch và phân bổ công việc hợp lý.</td><td>- Đảm bảo chất lượng và tiến độ dự án.<br>- Thiết kế các kiến trúc hệ thống bền vững.<br>- Đào tạo và quản lý đội ngũ.<br>- Định hình các tiêu chuẩn công nghệ cho team.</td></tr></tbody></table>

***

## **3. Công cụ và công nghệ**

<table data-full-width="true"><thead><tr><th width="259">Lĩnh vực</th><th>Công nghệ/Tool cần sử dụng</th></tr></thead><tbody><tr><td><strong>Backend Development</strong></td><td>- <strong>Ngôn ngữ:</strong> C#.<br>- <strong>Frameworks:</strong> ASP.NET Core (MVC, Web API, SignalR), Entity Framework Core.<br>- <strong>Thư viện:</strong> MediatR, AutoMapper.<br>- <strong>Unit Test:</strong> XUnit, NUnit, Moq.</td></tr><tr><td><strong>Database</strong></td><td>- <strong>SQL:</strong> SQL Server, PostgreSQL.<br>- <strong>NoSQL:</strong> MongoDB, Redis.<br>- <strong>ORM:</strong> Entity Framework Core, Dapper.</td></tr><tr><td><strong>DevOps</strong></td><td>- <strong>Containerization:</strong> Docker.<br>- <strong>Orchestration:</strong> Kubernetes.<br>- <strong>CI/CD:</strong> Azure DevOps, GitHub Actions.<br>- <strong>Infrastructure as Code:</strong> Terraform.</td></tr><tr><td><strong>Cloud</strong></td><td>- <strong>Azure:</strong> App Services, Azure Functions, Blob Storage, Azure SQL Database.<br>- <strong>AWS:</strong> EC2, S3, RDS.<br>- <strong>Cloud-Native:</strong> Azure Kubernetes Service, AWS Lambda.</td></tr><tr><td><strong>Frontend (nếu cần)</strong></td><td>- <strong>HTML, CSS, JavaScript.</strong><br>- <strong>Frameworks:</strong> React, Angular, hoặc Blazor (nếu team làm việc với ứng dụng full-stack).</td></tr><tr><td><strong>Security</strong></td><td>- <strong>Authentication:</strong> IdentityServer4, OAuth2, JWT.<br>- <strong>Security Tools:</strong> OWASP ZAP, SonarQube.<br>- <strong>DevSecOps:</strong> Tích hợp bảo mật trong các pipeline CI/CD.</td></tr></tbody></table>

***

## **4. Quy trình làm việc chuẩn hóa**

1. **Coding Standards**:
   * Áp dụng chuẩn **Clean Code** và **SOLID principles**.
   * Thực hiện code review với mọi pull request.
2. **Branching Strategy**:
   * Sử dụng **GitFlow** hoặc **Trunk-Based Development**.
   * Tạo nhánh feature cho mỗi nhiệm vụ.
3. **Testing**:
   * Viết **Unit Test** và **Integration Test** trước khi triển khai.
   * Tích hợp tự động kiểm tra mã nguồn trong pipeline CI/CD.
4. **Deployment**:
   * Triển khai container hóa với Docker.
   * Sử dụng Kubernetes cho môi trường staging và production.
5. **Documentation**:
   * Ghi chép chi tiết về API (sử dụng Swagger).
   * Tài liệu kiến trúc hệ thống và các luồng xử lý chính.

***

## **5. Tiêu chí đánh giá hiệu suất**

<table data-full-width="true"><thead><tr><th width="264">Cấp độ</th><th>Tiêu chí đánh giá</th></tr></thead><tbody><tr><td><strong>Junior</strong></td><td>- Hoàn thành các nhiệm vụ đúng thời hạn.<br>- Hiểu và áp dụng các hướng dẫn coding standards.<br>- Tăng dần khả năng tự giải quyết vấn đề.</td></tr><tr><td><strong>Intermediate</strong></td><td>- Tự giải quyết các nhiệm vụ phức tạp.<br>- Đóng góp vào việc tối ưu hóa hệ thống.<br>- Hỗ trợ junior khi cần.</td></tr><tr><td><strong>Senior</strong></td><td>- Đưa ra các quyết định kỹ thuật đúng đắn.<br>- Mentor đội ngũ junior/intermediate.<br>- Đảm bảo chất lượng hệ thống.</td></tr><tr><td><strong>Tech Lead</strong></td><td>- Đảm bảo team hoàn thành mục tiêu dự án.<br>- Xây dựng kiến trúc hiệu quả và bền vững.<br>- Đưa ra quyết định chiến lược.</td></tr></tbody></table>

***

## **6. Lộ trình đào tạo**

* **Junior:** Tham gia khóa học trực tuyến và thực hành dự án nhỏ.
* **Intermediate:** Tham gia các hội thảo, workshop; thực hành dự án thực tế.
* **Senior:** Nâng cao kỹ năng qua việc giải quyết các vấn đề phức tạp trong dự án.
* **Tech Lead:** Đào tạo về kỹ năng lãnh đạo, chiến lược công nghệ.


# Databases


# SQL Server


# SQL Server Basics

SQL Server Basics là cơ bản về hệ thống quản trị cơ sở dữ liệu do Microsoft phát triển, cung cấp các công cụ quản lý cơ sở dữ liệu, tối ưu hiệu suất, phân tích dữ liệu và bảo mật.

<figure><img src="https://cdn-s3-001.quyit.id.vn/gitbook/blogs/sql-server/sql-server.png" alt="" width="563"><figcaption><p>SQL Server Management Studio (SSMS)</p></figcaption></figure>

SQL Server cung cấp nhiều công cụ và tài nguyên hỗ trợ để giúp người dùng quản lý và tối ưu hóa cơ sở dữ liệu của mình. Sau đây là một số công cụ và tài nguyên quan trọng trong SQL Server:

1. **SQL Server Management Studio (SSMS)**: Đây là một công cụ quản lý cơ sở dữ liệu miễn phí từ Microsoft, cho phép người dùng quản lý cơ sở dữ liệu SQL Server và thực hiện các tác vụ như thiết lập bảo mật, tạo cơ sở dữ liệu và quản lý truy vấn. SSMS có tính năng giao diện đồ họa và dòng lệnh SQL.
2. **SQL Server Data Tools (SSDT)**: Đây là một plug-in cho Visual Studio, cung cấp các công cụ phát triển ứng dụng SQL Server. SSDT cho phép người dùng thiết kế cơ sở dữ liệu, tạo và sửa đổi truy vấn và thực hiện các tác vụ khác liên quan đến cơ sở dữ liệu.
3. **SQL Server Profiler**: Đây là một công cụ giám sát hiệu suất cơ sở dữ liệu, cho phép người dùng ghi lại các hoạt động cơ sở dữ liệu và xem chi tiết về các truy vấn và thời gian phản hồi. SQL Server Profiler cũng cho phép người dùng phân tích và tối ưu hóa các truy vấn để cải thiện hiệu suất hệ thống.
4. **SQL Server Configuration Manager**: Đây là một công cụ quản lý cấu hình, cho phép người dùng thực hiện các tác vụ như thiết lập mạng, thiết lập bảo mật và kiểm soát quyền truy cập người dùng. SQL Server Configuration Manager cũng cho phép người dùng quản lý các dịch vụ SQL Server và thiết lập các tùy chọn liên quan đến hiệu suất và tài nguyên.
5. **SQL Server Books Online**: Đây là một tài liệu trực tuyến, cung cấp các hướng dẫn, ví dụ và tài liệu tham khảo liên quan đến SQL Server. SQL Server Books Online cung cấp các thông tin về các tính năng mới, lời khuyên tối ưu hóa và các hướng dẫn chi tiết về các truy vấn và thao tác cơ bản.
6. **Các diễn đàn và cộng đồng**: Có nhiều diễn đàn và cộng đồng trực tuyến cho người dùng SQL Server, nơi người dùng có thể chia sẻ kinh nghiệm, hỏi đáp và tìm kiếm giải pháp cho các vấn đề liên quan đến SQL Server. Một số diễn đàn và cộng đồng phổ biến bao gồm SQL Server Central, Stack Overflow, Reddit và Microsoft TechNet.
7. **Microsoft Virtual Academy**: Đây là một nơi học trực tuyến miễn phí từ Microsoft, cung cấp các khóa học liên quan đến SQL Server. Các khóa học bao gồm các chủ đề từ cơ bản đến nâng cao và các chủ đề liên quan đến quản lý cơ sở dữ liệu, phát triển ứng dụng và tối ưu hóa hiệu suất.
8. **SQL Server Community**: Đây là một cộng đồng trực tuyến được thành lập bởi Microsoft, cung cấp các tài nguyên, thông tin và hỗ trợ liên quan đến SQL Server. SQL Server Community cung cấp các trang web liên quan đến tài liệu, blog, diễn đàn, sự kiện và các kênh truyền thông xã hội để người dùng có thể tìm kiếm thông tin, chia sẻ kinh nghiệm và tham gia cộng đồng.
9. **SQL Server Data Platform Insider**: Đây là một blog được duy trì bởi nhóm SQL Server Product, cung cấp các thông tin mới nhất và hướng dẫn chi tiết về SQL Server. SQL Server Data Platform Insider cung cấp các bài viết về các tính năng mới, các bài viết về tối ưu hóa hiệu suất và các bài viết về các chủ đề liên quan đến quản lý cơ sở dữ liệu.
10. **SQL Server Professional Association (SSPA)**: Đây là một tổ chức chuyên nghiệp cho các chuyên gia về SQL Server, cung cấp các tài nguyên và thông tin về các khóa học, sự kiện và các tài liệu tham khảo. SSPA cũng cung cấp các tài liệu hướng dẫn và hỗ trợ cho người dùng SQL Server và các chuyên gia liên quan đến cơ sở dữ liệu.

Tổng quan, các công cụ và tài nguyên hỗ trợ của SQL Server là rất đa dạng và phong phú, giúp người dùng tìm kiếm giải pháp và tối ưu hóa cơ sở dữ liệu của mình một cách hiệu quả.

## Kết luận

Tổng kết lại, SQL Server là một trong những hệ quản trị cơ sở dữ liệu quan trọng và phổ biến nhất trên thị trường hiện nay. Với khả năng hỗ trợ các tính năng và chức năng quản lý cơ sở dữ liệu đa dạng, SQL Server là công cụ rất hữu ích cho các nhà phát triển và quản trị cơ sở dữ liệu trong việc xử lý dữ liệu.

Các tính năng của SQL Server bao gồm các công cụ quản lý cơ sở dữ liệu, tối ưu hóa hiệu suất, phân tích dữ liệu và bảo mật. Ngoài ra, SQL Server còn có nhiều tài nguyên và cộng đồng hỗ trợ như các diễn đàn trực tuyến, các trang web hướng dẫn, khóa học trực tuyến và các sự kiện liên quan đến SQL Server.

Tất cả các công cụ và tài nguyên này cung cấp một môi trường hỗ trợ chuyên sâu cho người dùng SQL Server, giúp họ nâng cao hiệu suất và độ tin cậy của cơ sở dữ liệu của mình. Với sự phát triển liên tục và sự hỗ trợ của Microsoft, SQL Server vẫn là một trong những lựa chọn hàng đầu cho các chuyên gia trong lĩnh vực quản trị cơ sở dữ liệu.


# SQL Server: DBCC


# DBCC

DBCC - Database console commands | https\://learn.microsoft.com/en-us/sql/t-sql/database-console-commands/database-console-commands?view=sql-server-ver16

## DBCC (Transact-SQL) <a href="#dbcc-transact-sql" id="dbcc-transact-sql"></a>

Ngôn ngữ lập trình Transact-SQL cung cấp các câu lệnh DBCC hoạt động như các lệnh trên bảng điều khiển cơ sở dữ liệu cho SQL Server.

Các câu lệnh của Bảng điều khiển Cơ sở dữ liệu được nhóm thành các loại sau


# DBCC SHOW\_STATISTICS


# DBCC SHRINKDATABASE

https\://learn.microsoft.com/en-us/sql/t-sql/database-console-commands/dbcc-shrinkdatabase-transact-sql?view=sql-server-ver16

## Cách sử dụng lệnh DBCC SHRINKDATABASE

Lệnh `DBCC SHRINKDATABASE` trong SQL Server được sử dụng để thu nhỏ kích thước của một hoặc nhiều tệp dữ liệu (.mdf) và tệp nhật ký (.ldf) trong cơ sở dữ liệu. Việc thu nhỏ tệp cơ sở dữ liệu có thể giải phóng không gian đĩa và cải thiện hiệu suất trong một số trường hợp.

### **Cú pháp cơ bản:**

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKDATABASE (<tên_cơ_sở_dữ_liệu>);
```

{% endcode %}

#### **Giải thích tham số:**

* `tên_cơ_sở_dữ_liệu`: Tên của cơ sở dữ liệu mà bạn muốn thu nhỏ tệp.

#### **Ví dụ:**

Thu nhỏ tệp cho cơ sở dữ liệu `MyDatabase`:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKDATABASE (N'MyDatabase');
```

{% endcode %}

### **Tùy chọn:**

* **WITH NO\_LOG:** Tùy chọn này ngăn không cho tạo bản ghi nhật ký cho thao tác thu nhỏ.
* **WITH FILEGROUP = \<tên\_nhóm\_tệp>:** Tùy chọn này cho phép bạn thu nhỏ một nhóm tệp cụ thể.
* **WITH FILE = \<tên\_tệp>:** Tùy chọn này cho phép bạn thu nhỏ một tệp cụ thể.

#### **Ví dụ:**

Thu nhỏ tệp cho cơ sở dữ liệu `MyDatabase` mà không tạo bản ghi nhật ký:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKDATABASE (N'MyDatabase') WITH NO_LOG;
```

{% endcode %}

Thu nhỏ tệp cho nhóm tệp `DataFiles` trong cơ sở dữ liệu `MyDatabase`:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKDATABASE (N'MyDatabase') WITH FILEGROUP = N'DataFiles';
```

{% endcode %}

Thu nhỏ tệp `MyLogFile.ldf` trong cơ sở dữ liệu `MyDatabase`:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKDATABASE (N'MyDatabase') WITH FILE = N'MyLogFile.ldf';
```

{% endcode %}

### **Lưu ý:**

* Lệnh `DBCC SHRINKDATABASE` có thể chặn truy cập vào cơ sở dữ liệu trong khi nó đang được thực thi. Do đó, cần thực hiện lệnh này vào thời điểm ít người sử dụng hệ thống.
* Nên sao lưu cơ sở dữ liệu trước khi thu nhỏ tệp.
* Việc thu nhỏ tệp dữ liệu không phải lúc nào cũng cải thiện hiệu suất. Trong một số trường hợp, thu nhỏ tệp dữ liệu có thể làm giảm hiệu suất.
* Nên tham khảo ý kiến ​​của chuyên gia SQL Server trước khi thu nhỏ tệp cơ sở dữ liệu của bạn.

## Ảnh hưởng của lệnh DBCC SHRINKDATABASE

Lệnh `DBCC SHRINKDATABASE` trong SQL Server được sử dụng để thu nhỏ kích thước của tệp dữ liệu (.mdf) và tệp nhật ký (.ldf) trong cơ sở dữ liệu. Việc thu nhỏ tệp cơ sở dữ liệu có thể giải phóng không gian đĩa và cải thiện hiệu suất trong một số trường hợp. Tuy nhiên, cũng có một số tác động tiềm ẩn cần lưu ý:

### **Tác động tích cực:**

* **Giải phóng không gian đĩa:** Thu nhỏ tệp dữ liệu sẽ giải phóng không gian đĩa trống không sử dụng, giúp bạn tiết kiệm dung lượng lưu trữ.
* **Cải thiện hiệu suất:** Tệp dữ liệu bị phân mảnh có thể ảnh hưởng đến hiệu suất truy vấn. Thu nhỏ tệp dữ liệu có thể giúp loại bỏ phân mảnh và cải thiện hiệu suất truy vấn.
* **Giảm thời gian sao lưu:** Tệp dữ liệu nhỏ hơn sẽ được sao lưu nhanh hơn.

### **Tác động tiêu cực:**

* **Chặn truy cập:** Lệnh `DBCC SHRINKDATABASE` có thể chặn truy cập vào cơ sở dữ liệu trong khi nó đang được thực thi. Do đó, cần thực hiện lệnh này vào thời điểm ít người sử dụng hệ thống.
* **Mất hiệu suất tạm thời:** Việc thu nhỏ tệp dữ liệu có thể làm giảm hiệu suất truy vấn trong thời gian ngắn.
* **Nguy cơ mất dữ liệu:** Mặc dù rất hiếm gặp, nhưng việc thu nhỏ tệp dữ liệu có thể dẫn đến mất dữ liệu nếu xảy ra lỗi trong quá trình thực thi.

### **Lưu ý về mất dữ liệu:**

Lệnh `DBCC SHRINKDATABASE` **không trực tiếp xóa dữ liệu** khỏi cơ sở dữ liệu. Thay vào đó, nó chỉ thu nhỏ kích thước của tệp dữ liệu bằng cách loại bỏ không gian trống. Do đó, **lệnh này không gây mất dữ liệu hiện có** trong cơ sở dữ liệu.

#### Tuy nhiên, cần lưu ý rằng:

* **Lỗi trong quá trình thực thi:** Nếu xảy ra lỗi trong khi thực thi lệnh `DBCC SHRINKDATABASE`, có thể dẫn đến mất dữ liệu. Do đó, **nên sao lưu cơ sở dữ liệu trước khi thu nhỏ tệp**.
* **Mất dữ liệu do phân mảnh nghiêm trọng:** Trong trường hợp tệp dữ liệu bị phân mảnh nghiêm trọng, việc thu nhỏ tệp có thể dẫn đến mất dữ liệu.


# DBCC SHRINKFILE

https\://learn.microsoft.com/en-us/sql/t-sql/database-console-commands/dbcc-shrinkfile-transact-sql?view=sql-server-ver16

## Cách sử dụng lệnh DBCC SHRINKFILE

Lệnh `DBCC SHRINKFILE` trong SQL Server được sử dụng để thu nhỏ kích thước của một tệp dữ liệu (.mdf) hoặc tệp nhật ký (.ldf) trong cơ sở dữ liệu. Việc thu nhỏ tệp cơ sở dữ liệu có thể giải phóng không gian đĩa và cải thiện hiệu suất trong một số trường hợp.

### **Cú pháp cơ bản:**

{% code title="SQL" overflow="wrap" lineNumbers="true" %}

```sql
DBCC SHRINKFILE (<tên_tệp>, <tỷ_lệ_thu_nhỏ>);
```

{% endcode %}

#### **Giải thích các tham số:**

* `tên_tệp`: Tên của tệp dữ liệu hoặc tệp nhật ký mà bạn muốn thu nhỏ.
* `tỷ_lệ_thu_nhỏ`: Tỷ lệ phần trăm mà bạn muốn thu nhỏ tệp. Giá trị này là một số nguyên từ 1 đến 100.

#### **Ví dụ:**

Thu nhỏ tệp dữ liệu `MyDataFile.mdf` 50%:

{% code title="SQL" overflow="wrap" lineNumbers="true" %}

```sql
DBCC SHRINKFILE (N'MyDataFile.mdf', 50);
```

{% endcode %}

Thu nhỏ tệp nhật ký `MyLogFile.ldf` 75%:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKFILE (N'MyLogFile.ldf', 75);
```

{% endcode %}

### **Tùy chọn:**

* **WITH NOINCREMENT:** Tùy chọn này ngăn không cho tệp được tăng kích thước tự động sau khi thu nhỏ.
* **WITH NO\_LOG:** Tùy chọn này ngăn không cho tạo bản ghi nhật ký cho thao tác thu nhỏ.
* **WITH FILEGROUP = \<tên\_nhóm\_tệp>:** Tùy chọn này cho phép bạn thu nhỏ một tệp cụ thể trong một nhóm tệp.
* **WITH FILE = \<tên\_tệp>:** Tùy chọn này cho phép bạn thu nhỏ một tệp cụ thể.

#### **Ví dụ:**

Thu nhỏ tệp `MyDataFile.mdf` 50% và ngăn không cho tệp tăng kích thước tự động:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKFILE (N'MyDataFile.mdf', 50) WITH NOINCREMENT;
```

{% endcode %}

Thu nhỏ tệp `MyLogFile.ldf` 75% và không tạo bản ghi nhật ký:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKFILE (N'MyLogFile.ldf', 75) WITH NO_LOG;
```

{% endcode %}

Thu nhỏ tệp `MyDataFile.mdf` 50% trong nhóm tệp `DataFiles`:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKFILE (N'MyDataFile.mdf', 50) WITH FILEGROUP = N'DataFiles';
```

{% endcode %}

Thu nhỏ tệp `MyDataFile2.mdf` 75%:

{% code title="SQL" lineNumbers="true" %}

```sql
DBCC SHRINKFILE (N'MyDataFile2.mdf', 75) WITH FILE = N'MyDataFile2.mdf';
```

{% endcode %}

### **Lưu ý:**

* Lệnh `DBCC SHRINKFILE` có thể chặn truy cập vào tệp dữ liệu hoặc tệp nhật ký trong khi nó đang được thực thi. Do đó, cần thực hiện lệnh này vào thời điểm ít người sử dụng hệ thống.
* Nên sao lưu cơ sở dữ liệu trước khi thu nhỏ tệp.
* Việc thu nhỏ tệp dữ liệu không phải lúc nào cũng cải thiện hiệu suất. Trong một số trường hợp, thu nhỏ tệp dữ liệu có thể làm giảm hiệu suất.
* Nên tham khảo ý kiến ​​của chuyên gia SQL Server trước khi thu nhỏ tệp cơ sở dữ liệu của bạn.

## Ảnh hưởng của lệnh DBCC SHRINKFILE

Lệnh `DBCC SHRINKFILE` trong SQL Server được sử dụng để thu nhỏ kích thước của một tệp dữ liệu (.mdf) hoặc tệp nhật ký (.ldf) trong cơ sở dữ liệu. Việc thu nhỏ tệp cơ sở dữ liệu có thể giải phóng không gian đĩa và cải thiện hiệu suất trong một số trường hợp. Tuy nhiên, cũng có một số tác động tiềm ẩn cần lưu ý:

### **Tác động tích cực:**

* **Giải phóng không gian đĩa:** Thu nhỏ tệp dữ liệu sẽ giải phóng không gian đĩa trống không sử dụng, giúp bạn tiết kiệm dung lượng lưu trữ.
* **Cải thiện hiệu suất:** Tệp dữ liệu bị phân mảnh có thể ảnh hưởng đến hiệu suất truy vấn. Thu nhỏ tệp dữ liệu có thể giúp loại bỏ phân mảnh và cải thiện hiệu suất truy vấn.
* **Giảm thời gian sao lưu:** Tệp dữ liệu nhỏ hơn sẽ được sao lưu nhanh hơn.

### **Tác động tiêu cực:**

* **Chặn truy cập:** Lệnh `DBCC SHRINKFILE` có thể chặn truy cập vào tệp dữ liệu trong khi nó đang được thực thi. Do đó, cần thực hiện lệnh này vào thời điểm ít người sử dụng hệ thống.
* **Mất hiệu suất tạm thời:** Việc thu nhỏ tệp dữ liệu có thể làm giảm hiệu suất truy vấn trong thời gian ngắn.
* **Nguy cơ mất dữ liệu:** Mặc dù rất hiếm gặp, nhưng việc thu nhỏ tệp dữ liệu có thể dẫn đến mất dữ liệu nếu xảy ra lỗi trong quá trình thực thi.

### **Lưu ý về mất dữ liệu:**

Lệnh `DBCC SHRINKFILE` **không trực tiếp xóa dữ liệu** khỏi tệp dữ liệu. Thay vào đó, nó chỉ thu nhỏ kích thước của tệp bằng cách loại bỏ không gian trống. Do đó, **lệnh này không gây mất dữ liệu hiện có** trong tệp dữ liệu.

Tuy nhiên, cần lưu ý rằng:

* **Lỗi trong quá trình thực thi:** Nếu xảy ra lỗi trong khi thực thi lệnh `DBCC SHRINKFILE`, có thể dẫn đến mất dữ liệu. Do đó, **nên sao lưu cơ sở dữ liệu trước khi thu nhỏ tệp**.
* **Mất dữ liệu do phân mảnh nghiêm trọng:** Trong trường hợp tệp dữ liệu bị phân mảnh nghiêm trọng, việc thu nhỏ tệp có thể dẫn đến mất dữ liệu.


# DBCC SQLPERF

Lệnh DBCC SQLPERF(LOGSPACE) trong SQL Server được sử dụng để cung cấp thông tin về trạng thái và không gian sử dụng của Transaction Log cho tất cả các cơ sở dữ liệu trong instance SQL Server.

Cụ thể, lệnh này sẽ hiển thị các thông tin sau:

## Các cột trong kết quả:

1. **Database Name**: Tên của cơ sở dữ liệu.
2. **Log Size (MB)**: Kích thước tổng thể của Transaction Log (bao gồm cả phần đã sử dụng và chưa sử dụng), tính bằng MB.
3. **Log Space Used (%)**: Phần trăm không gian log đã được sử dụng. Nếu giá trị này cao (gần 100%), có thể chỉ ra rằng Transaction Log đang gần đầy hoặc không thể thu hồi không gian.
4. **Log Space Remaining (%)**: Phần trăm không gian log còn lại (không gian chưa được sử dụng).
5. **Status**: Trạng thái của Transaction Log, chẳng hạn như "0" nếu Transaction Log có thể thu hồi không gian, hoặc "1" nếu Transaction Log không thể thu hồi không gian.

### Ví dụ kết quả:

```
Database Name   Log Size (MB)   Log Space Used (%)   Log Space Remaining (%)   Status
--------------- --------------- -------------------- ------------------------ -------
TestDB           1000            80                   20                        0
ProductionDB     500             40                   60                        0
```

* **Log Size (MB)**: 1GB cho TestDB và 500MB cho ProductionDB.
* **Log Space Used (%)**: TestDB đã sử dụng 80% không gian trong khi ProductionDB chỉ sử dụng 40%.
* **Status**: Nếu giá trị là `0`, điều này có nghĩa là Transaction Log có thể được thu hồi không gian (log đang được sử dụng đúng cách).

## Mục đích sử dụng:

* Giúp bạn giám sát mức độ sử dụng Transaction Log và xác định xem có cần phải sao lưu log để giải phóng không gian hay không.
* Kiểm tra xem Transaction Log có thể tự động thu hồi không gian hay không (dựa trên trạng thái "Status").

Nếu thấy phần trăm sử dụng log quá cao, bạn có thể cần sao lưu log hoặc điều chỉnh cấu hình để giảm bớt việc sử dụng không gian log.


# DBCC FREEPROCCACHE

DBCC FREEPROCCACHE: Cách hoạt động và Ứng dụng trong SQL Server

Trong quá trình vận hành SQL Server, việc quản lý bộ nhớ đóng vai trò cực kỳ quan trọng trong hiệu suất hệ thống. Một trong những công cụ hữu ích được cung cấp bởi SQL Server để kiểm soát và tối ưu hóa bộ nhớ là lệnh **DBCC FREEPROCCACHE**. Bài viết này sẽ giúp bạn hiểu rõ hơn về chức năng, cách sử dụng, và những trường hợp áp dụng thực tế của lệnh này.

***

## **1. DBCC FREEPROCCACHE là gì?**

**DBCC FREEPROCCACHE** là một câu lệnh trong SQL Server thuộc nhóm các Database Console Commands (DBCC), được sử dụng để làm sạch **Procedure Cache**. Procedure Cache là nơi SQL Server lưu trữ các Execution Plan (kế hoạch thực thi) của các truy vấn đã thực hiện, nhằm tái sử dụng chúng cho các truy vấn tương tự, giúp giảm chi phí tính toán và tăng tốc độ thực thi.

Tuy nhiên, trong một số trường hợp, Procedure Cache có thể chứa những kế hoạch lỗi thời hoặc không còn hiệu quả. Việc làm sạch Procedure Cache bằng DBCC FREEPROCCACHE sẽ buộc SQL Server phải tạo lại Execution Plan mới cho các truy vấn sau đó.

***

## **2. Cú pháp lệnh DBCC FREEPROCCACHE**

```sql
DBCC FREEPROCCACHE [ WITH NO_INFOMSGS ];
```

* **WITH NO\_INFOMSGS**: Tùy chọn này giúp ẩn các thông báo không cần thiết khi thực hiện lệnh.

***

## **3. Khi nào nên sử dụng DBCC FREEPROCCACHE?**

Mặc dù Procedure Cache giúp cải thiện hiệu suất, nhưng có một số trường hợp việc làm sạch cache là cần thiết:

### **3.1. Thay đổi cấu trúc cơ sở dữ liệu**

* Khi bạn thực hiện các thay đổi lớn như chỉnh sửa bảng, thêm/xóa cột, hoặc cập nhật index, các Execution Plan cũ có thể không còn phù hợp.

### **3.2. Tối ưu hóa hiệu suất**

* Trong quá trình tinh chỉnh truy vấn, bạn cần kiểm tra hiệu quả của các Execution Plan mới sau khi thay đổi các chỉ số (index), thống kê (statistics) hoặc query hints.

### **3.3. Giải quyết vấn đề hiệu suất bất thường**

* Nếu hệ thống gặp các vấn đề về hiệu suất, việc làm sạch Procedure Cache có thể là một bước khắc phục tạm thời để loại bỏ các Execution Plan không hiệu quả.

### **3.4. Kiểm tra và thử nghiệm**

* Khi bạn đang kiểm tra trong môi trường phát triển, làm sạch cache giúp đảm bảo rằng bạn đang đo hiệu suất của các Execution Plan mới, thay vì các kế hoạch đã được lưu trữ trước đó.

***

## **4. Ví dụ sử dụng DBCC FREEPROCCACHE**

### **4.1. Làm sạch toàn bộ Procedure Cache**

```sql
DBCC FREEPROCCACHE;
```

* Lệnh này sẽ xóa tất cả các Execution Plan trong Procedure Cache của hệ thống.

### **4.2. Làm sạch Execution Plan cụ thể**

Nếu bạn chỉ muốn xóa kế hoạch thực thi của một truy vấn cụ thể, bạn có thể sử dụng **DBCC FREEPROCCACHE** với **Plan Handle**.

1. Lấy Plan Handle của một truy vấn:

```sql
SELECT plan_handle 
FROM sys.dm_exec_cached_plans
CROSS APPLY sys.dm_exec_sql_text(plan_handle)
WHERE text LIKE '%<từ khóa truy vấn>%';
```

2. Xóa kế hoạch với Plan Handle:

```sql
DBCC FREEPROCCACHE (<plan_handle>);
```

### 4.3. Không hiển thị thông báo

```sql
DBCC FREEPROCCACHE WITH NO_INFOMSGS;
```

* Lệnh này giúp hạn chế các thông báo không cần thiết, giữ sạch nhật ký hệ thống.

***

## **5. Các lưu ý khi sử dụng DBCC FREEPROCCACHE**

* **Ảnh hưởng đến hiệu suất**: Sau khi làm sạch Procedure Cache, SQL Server sẽ phải tạo lại Execution Plan mới cho các truy vấn, dẫn đến tăng tải hệ thống trong thời gian ngắn.
* **Không khuyến khích trong môi trường sản xuất**: Chỉ sử dụng khi cần thiết vì có thể gây ra hiện tượng giảm hiệu suất tạm thời.
* **Yêu cầu quyền cao**: Bạn cần có quyền **sysadmin** hoặc **serveradmin** để chạy lệnh này.
* **Không hoàn tác được**: Một khi đã làm sạch Procedure Cache, không thể khôi phục các Execution Plan cũ.

***

## **6. So sánh với các lệnh DBCC khác liên quan đến bộ nhớ**

| **Lệnh DBCC**         | **Chức năng**                                                                |
| --------------------- | ---------------------------------------------------------------------------- |
| DBCC FREEPROCCACHE    | Xóa Procedure Cache, buộc SQL Server tạo lại Execution Plan.                 |
| DBCC DROPCLEANBUFFERS | Làm sạch Buffer Cache, buộc SQL Server đọc dữ liệu từ đĩa thay vì từ bộ nhớ. |
| DBCC FLUSHPROCINDB    | Làm sạch Procedure Cache của một database cụ thể (SQL Server 2008 trở lên).  |

***

## **7. Kết luận**

**DBCC FREEPROCCACHE** là một công cụ mạnh mẽ trong SQL Server, giúp bạn kiểm soát và tối ưu hóa Procedure Cache để cải thiện hiệu suất hệ thống. Tuy nhiên, hãy sử dụng nó cẩn thận, đặc biệt trong môi trường sản xuất, để tránh gây ra các vấn đề không mong muốn.

Hy vọng bài viết này cung cấp cho bạn cái nhìn chi tiết và đầy đủ về **DBCC FREEPROCCACHE**. Nếu bạn có bất kỳ câu hỏi hoặc góp ý nào, hãy để lại bình luận dưới bài viết.

***

*Hãy theo dõi blog* [*Cẩm nang NQDEV*](https://blogs.nhquydev.net/) *để cập nhật thêm nhiều kiến thức hữu ích về SQL Server và lập trình!*


# SQL Server Replication

SQL Server Replication là một bộ các giải pháp cho phép sao chép và phân phối cơ sở dữ liệu giữa các SQL server và đồng bộ chúng nhằm duy trì tính nhất quán dữ liệu.


# Giới thiệu SQL Server Replication

Trong hệ thống quản lý cơ sở dữ liệu, việc đảm bảo tính nhất quán và tính sẵn sàng của dữ liệu là vô cùng quan trọng, đặc biệt đối với các ứng dụng doanh nghiệp.

Một trong những giải pháp hữu hiệu mà SQL Server cung cấp để đáp ứng nhu cầu này là **SQL Server Replication**. Hãy cùng NQDEV khám phá công cụ mạnh mẽ này qua bài viết dưới đây.

## 1. **SQL Server Replication là gì?**

SQL Server Replication là một tính năng cho phép sao chép và đồng bộ dữ liệu giữa nhiều cơ sở dữ liệu trong hệ thống. Mục tiêu chính của Replication là đảm bảo rằng dữ liệu ở các vị trí khác nhau luôn được cập nhật đồng nhất, phục vụ tốt cho các trường hợp như:

* Cung cấp dữ liệu cho các ứng dụng khác nhau.
* Tăng cường hiệu suất khi có nhiều người dùng truy cập đồng thời.
* Sao lưu và phục hồi dữ liệu một cách dễ dàng.

***

## 2. **Cách hoạt động của SQL Server Replication**

SQL Server Replication hoạt động dựa trên mô hình **xuất bản (Publish-Subscribe)**. Trong đó, dữ liệu được xuất bản từ một máy chủ chính (Publisher) và được phân phối đến các máy chủ khác (Subscriber). Quá trình này có sự hỗ trợ từ **Distributor** – thành phần quản lý việc phân phối dữ liệu.

### **Các thành phần chính:**

* **Publisher**: Máy chủ hoặc cơ sở dữ liệu cung cấp dữ liệu cần sao chép.
* **Subscriber**: Máy chủ hoặc cơ sở dữ liệu nhận dữ liệu được sao chép.
* **Distributor**: Đóng vai trò trung gian, quản lý quá trình phân phối dữ liệu từ Publisher đến Subscriber.

***

## 3. **Các loại Replication trong SQL Server**

SQL Server hỗ trợ ba loại hình Replication chính:

### **a) Snapshot Replication**

* Dữ liệu được sao chép nguyên trạng tại một thời điểm nhất định.
* Phù hợp cho các hệ thống yêu cầu cập nhật dữ liệu không liên tục hoặc khối lượng dữ liệu nhỏ.

### **b) Transactional Replication**

* Các thay đổi trong Publisher được sao chép ngay lập tức đến Subscriber.
* Phù hợp với các hệ thống yêu cầu tính nhất quán cao, thường xuyên cập nhật.

### **c) Merge Replication**

* Cho phép Publisher và Subscriber đều có thể chỉnh sửa dữ liệu. Các thay đổi được đồng bộ hóa theo chu kỳ.
* Phù hợp cho các ứng dụng cần đồng bộ dữ liệu giữa nhiều điểm không kết nối thường xuyên, ví dụ như hệ thống bán hàng di động.

***

## 4. **Ưu và nhược điểm của SQL Server Replication**

### **Ưu điểm:**

* Đáp ứng tốt các nhu cầu sao chép và đồng bộ dữ liệu phức tạp.
* Tăng khả năng chịu lỗi nhờ việc lưu trữ dữ liệu ở nhiều nơi.
* Cải thiện hiệu suất truy cập nhờ phân phối dữ liệu đến các Subscriber.

### **Nhược điểm:**

* Quản lý và triển khai Replication có thể phức tạp đối với hệ thống lớn.
* Tiêu tốn băng thông khi sao chép dữ liệu liên tục.
* Cần cấu hình đúng cách để tránh các lỗi như xung đột dữ liệu.

***

## 5. **Khi nào nên sử dụng SQL Server Replication?**

Bạn nên cân nhắc sử dụng Replication trong các tình huống sau:

* Dữ liệu cần được sao chép đến nhiều địa điểm để tăng khả năng truy cập.
* Yêu cầu đồng bộ hóa dữ liệu giữa các ứng dụng khác nhau.
* Đảm bảo dữ liệu dự phòng trong các hệ thống quan trọng.

***

## 6. **Tài nguyên hữu ích**

Nếu bạn muốn tìm hiểu thêm về cách triển khai SQL Server Replication, hãy tham khảo tài liệu chính thức tại [SQL Server Replication](https://learn.microsoft.com/en-us/sql/relational-databases/replication/sql-server-replication).

***

## Kết luận

SQL Server Replication là một giải pháp mạnh mẽ giúp doanh nghiệp quản lý dữ liệu hiệu quả, nâng cao tính sẵn sàng và hiệu suất của hệ thống. Với bài viết này, NQDEV hy vọng bạn đã nắm được những kiến thức cơ bản về công cụ này và hiểu cách ứng dụng nó vào hệ thống của mình.

Hãy theo dõi blog của [**Cẩm nang NQDEV** ](/)để cập nhật thêm nhiều bài viết hữu ích nhé! 🌟

***

{% code title="Tài liệu tham khảo:" lineNumbers="true" %}

```http
https://learn.microsoft.com/en-us/sql/relational-databases/replication/sql-server-replication?view=sql-server-ver16
https://www.sql.edu.vn/microsoft-sql-server/replication/
```

{% endcode %}


# Hướng dẫn cấu hình và quản lý SQL Server Replication với Distribution Agent

Trong bài viết này, Cẩm nang NQDEV sẽ hướng dẫn bạn cách kiểm tra, cấu hình và khắc phục các vấn đề phổ biến liên quan đến SQL Server Replication.

Đặc biệt, bài viết tập trung vào việc sử dụng **Snapshot Agent** và **Distribution Agent**, giúp bạn tối ưu hóa hiệu suất đồng bộ dữ liệu trong các môi trường thực tế.

***

## 1. **Kiểm tra cấu hình Snapshot Agent Profile**

### **Cách kiểm tra Snapshot Agent đang dùng**

Để xác định **Snapshot Agent Profile** của một publication, bạn có thể sử dụng truy vấn sau trong cơ sở dữ liệu **`distribution`**:

```sql
USE distribution
GO

SELECT 
    sa.publisher_db AS [Publisher Database],
    sa.name AS [Publication Name],
    sa.profile_id AS [Profile ID],
    ap.profile_name AS [Profile Name]
FROM dbo.MSsnapshot_agents sa
JOIN msdb..MSagent_profiles ap ON sa.profile_id = ap.profile_id
WHERE sa.publisher_db = 'TênCơSởDữLiệuCủaBạn';
```

Kết quả sẽ hiển thị tên database, tên publication và profile đang được sử dụng.

***

## 2. **Xem log của Snapshot Agent**

Nếu Snapshot Agent gặp lỗi hoặc bạn cần xem chi tiết quá trình thực thi, có thể kiểm tra log bằng cách:

### **Truy vấn log chi tiết**

```sql
USE distribution
GO

SELECT 
    sa.name AS PublicationName,
    sh.runstatus AS RunStatus,
    sh.start_time AS StartTime,
    sh.time AS EndTime,
    sh.comments AS LogMessage
FROM dbo.MSsnapshot_agents sa
    JOIN dbo.MSsnapshot_history sh ON sa.id = sh.agent_id
WHERE sh.agent_id = (
    SELECT id 
    FROM dbo.MSsnapshot_agents
    WHERE name = 'TênPublication'
)
ORDER BY sh.time DESC;
```

### **Chạy lại Snapshot Agent**

Nếu cần chạy lại Snapshot Agent để kiểm tra:

```sql
EXEC sys.sp_startpublication_snapshot @publication = 'TênPublication', -- sysname
                                      @publisher = NULL    -- sysname
```

***

## 3. **Giới hạn số lượng lệnh Bulk Insert trong Subscription**

Khi restore dữ liệu từ subscriber, bạn có thể cấu hình **Distribution Agent** để giới hạn số lượng lệnh trong mỗi batch:

### **Cấu hình các tham số quan trọng**

* **`-CommitBatchSize`**: Số lượng hàng trong một giao dịch batch.
* **`-CommitBatchThreshold`**: Số lượng lệnh (commands) trong một giao dịch batch.
* **`-BcpBatchSize`**: Số lượng hàng khi dùng Bulk Copy Program (BCP).

### **Thay đổi thông qua T-SQL**

Bạn có thể cập nhật cấu hình của Distribution Agent bằng cách:

```sql
USE distribution
GO

UPDATE msdb..MSagent_parameters
SET [value] = '1000' -- Giá trị mới
WHERE profile_id = (
    SELECT profile_id 
    FROM MSdistribution_agents 
    WHERE subscriber_db = 'TênDatabaseSubscription'
   )
AND parameter_name = '-CommitBatchSize';
```

Sau đó khởi động lại Distribution Agent:

```sql
-- EXEC sp_start_job @job_name = 'TênJobCủaDistributionAgent';
```

***

## 4. **Giải thích chi tiết các tham số Distribution Agent**

Dưới đây là các tham số quan trọng bạn cần biết khi cấu hình **Distribution Agent**:

<table><thead><tr><th width="321">Tham số</th><th width="247">Ý nghĩa</th><th>Ví dụ cấu hình</th></tr></thead><tbody><tr><td><strong><code>-BcpBatchSize</code></strong></td><td>Số lượng hàng trong mỗi batch BCP.</td><td><code>100000</code></td></tr><tr><td><strong><code>-CommitBatchSize</code></strong></td><td>Số hàng được commit trong một giao dịch batch.</td><td><code>100</code></td></tr><tr><td><strong><code>-CommitBatchThreshold</code></strong></td><td>Số lệnh được thực hiện trong một giao dịch batch.</td><td><code>1000</code></td></tr><tr><td><strong><code>-PollingInterval</code></strong></td><td>Khoảng thời gian (giây) giữa các lần kiểm tra dữ liệu mới.</td><td><code>5</code></td></tr><tr><td><strong><code>-MaxBcpThreads</code></strong></td><td>Số luồng tối đa được sử dụng cho BCP.</td><td><code>1</code></td></tr><tr><td><strong><code>-QueryTimeout</code></strong></td><td>Thời gian tối đa (giây) chờ một truy vấn SQL trước khi timeout.</td><td><code>1800</code> (30 phút)</td></tr><tr><td><strong><code>-SkipErrors</code></strong></td><td>Bỏ qua các lỗi được chỉ định thay vì dừng agent.</td><td><code>Không cấu hình</code></td></tr><tr><td><strong><code>-KeepAliveMessageInterval</code></strong></td><td>Thời gian giữa các keep-alive message để kiểm tra kết nối giữa publisher và subscriber.</td><td><code>300</code> giây (5 phút)</td></tr></tbody></table>

***

## 5. **Kinh nghiệm tối ưu hóa**

* **Giảm độ trễ**: Nếu bạn cần dữ liệu cập nhật nhanh, giảm **`-PollingInterval`** (ví dụ từ `5` xuống `2` giây).
* **Tăng hiệu suất Bulk Insert**: Điều chỉnh **`-CommitBatchSize`** và **`-BcpBatchSize`** phù hợp với kích thước dữ liệu.
* **Theo dõi log thường xuyên**: Đặt **`-TransactionsPerHistory`** nhỏ hơn để ghi log chi tiết hơn trong môi trường cần giám sát.

***

## 6. **Kết luận**

Bài viết trên cung cấp hướng dẫn từ cơ bản đến nâng cao giúp bạn quản lý và tối ưu hóa SQL Server Replication với **Snapshot Agent** và **Distribution Agent**. Nếu bạn gặp vấn đề hoặc muốn tối ưu hiệu suất hệ thống, hãy thử áp dụng các cấu hình này để cải thiện.

{% code title="Tài liệu tham khảo:" lineNumbers="true" %}

```http
https://learn.microsoft.com/en-us/sql/relational-databases/replication/sql-server-replication?view=sql-server-ver16
https://www.sql.edu.vn/microsoft-sql-server/replication/
https://bartoszlewandowski.blog/tag/sql-server-repl/
https://www.mssqltips.com/sqlservertip/3287/sql-server-transactional-replication-error-could-not-find-stored-procedure-error-and-how-to-recover-it-by-using-spscriptpublicationcustomprocs/
https://learn.microsoft.com/en-us/sql/relational-databases/replication/transactional/transactional-articles-specify-how-changes-are-propagated?view=sql-server-ver15
https://sqlserver-dba.co.uk/sql-server/sql-server-error-14151-severity-18-replication-s-agen.html

```

{% endcode %}

***

Hy vọng bài viết này sẽ hữu ích cho bạn đọc của [**Cẩm nang NQDEV**](https://blogs.nhquydev.net/)! Nếu có thắc mắc hoặc cần thêm thông tin, hãy để lại bình luận nhé. 😊


# SQL Server: Tập lệnh


# SQL Server: Tập lệnh để tìm tất cả các giá trị Mặc định với Cột

Trong bài đăng này, tôi đang chia sẻ một tập lệnh để tìm tất cả các giá trị mặc định của các cột trong SQL Server.\
Đôi khi, nó yêu cầu tìm các giá trị mặc định của một cột đang tạo ra sự cố trong quá trình di chuyển dữ liệu.

Bạn có thể dễ dàng tìm thấy các giá trị mặc định trong tập lệnh định nghĩa bảng, nhưng nếu bạn cần báo cáo về tất cả các giá trị mặc định của cơ sở dữ liệu, bạn chỉ muốn một tập lệnh để tìm tất cả các giá trị mặc định.

Sử dụng tập lệnh bên dưới, bạn có thể nhận được tất cả các giá trị mặc định và cũng như nếu bạn yêu cầu tìm giá trị mặc định cụ thể, bạn có thể thêm bộ lọc trong mệnh đề WHERE.

{% code overflow="wrap" lineNumbers="true" fullWidth="false" %}

```sql
SELECT SO.name AS TableName,
       SC.name AS ColumnName,
       SSM.text AS DefaultValue
FROM dbo.sysobjects AS SO
    INNER JOIN dbo.syscolumns AS SC ON SO.id = SC.id
    INNER JOIN dbo.syscomments AS SSM ON SC.cdefault = SSM.id
WHERE SO.xtype = 'U'
ORDER BY SO.name, SC.colid
```

{% endcode %}

#### Kết Luận

Trong bài viết này, chúng ta đã thảo luận về cách tìm tất cả các giá trị mặc định của các cột trong SQL Server sử dụng tập lệnh SQL đơn giản nhưng mạnh mẽ. Việc hiểu và sử dụng tập lệnh này có thể giúp bạn dễ dàng giải quyết những vấn đề liên quan đến giá trị mặc định trong quá trình di chuyển dữ liệu hoặc phát triển cơ sở dữ liệu của mình. Hãy nhớ thử nghiệm tập lệnh này trong môi trường phát triển trước khi áp dụng nó vào môi trường sản xuất, để đảm bảo hiệu quả và tính chính xác của quá trình làm việc.

Đừng quên tham khảo tài liệu thêm [tại đây](/databases/sql-server/sql-server-tap-lenh) để nâng cao kiến thức và kỹ năng làm việc với SQL Server của bạn!

{% code overflow="wrap" %}

```markdown
Tài liệu tham khảo:
- https://www.thachphong.com/t/sql-server/sql-server-tap-lenh-de-tim-tat-ca-cac-gia-tri-mac-dinh-voi-cot_874
```

{% endcode %}


# SQL Server: Tập lệnh theo dõi bảng mới được Insert, Update trong SQL Server

Khi làm việc với cơ sở dữ liệu SQL Server, việc theo dõi các bảng mới được cập nhật hoặc thêm dữ liệu là rất quan trọng để kiểm soát thay đổi và khắc phục sự cố. Dưới đây là các phương pháp hiệu quả để xác định bảng nào mới được insert hoặc update.

### 1. Sử dụng System Dynamic Management Views (DMV)

#### Query cơ bản theo dõi thay đổi trong 24 giờ qua:

```sql
SELECT 
    OBJECT_NAME(object_id) AS TableName,
    last_user_update AS LastUpdate,
    user_updates AS TotalUpdates,
    last_user_seek AS LastSeek,
    last_user_scan AS LastScan
FROM 
    sys.dm_db_index_usage_stats
WHERE 
    database_id = DB_ID()
    AND last_user_update > DATEADD(HOUR, -24, GETDATE())
ORDER BY 
    last_user_update DESC;
```

#### Query chi tiết với thông tin schema:

```sql
SELECT 
    t.name AS TableName,
    s.name AS SchemaName,
    ius.last_user_update AS LastUpdateTime,
    ius.user_updates AS TotalUpdates,
    ius.last_user_seek AS LastSeekTime,
    ius.last_user_scan AS LastScanTime
FROM 
    sys.dm_db_index_usage_stats ius
JOIN 
    sys.tables t ON ius.object_id = t.object_id
JOIN 
    sys.schemas s ON t.schema_id = s.schema_id
WHERE 
    ius.database_id = DB_ID()
    AND ius.last_user_update > DATEADD(HOUR, -24, GETDATE())
ORDER BY 
    ius.last_user_update DESC;
```

#### Check for recently modified tables:

```sql
-- Check for recently modified tables (last 24 hours)
SELECT 
    OBJECT_NAME(object_id) AS TableName,
    last_user_update AS LastUpdate,
    user_updates AS TotalUpdates
FROM 
    sys.dm_db_index_usage_stats
WHERE 
    database_id = DB_ID()
    AND last_user_update > DATEADD(HOUR, -24, GETDATE())
ORDER BY 
    last_user_update DESC;
```

**Lưu ý**: Dữ liệu trong DMV sẽ bị reset mỗi khi SQL Server khởi động lại.

### 2. Sử dụng Change Tracking (Theo dõi thay đổi)

#### Bật Change Tracking cho database:

sql

```sql
ALTER DATABASE YourDatabaseName
SET CHANGE_TRACKING = ON
(CHANGE_RETENTION = 2 DAYS, AUTO_CLEANUP = ON);
```

#### Bật Change Tracking cho bảng cụ thể:

sql

```sql
ALTER TABLE YourTableName
ENABLE CHANGE_TRACKING
WITH (TRACK_COLUMNS_UPDATED = ON);
```

#### Truy vấn thông tin thay đổi:

sql

```sql
SELECT
    t.name AS TableName,
    CT.SYS_CHANGE_VERSION AS ChangeVersion,
    CT.SYS_CHANGE_OPERATION AS Operation,
    CT.SYS_CHANGE_COLUMNS AS ChangedColumns,
    CT.SYS_CHANGE_CONTEXT AS Context
FROM
    CHANGETABLE(CHANGES YourTableName, 0) AS CT
JOIN
    sys.tables t ON OBJECT_ID(CT.table_name) = t.object_id
ORDER BY
    CT.SYS_CHANGE_VERSION DESC;
```

### 3. Sử dụng Change Data Capture (CDC) - Phiên bản Enterprise

#### Bật CDC cho database:

sql

```sql
EXEC sys.sp_cdc_enable_db;
```

#### Bật CDC cho bảng cụ thể:

sql

```sql
EXEC sys.sp_cdc_enable_table
    @source_schema = N'dbo',
    @source_name = N'YourTableName',
    @role_name = NULL,
    @capture_instance = N'YourTableName_Instance';
```

#### Truy vấn thay đổi:

sql

```sql
SELECT *
FROM cdc.dbo_YourTableName_CT
ORDER BY __$start_lsn DESC;
```

### 4. Phương pháp thủ công với Timestamp Columns

#### Thêm cột timestamp vào bảng:

sql

```sql
ALTER TABLE YourTableName 
ADD 
    CreatedDate DATETIME DEFAULT GETDATE(),
    ModifiedDate DATETIME DEFAULT GETDATE()
```

#### Tạo trigger để tự động cập nhật:

sql

```sql
CREATE TRIGGER trg_UpdateModifiedDate
ON YourTableName
AFTER UPDATE
AS
BEGIN
    UPDATE t
    SET ModifiedDate = GETDATE()
    FROM YourTableName t
    INNER JOIN inserted i ON t.PrimaryKey = i.PrimaryKey
END
```

#### Truy vấn các bảng được cập nhật gần đây:

sql

```sql
SELECT 
    TABLE_NAME,
    MAX(ModifiedDate) AS LastModified
FROM 
    INFORMATION_SCHEMA.TABLES t
JOIN 
    YourTableName ON 1=1
WHERE 
    ModifiedDate > DATEADD(HOUR, -24, GETDATE())
GROUP BY 
    TABLE_NAME
ORDER BY 
    LastModified DESC;
```

### 5. Tạo bảng Log để theo dõi thay đổi

#### Tạo bảng log:

sql

```sql
CREATE TABLE ChangeLog (
    LogID INT IDENTITY(1,1) PRIMARY KEY,
    TableName NVARCHAR(128),
    ChangeType NVARCHAR(10),
    ChangeTime DATETIME DEFAULT GETDATE(),
    UserName NVARCHAR(128) DEFAULT SUSER_SNAME()
);
```

#### Tạo trigger để ghi log:

sql

```sql
CREATE TRIGGER trg_LogChanges
ON YourTableName
AFTER INSERT, UPDATE, DELETE
AS
BEGIN
    DECLARE @ChangeType NVARCHAR(10)
    
    IF EXISTS (SELECT * FROM inserted) AND EXISTS (SELECT * FROM deleted)
        SET @ChangeType = 'UPDATE'
    ELSE IF EXISTS (SELECT * FROM inserted)
        SET @ChangeType = 'INSERT'
    ELSE
        SET @ChangeType = 'DELETE'
        
    INSERT INTO ChangeLog (TableName, ChangeType)
    VALUES ('YourTableName', @ChangeType)
END
```

### Kết luận

Tùy vào nhu cầu và phiên bản SQL Server bạn đang sử dụng, có thể lựa chọn phương pháp phù hợp:

1. **DMV**: Nhanh, đơn giản nhưng dữ liệu không tồn tại lâu
2. **Change Tracking**: Phù hợp cho ứng dụng cần đồng bộ dữ liệu
3. **CDC**: Mạnh mẽ nhưng chỉ có trong phiên bản Enterprise
4. **Timestamp Columns & Triggers**: Linh hoạt, hoạt động trên mọi phiên bản


# SQL Server: Cách khởi động SQLServer bỏ qua Database bị lỗi

Khi một database trong SQL Server bị lỗi, nó có thể ngăn toàn bộ instance khởi động thành công. Bài viết này sẽ hướng dẫn bạn các phương pháp khởi động SQL Server mà không load các database bị lỗi.

### 🔍 Nguyên nhân database lỗi ngăn khởi động SQL Server

SQL Server thực hiện quá trình recovery trên tất cả databases khi khởi động. Nếu một database bị lỗi trong quá trình này, instance có thể không khởi động được. Các lỗi thường gặp bao gồm:

* File database bị hỏng
* Transaction log bị lỗi
* Disk đầy hoặc không truy cập được
* Page corruption

### 🛠️ Các phương pháp khởi động SQL Server bỏ qua database lỗi

#### 1. Sử dụng Trace Flag 3608

Trace Flag 3608 yêu cầu SQL Server chỉ khởi động master database, bỏ qua recovery cho tất cả database khác.

**Cách thực hiện:**

1. Mở **SQL Server Configuration Manager**
2. Chuột phải vào SQL Server instance → **Properties**
3. Chọn tab **Startup Parameters**
4. Thêm tham số: `-T3608`
5. Nhấn **Add** → **OK**
6. Khởi động lại SQL Server service

sql

```sql
-- Sau khi khởi động thành công, đặt database lỗi ở chế độ OFFLINE
ALTER DATABASE [DatabaseName] SET OFFLINE WITH ROLLBACK IMMEDIATE;

-- Gỡ bỏ trace flag sau khi xử lý xong
```

#### 2. Đặt database ở chế độ EMERGENCY hoặc OFFLINE

Nếu có thể kết nối đến SQL Server, bạn có thể đặt database lỗi ở chế độ khẩn cấp:

sql

```sql
-- Đặt database ở chế độ EMERGENCY
ALTER DATABASE [DatabaseName] SET EMERGENCY;

-- Sau đó đặt thành OFFLINE
ALTER DATABASE [DatabaseName] SET OFFLINE WITH ROLLBACK IMMEDIATE;
```

#### 3. Di chuyển file database lỗi

Phương pháp vật lý bằng cách di chuyển file database khỏi thư mục data:

1. Dừng SQL Server service
2. Di chuyển file .mdf và .ldf của database lỗi sang thư mục khác
3. Khởi động lại SQL Server
4. Database sẽ hiển thị trạng thái "Recovery Pending"
5. Xóa database lỗi bằng lệnh:

sql

```sql
DROP DATABASE [DatabaseName];
```

### 📝 Các bước khắc phục chi tiết

#### Bước 1: Xác định database gây lỗi

Kiểm tra SQL Server error log để xác định database nào đang gây lỗi:

* File log thường ở: `C:\Program Files\Microsoft SQL Server\MSSQLXX.InstanceName\MSSQL\Log\`

#### Bước 2: Áp dụng phương pháp phù hợp

Chọn một trong các phương pháp trên dựa trên tình huống cụ thể

#### Bước 3: Khôi phục database (nếu có thể)

Sau khi SQL Server khởi động thành công:

* Khôi phục từ backup nếu có
* Sử dụng DBCC CHECKDB để sửa chữa

sql

```sql
-- Đặt database ở chế độ SINGLE_USER
ALTER DATABASE [DatabaseName] SET SINGLE_USER WITH ROLLBACK IMMEDIATE;

-- Chạy sửa chữa
DBCC CHECKDB ([DatabaseName], REPAIR_ALLOW_DATA_LOSS);

-- Đặt lại chế độ MULTI_USER
ALTER DATABASE [DatabaseName] SET MULTI_USER;
```

### ⚠️ Lưu ý quan trọng

1. **Luôn sao lưu dữ liệu** trước khi thực hiện bất kỳ thao tác sửa chữa nào
2. **Trace Flag 3608** chỉ nên dùng tạm thời, gỡ bỏ sau khi xử lý xong
3. Phương pháp **REPAIR\_ALLOW\_DATA\_LOSS** có thể gây mất dữ liệu
4. Kiểm tra nguyên nhân gốc gây lỗi database để tránh tái diễn

### 💡 Mẹo phòng ngừa

* Thiết lập backup thường xuyên và kiểm tra tính toàn vẹn của backup
* Sử dụng tính năng Database Consistency Checks (DBCC CHECKDB) định kỳ
* Giám sát dung lượng disk và tình trạng hardware
* Sử dụng tính năng Auto Close một cách thận trọng

### 📞 Hỗ trợ

Nếu bạn gặp khó khăn trong quá trình thực hiện, hãy truy cập [diễn đàn NQDEV](https://blogs.nhquydev.net/) để được hỗ trợ thêm.

*Tác giả: Nguyễn Quý - Chuyên gia SQL Server tại NQDEV*\
\&#xNAN;*Ngày cập nhật: 11/09/2025*


# Bảng tạm và sự linh hoạt trong xử lý dữ liệu lớn

Bảng tạm (temporary table) là một loại bảng tạm thời được sử dụng trong cơ sở dữ liệu để lưu trữ tạm thời các dữ liệu trong quá trình xử lý truy vấn. Sử dụng bảng tạm trong xử lý dữ liệu lớn có nhiều

Bảng tạm (temporary table) là một công cụ quan trọng trong SQL Server để tạm thời lưu trữ dữ liệu trong quá trình thực hiện các truy vấn phức tạp. Tuy nhiên, nhiều người dùng vẫn chưa biết đầy đủ về các tính năng và cách sử dụng của bảng tạm. Trong bài viết này, chúng ta sẽ tìm hiểu thêm về bảng tạm và những điều bạn chưa biết về chúng.

<figure><img src="https://cdn-s3-001.quyit.id.vn/gitbook/blogs/sql-server/db-tempdb.png" alt="" width="563"><figcaption><p>db-tempdb.png</p></figcaption></figure>

## 1. Bảng tạm là gì?

Bảng tạm (temporary table) là một loại bảng được tạo ra trong bộ nhớ của SQL Server để lưu trữ tạm thời các dữ liệu trong quá trình xử lý truy vấn. Sử dụng bảng tạm trong xử lý dữ liệu lớn có nhiều ưu điểm, tuy nhiên cũng tồn tại những giới hạn và hạn chế.

## 2. Tại sao nên sử dụng bảng tạm?

Có nhiều ưu điểm khi sử dụng bảng tạm trong hệ thống có lượng dữ liệu lớn, trong đó có thể kể đến:

* Tốc độ truy vấn nhanh hơn: Vì dữ liệu được lưu trữ trong bộ nhớ RAM, nên truy vấn và xử lý sẽ nhanh hơn so với bảng vĩnh viễn lưu trữ trên ổ cứng.
* Giảm thiểu tải cho máy chủ: Khi sử dụng bảng tạm, các truy vấn không ảnh hưởng đến bảng chính, giúp giảm thiểu tải cho máy chủ.
* Tính linh hoạt cao: Bảng tạm được tạo ra để phục vụ cho mục đích cụ thể, có thể tạo và xóa bất cứ lúc nào, giúp tăng tính linh hoạt trong quá trình thực hiện truy vấn.

## 3. Các loại bảng tạm

Có hai loại bảng tạm chính: **bảng tạm (`#temporary table`)** và **bảng tạm chia sẻ (`##global temporary table`)**. Bảng tạm chỉ tồn tại trong phiên làm việc hiện tại, trong khi bảng tạm chia sẻ có thể được truy cập từ nhiều phiên làm việc khác nhau.

## 4. Cách sử dụng bảng tạm

Cách sử dụng bảng tạm phụ thuộc vào mục đích sử dụng và yêu cầu của từng truy vấn cụ thể. Tuy nhiên, dưới đây là một số ví dụ về cách sử dụng bảng tạm trong SQL Server:

### Sử dụng bảng tạm để lưu trữ tập hợp dữ liệu tạm thời

Trong nhiều trường hợp, bạn có thể cần tạm thời lưu trữ một tập hợp dữ liệu để sử dụng trong quá trình thực hiện các truy vấn khác. Ví dụ, bạn có thể muốn lưu trữ danh sách các sản phẩm mới nhất để hiển thị trên trang web của mình. Trong trường hợp này, bạn có thể sử dụng câu lệnh `SELECT INTO` để tạo bảng tạm và sao chép dữ liệu vào bảng đó như sau:

```sql
SELECT *
INTO #NewProducts
FROM Products
WHERE DateAdded >= '2022-01-01'
```

Trong ví dụ này, bảng tạm `#NewProducts` sẽ chứa tất cả các sản phẩm được thêm vào sau ngày 1/1/2022.

### Sử dụng bảng tạm để lưu trữ các kết quả truy vấn tạm thời

Trong nhiều trường hợp, bạn có thể muốn thực hiện các truy vấn phức tạp nhưng không muốn lưu kết quả vào một bảng lưu trữ vĩnh viễn. Trong trường hợp này, bạn có thể sử dụng bảng tạm để lưu trữ các kết quả truy vấn tạm thời. Ví dụ, bạn có thể sử dụng câu lệnh SELECT INTO để tạo bảng tạm và lưu trữ các kết quả truy vấn như sau:

```sql
SELECT Customers.CustomerID, Orders.OrderDate
INTO #CustomerOrders
FROM Customers
INNER JOIN Orders ON Customers.CustomerID = Orders.CustomerID
WHERE Customers.Country = 'USA'
```

Trong ví dụ này, bảng tạm `#CustomerOrders` sẽ chứa danh sách các đơn đặt hàng của khách hàng tại Hoa Kỳ, bao gồm mã khách hàng và ngày đặt hàng.

### Sử dụng bảng tạm để tối ưu hóa hiệu suất truy vấn

Trong nhiều trường hợp, bạn có thể sử dụng bảng tạm để tối ưu hóa hiệu suất truy vấn. Ví dụ, bạn có thể sử dụng bảng tạm để tạm thời lưu trữ kết quả của các truy vấn Các câu lệnh trên có thể được sử dụng để thực hiện các truy vấn phức tạp trên bảng tạm, giúp bạn xử lý dữ liệu một cách nhanh chóng và dễ dàng.

## 5. Lưu ý

Mặc dù bảng tạm có nhiều ưu điểm, tuy nhiên khi sử dụng trong các hệ thống có lượng dữ liệu lớn, bạn cần lưu ý những điểm sau để tránh gặp phải các vấn đề liên quan đến hiệu suất và tài nguyên của hệ thống.

1. **Tối ưu hóa truy vấn**: Việc tối ưu hóa truy vấn là cực kỳ quan trọng khi sử dụng bảng tạm. Bạn cần cân nhắc cách tối ưu hóa các truy vấn để tránh tình trạng thời gian chờ hoặc sử dụng quá nhiều tài nguyên của hệ thống.
2. **Xóa bảng tạm khi không sử dụng**: Bảng tạm tồn tại trong bộ nhớ RAM của hệ thống, nên khi không sử dụng nữa, bạn nên xóa bảng tạm để giải phóng tài nguyên cho hệ thống.
3. **Sử dụng bảng tạm đúng cách**: Sử dụng bảng tạm không đúng cách có thể dẫn đến các lỗi không mong muốn, ảnh hưởng đến hiệu suất và tính ổn định của hệ thống. Bạn cần tìm hiểu và nắm vững cách sử dụng bảng tạm đúng cách để tránh những rủi ro này.
4. **Sử dụng bảng tạm phù hợp với mục đích**: Bảng tạm không phải là giải pháp tốt nhất cho mọi tình huống. Bạn cần xác định mục đích sử dụng của mình và chọn loại bảng tạm phù hợp để đạt được hiệu quả tối đa.

## 6. Kết luận

Bảng tạm là một công cụ quan trọng trong SQL Server để xử lý dữ liệu tạm thời trong quá trình thực hiện các truy vấn phức tạp. Tuy nhiên, để sử dụng bảng tạm đúng cách và tránh các rủi ro liên quan đến hiệu suất và tài nguyên, bạn cần nắm vững những kiến thức cơ bản về bảng tạm và cách sử dụng chúng đúng cách.


# Các bước để thay đổi nơi lưu trữ tệp log trong SQL Server

Để thay đổi vị trí lưu trữ tệp **log** của một cơ sở dữ liệu trong SQL Server, bạn cần làm theo các bước dưới đây. Việc này giúp bạn quản lý không gian lưu trữ hiệu quả hơn, đặc biệt là khi ổ đĩa lưu trữ log hiện tại đầy hoặc nếu bạn muốn tách các tệp log và dữ liệu ra khỏi nhau để cải thiện hiệu suất.

## Tóm Tắt Các Bước

1. [Kiểm tra vị trí hiện tại của tệp log.](#id-1.-kiem-tra-vi-tri-tep-log-hien-tai)
2. [Đặt cơ sở dữ liệu ở chế độ Single-User.](#id-2.-tat-cac-ket-noi-va-dat-co-so-du-lieu-o-che-do-single-user-tuy-chon)
3. [Di chuyển tệp log sang vị trí mới với lệnh `ALTER DATABASE`.](#id-3.-di-chuyen-tep-log-sang-vi-tri-moi)
4. [Kiểm tra lại vị trí của tệp log.](#id-4.-kiem-tra-lai-cac-tep-da-duoc-thay-doi)
5. [Đặt lại cơ sở dữ liệu ở chế độ Multi-User.](#id-5.-khoi-dong-lai-co-so-du-lieu-o-che-do-multi-user-neu-can-thiet)
6. [Xoá tệp log cũ nếu cần.](#id-6.-xoa-tep-log-cu-tuy-chon)
7. [Thực hiện sao lưu lại cơ sở dữ liệu và tệp log.](#id-7.-backup-va-kiem-tra-lai)

Nếu bạn gặp phải bất kỳ vấn đề nào trong quá trình này, đừng ngần ngại yêu cầu thêm hướng dẫn!

## Lưu Ý Quan Trọng

1. **Đảm bảo đường dẫn mới có đủ không gian**: Trước khi di chuyển tệp log, đảm bảo rằng ổ đĩa hoặc thư mục đích có đủ dung lượng để chứa tệp log.
2. **Chú ý đến phục hồi trong trường hợp khẩn cấp**: Khi di chuyển tệp log, nếu bạn gặp phải sự cố hoặc lỗi, có thể mất khả năng phục hồi cơ sở dữ liệu nếu không sao lưu đầy đủ.
3. **Tránh di chuyển trong quá trình sao lưu hoặc giao dịch lớn**: Di chuyển tệp log trong khi có các giao dịch lớn hoặc khi sao lưu có thể gây lỗi hoặc ảnh hưởng đến hiệu suất của cơ sở dữ liệu.
4. **Không di chuyển tệp log trong Recovery Models đặc biệt**: Nếu cơ sở dữ liệu đang ở chế độ **Full Recovery Model**, bạn nên cẩn thận hơn khi di chuyển tệp log, vì các tệp log phục vụ cho việc sao lưu và phục hồi điểm thời gian.

## **Chi Tiết Từng Bước**

### **1. Kiểm tra vị trí tệp log hiện tại**

Trước khi di chuyển tệp log, bạn cần kiểm tra vị trí hiện tại của tệp log trong cơ sở dữ liệu.

```sql
-- Kiểm tra vị trí các tệp dữ liệu và log của cơ sở dữ liệu
USE <database_name>;
GO
SELECT name, physical_name AS current_location
FROM sys.master_files
WHERE database_id = DB_ID('<database_name>');
```

Kết quả trả về sẽ cung cấp tên tệp (`name`) và vị trí tệp hiện tại (`current_location`).

### **2. Tắt các kết nối và đặt cơ sở dữ liệu ở chế độ Single User (tùy chọn)**

Để di chuyển tệp log, bạn có thể cần tắt các kết nối tới cơ sở dữ liệu đó. Điều này đảm bảo rằng không có giao dịch nào đang thực hiện trên cơ sở dữ liệu khi bạn thay đổi vị trí tệp.

```sql
-- Đặt cơ sở dữ liệu ở chế độ single user (chỉ cho phép một kết nối duy nhất)
ALTER DATABASE <database_name> SET SINGLE_USER WITH ROLLBACK IMMEDIATE;
```

Lệnh này sẽ ngắt tất cả các kết nối đang mở đến cơ sở dữ liệu và đảm bảo rằng bạn có thể thực hiện các thay đổi mà không gặp phải lỗi khóa.

### **3. Di chuyển tệp Log sang vị trí mới**

Sử dụng câu lệnh `ALTER DATABASE` để thay đổi vị trí tệp log. Bạn cần xác định đường dẫn mới nơi bạn muốn lưu trữ tệp log.

```sql
-- Di chuyển tệp log sang vị trí mới
ALTER DATABASE <database_name>
MODIFY FILE (NAME = <log_file_name>, FILENAME = 'D:\NewLocation\logfile.ldf');
```

#### Trong đó:

* `<database_name>` là tên của cơ sở dữ liệu.
* `<log_file_name>` là tên của tệp log (thường là `log` hoặc tên khác mà bạn đã cấu hình).
* `'D:\NewLocation\logfile.ldf'` là đường dẫn đầy đủ tới thư mục và tên tệp log mới mà bạn muốn di chuyển đến.

### **4. Kiểm tra lại các tệp đã được thay đổi**

Sau khi thay đổi vị trí của tệp log, bạn có thể kiểm tra lại để chắc chắn rằng tệp log đã được di chuyển thành công.

```sql
-- Kiểm tra lại vị trí tệp log sau khi di chuyển
SELECT name, physical_name AS current_location
FROM sys.master_files
WHERE database_id = DB_ID('<database_name>');
```

### **5. Khởi động lại cơ sở dữ liệu ở chế độ Multi-User (nếu cần thiết)**

Sau khi di chuyển tệp log, bạn có thể chuyển cơ sở dữ liệu về chế độ **Multi-User** để cho phép nhiều kết nối.

```sql
-- Đặt lại cơ sở dữ liệu ở chế độ Multi-User
ALTER DATABASE <database_name> SET MULTI_USER;
```

### **6. Xoá tệp log cũ (tùy chọn)**

Nếu bạn muốn xoá tệp log cũ sau khi đã di chuyển, bạn có thể sử dụng câu lệnh `ALTER DATABASE` để loại bỏ tệp log không còn sử dụng nữa.

```sql
-- Xoá tệp log cũ (nếu không còn sử dụng)
ALTER DATABASE <database_name>
REMOVE FILE <log_file_name>;
```

Lệnh này sẽ xóa tệp log cũ mà bạn đã di chuyển sang một vị trí mới.

### 7. **Backup và Kiểm tra lại**

Sau khi thay đổi vị trí của tệp log, hãy đảm bảo thực hiện sao lưu lại cơ sở dữ liệu và tệp log để bảo vệ dữ liệu.

```sql
-- Backup toàn bộ cơ sở dữ liệu
BACKUP DATABASE <database_name> TO DISK = 'D:\Backups\<database_name>.bak';

-- Backup tệp log
BACKUP LOG <database_name> TO DISK = 'D:\Backups\<database_name>_log.trn';
```


# Các bước di chuyển tệp log trong SQL Server

Để di chuyển tệp **log** của cơ sở dữ liệu trong SQL Server từ thư mục này sang thư mục khác, bạn sẽ cần thực hiện một số bước cẩn thận. Dưới đây là hướng dẫn chi tiết từng bước để thay đổi vị trí lưu trữ tệp log (`.ldf`) của cơ sở dữ liệu trong SQL Server.

## **Tóm Tắt Các Bước**

1. [**Kiểm tra thông tin hiện tại về các file** (data file và log).](#buoc-1-kiem-tra-thong-tin-hien-tai-ve-cac-file)
2. [**Đưa cơ sở dữ liệu vào chế độ Offline** để đảm bảo không có kết nối khi di chuyển file.](#buoc-2-dua-co-so-du-lieu-vao-che-do-offline)
3. [**Di chuyển các file (data và log)** từ thư mục cũ sang thư mục mới.](#buoc-3-di-chuyen-cac-file-data-va-log)
4. [**Cập nhật đường dẫn file trong SQL Server** bằng câu lệnh `ALTER DATABASE`.](#buoc-4-cap-nhat-duong-dan-file-trong-sql-server)
5. [**Đưa cơ sở dữ liệu trở lại chế độ Online**.](#buoc-5-dua-co-so-du-lieu-tro-lai-che-do-online)
6. [**Kiểm tra lại trạng thái** của các file để xác nhận rằng các thay đổi đã được áp dụng chính xác.](#buoc-6-kiem-tra-lai-trang-thai-cua-cac-file)

Nếu bạn gặp phải bất kỳ vấn đề nào trong quá trình này, đừng ngần ngại yêu cầu thêm hướng dẫn!

***

## **Lưu Ý Quan Trọng**

1. **Quyền truy cập thư mục mới**:
   * Đảm bảo rằng tài khoản SQL Server (thường là `NT Service\MSSQLSERVER` hoặc tài khoản dịch vụ SQL Server) có đủ quyền **đọc và ghi** vào thư mục mới nơi bạn đã di chuyển các file.
2. **Sao lưu trước khi thực hiện**:
   * Trước khi thực hiện bất kỳ thay đổi nào, hãy sao lưu cơ sở dữ liệu và tệp log để phòng trường hợp có sự cố xảy ra trong quá trình di chuyển.
3. **Không có kết nối khi di chuyển**:
   * Cơ sở dữ liệu phải ở chế độ Offline khi bạn di chuyển các file. Nếu có người dùng hoặc ứng dụng đang kết nối với cơ sở dữ liệu, bạn sẽ không thể thực hiện các thao tác này.
4. **Kiểm tra không có lỗi sau khi di chuyển**:
   * Sau khi hoàn tất, luôn kiểm tra các log của SQL Server (tìm lỗi trong SQL Server Error Log) để đảm bảo rằng không có lỗi xảy ra trong quá trình di chuyển file.
5. **Ảnh hưởng đến hiệu suất**:
   * Nếu cơ sở dữ liệu của bạn có kích thước lớn và tệp log hoạt động liên tục, quá trình di chuyển có thể mất một khoảng thời gian dài. Hãy chọn thời điểm thực hiện khi không có người dùng kết nối hoặc tác vụ quan trọng.
6. **Chế độ Offline và Online**:
   * Trong khi cơ sở dữ liệu ở chế độ Offline, người dùng sẽ không thể truy cập vào cơ sở dữ liệu. Hãy thực hiện vào thời điểm ít người dùng nhất để tránh gián đoạn công việc.
7. **Thực hiện trong môi trường thử nghiệm**:
   * Nếu có thể, hãy thử thực hiện các thao tác này trên một cơ sở dữ liệu thử nghiệm trước khi thực hiện trên môi trường sản xuất.

***

## **Chi Tiết Từng Bước**

### **Bước 1: Kiểm tra thông tin hiện tại về các file**

Trước khi di chuyển, bạn cần kiểm tra vị trí của các tệp dữ liệu và tệp log hiện tại. Sử dụng câu lệnh SQL sau để xem thông tin chi tiết về các file trong cơ sở dữ liệu:

```sql
USE [master];
GO
SELECT 
    name, 
    physical_name AS current_path
FROM sys.master_files
WHERE database_id = DB_ID('Tên_Cơ_Sở_Dữ_Liệu');
GO
```

* **Giải thích**: Thay `'Tên_Cơ_Sở_Dữ_Liệu'` bằng tên cơ sở dữ liệu mà bạn muốn di chuyển các file.
* Kết quả trả về sẽ là tên và đường dẫn hiện tại của các file `.mdf` (data file) và `.ldf` (log file).

***

### **Bước 2: Đưa cơ sở dữ liệu vào chế độ Offline**

Để đảm bảo rằng không có hoạt động nào liên quan đến cơ sở dữ liệu trong khi bạn di chuyển các file, bạn cần đưa cơ sở dữ liệu vào chế độ Offline. Dùng câu lệnh sau:

```sql
ALTER DATABASE [Tên_Cơ_Sở_Dữ_Liệu] SET OFFLINE WITH ROLLBACK IMMEDIATE;
GO
```

* **Giải thích**: `ROLLBACK IMMEDIATE` sẽ ngắt kết nối với cơ sở dữ liệu ngay lập tức và hoàn tất các giao dịch đang dở dang.
* Sau khi thực hiện câu lệnh này, cơ sở dữ liệu sẽ không còn truy cập được, giúp bạn thực hiện thao tác di chuyển các file an toàn.

***

### **Bước 3: Di chuyển các file (data và log)**

Bây giờ bạn có thể di chuyển các tệp log (`.ldf`) và dữ liệu (`.mdf`) từ thư mục cũ sang thư mục mới bằng cách sử dụng Windows Explorer hoặc công cụ dòng lệnh (như `move` hoặc `xcopy`).

Ví dụ:

* **Di chuyển tệp dữ liệu**: `move D:\SQLData\MyDB.mdf E:\SQLData\MyDB.mdf`
* **Di chuyển tệp log**: `move D:\SQLLogs\MyDB_log.ldf E:\SQLLogs\MyDB_log.ldf`

Hãy chắc chắn rằng các thư mục đích mới có quyền truy cập cho SQL Server.

***

### **Bước 4: Cập nhật đường dẫn file trong SQL Server**

Sau khi di chuyển các tệp, bạn cần thông báo cho SQL Server về vị trí mới của các file. Dùng câu lệnh `ALTER DATABASE` để thay đổi đường dẫn các file:

```sql
ALTER DATABASE [Tên_Cơ_Sở_Dữ_Liệu] 
MODIFY FILE (NAME = 'Tên_File', FILENAME = 'Đường_Dẫn_Mới');
GO
```

#### **Giải thích**:

* `Tên_File`: là tên của file (ví dụ: `MyDB_log` cho file log hoặc `MyDB` cho file dữ liệu).
* `Đường_Dẫn_Mới`: là vị trí thư mục mới mà bạn đã di chuyển tệp tới (ví dụ: `E:\SQLLogs\MyDB_log.ldf`).

#### Ví dụ:

* Cập nhật vị trí file dữ liệu:

```sql
ALTER DATABASE [Tên_Cơ_Sở_Dữ_Liệu] 
MODIFY FILE (NAME = 'MyDB', FILENAME = 'E:\SQLData\MyDB.mdf');
GO
```

* Cập nhật vị trí file log:

```sql
ALTER DATABASE [Tên_Cơ_Sở_Dữ_Liệu] 
MODIFY FILE (NAME = 'MyDB_log', FILENAME = 'E:\SQLLogs\MyDB_log.ldf');
GO
```

***

### **Bước 5: Đưa cơ sở dữ liệu trở lại chế độ Online**

Sau khi đã cập nhật thông tin về đường dẫn của các file, bạn cần đưa cơ sở dữ liệu trở lại chế độ Online để tiếp tục sử dụng:

```sql
ALTER DATABASE [Tên_Cơ_Sở_Dữ_Liệu] SET ONLINE;
GO
```

* Sau khi thực hiện câu lệnh này, cơ sở dữ liệu sẽ trở lại trạng thái sẵn sàng và có thể truy cập lại bình thường.

***

### **Bước 6: Kiểm tra lại trạng thái của các file**

Cuối cùng, kiểm tra lại trạng thái của các file để đảm bảo rằng các thay đổi đã được áp dụng chính xác:

```sql
USE [master];
GO
SELECT 
    name, 
    physical_name AS current_path
FROM sys.master_files
WHERE database_id = DB_ID('Tên_Cơ_Sở_Dữ_Liệu');
GO
```

* **Giải thích**: Kiểm tra lại thông tin về các file để xác nhận rằng các file đã được di chuyển và đường dẫn mới đã được cập nhật đúng.

***

## **Kết luận**

Di chuyển tệp dữ liệu và log trong SQL Server yêu cầu bạn phải cẩn trọng và thực hiện đúng quy trình để đảm bảo rằng không có dữ liệu nào bị mất mát và cơ sở dữ liệu hoạt động bình thường sau khi thay đổi. Thực hiện theo các bước trên và lưu ý các vấn đề quan trọng để bảo vệ dữ liệu của bạn.


# Query Store trong SQL Server - Tổng Quan và Cách Quản Lý Hiệu Quả

## **1. Giới thiệu về Query Store**

Query Store là một tính năng quan trọng trong SQL Server (bắt đầu từ phiên bản SQL Server 2016), giúp theo dõi, lưu trữ và phân tích hiệu suất truy vấn. Đây là công cụ mạnh mẽ cho DBA (Database Administrator) để tối ưu hóa các kế hoạch thực thi (Execution Plan) và phát hiện các vấn đề về hiệu suất.

## **2. Tác dụng của Query Store**

### **Ưu điểm của Query Store**

* **Giám sát hiệu suất truy vấn lâu dài**: Lưu trữ dữ liệu về truy vấn, kế hoạch thực thi và số liệu thống kê giúp theo dõi hiệu suất qua thời gian.
* **Phân tích kế hoạch thực thi truy vấn**: So sánh kế hoạch cũ và mới, phát hiện sự thay đổi bất thường.
* **Phục hồi kế hoạch truy vấn**: Cho phép ép buộc SQL Server sử dụng một kế hoạch thực thi tối ưu thông qua **Force Plan**.
* **Giảm thiểu việc điều tra thủ công**: Tự động lưu trữ thông tin giúp dễ dàng phân tích hiệu suất.
* **Tích hợp sẵn trong SQL Server**: Không cần công cụ bên ngoài.

### **Nhược điểm của Query Store**

* **Tăng sử dụng tài nguyên (CPU, I/O và bộ nhớ)**: Ghi nhận dữ liệu liên tục có thể ảnh hưởng đến hiệu suất hệ thống.
* **Tiêu tốn dung lượng đĩa**: Nếu không kiểm soát tốt, Query Store có thể làm tăng dung lượng file dữ liệu .mdf.
* **Không thể chỉ định file lưu trữ riêng biệt**: Query Store luôn sử dụng file chính của cơ sở dữ liệu.
* **Có thể gây ảnh hưởng đến hiệu suất nếu không được cấu hình đúng cách**.

## **3. Operation Mode trong Query Store**

Operation Mode là thuộc tính kiểm soát cách Query Store hoạt động:

### **1. Read Write (Mặc định)**

* **Chế độ đầy đủ**: Cho phép ghi nhận tất cả các truy vấn và kế hoạch thực thi.
* **Hữu ích khi cần theo dõi hiệu suất, tối ưu truy vấn và quản lý kế hoạch thực thi**.
* **Câu lệnh kích hoạt:**

  ```sql
  ALTER DATABASE [YourDatabase] SET QUERY_STORE = ON;
  ALTER DATABASE [YourDatabase] SET QUERY_STORE (OPERATION_MODE = READ_WRITE);
  ```

### **2. Read Only**

* **Chỉ đọc, không ghi dữ liệu mới**.
* **Hữu ích trong bảo trì hoặc khi không muốn Query Store tiếp tục ghi nhận dữ liệu**.
* **Câu lệnh kích hoạt:**

  ```sql
  ALTER DATABASE [YourDatabase] SET QUERY_STORE (OPERATION_MODE = READ_ONLY);
  ```

### **3. Off**

* **Vô hiệu hóa hoàn toàn Query Store**.
* **Hữu ích khi muốn tiết kiệm tài nguyên hệ thống**.
* **Câu lệnh tắt Query Store:**

  ```sql
  ALTER DATABASE [YourDatabase] SET QUERY_STORE = OFF;
  ```

## **4. Cách Đọc và Ghi Dữ Liệu từ Query Store**

SQL Server tự động ghi dữ liệu vào Query Store khi có truy vấn được thực thi. Để đọc dữ liệu, bạn có thể truy vấn các bảng hệ thống:

{% code title="=== Check Query Store ===" %}

```sql
SELECT qsq.query_id, qsp.plan_id
    , qsrs.execution_type_desc
    , qsrs.count_executions
    , qsrs.last_duration
    , qsrs.min_duration
    , qsrs.avg_duration
    , qsrs.max_duration
    , qsqt.query_sql_text
    , CONVERT(XML, qsp.query_plan) AS query_plan
FROM sys.query_store_query AS qsq
    INNER JOIN sys.query_store_plan AS qsp ON qsp.query_id = qsq.query_id
    INNER JOIN sys.query_store_runtime_stats AS qsrs ON qsrs.plan_id = qsp.plan_id
    LEFT JOIN sys.query_store_query_text AS qsqt ON qsq.query_text_id = qsqt.query_text_id
WHERE 1=1
    -- Lọc các truy vấn đã thực thi trong 7 ngày qua
    AND qsrs.last_execution_time > DATEADD(DAY, -7, GETDATE())
    
    -- Lọc các truy vấn có thời gian thực thi trung bình (avg_duration) lớn hơn 1000 mili-giây
    AND qsrs.avg_duration > 1000
ORDER BY qsrs.avg_duration DESC, qsq.query_id ASC
GO
```

{% endcode %}

Nếu muốn hiển thị **Execution Plan** dưới dạng XML:

```sql
SELECT CONVERT(XML, qsp.query_plan) AS query_plan FROM sys.query_store_plan AS qsp;
```

## **5. Quản lý Dung Lượng Query Store**

Query Store sử dụng chung dung lượng với file dữ liệu chính (.mdf). Để kiểm soát dung lượng lưu trữ:

* **Giới hạn dung lượng tối đa**:

  ```sql
  ALTER DATABASE [YourDatabase] SET QUERY_STORE (MAX_STORAGE_SIZE_MB = 500);
  ```
* **Xóa dữ liệu cũ tự động**:

  ```sql
  ALTER DATABASE [YourDatabase] SET QUERY_STORE (CLEANUP_POLICY = (STALE_QUERY_THRESHOLD_DAYS = 30));
  ```
* **Tắt Query Store nếu không cần sử dụng**:

  ```sql
  ALTER DATABASE [YourDatabase] SET QUERY_STORE = OFF;
  ```

## **6. Khi nào nên sử dụng Query Store?**

✅ [**Bật Read Write**](#id-1.-read-write-mac-dinh) khi cần giám sát hiệu suất liên tục.

✅ [**Bật Read Only**](#id-2.-read-only) khi muốn phân tích dữ liệu cũ nhưng không muốn ghi mới.

✅ [**Tắt Query Store**](#id-3.-off) nếu hệ thống gặp vấn đề về tài nguyên hoặc không cần theo dõi truy vấn.

## **7. Kết luận**

Query Store là một công cụ mạnh mẽ giúp theo dõi và tối ưu hóa hiệu suất truy vấn trong SQL Server. Tuy nhiên, bạn cần kiểm soát dung lượng lưu trữ, cấu hình hợp lý để tránh ảnh hưởng đến hiệu suất hệ thống. Nếu được sử dụng đúng cách, Query Store sẽ giúp bạn tiết kiệm thời gian và công sức trong việc quản lý cơ sở dữ liệu.

***

🔥 **Bạn đang sử dụng Query Store như thế nào? Hãy để lại bình luận và chia sẻ kinh nghiệm của bạn!** 🚀


# SQL Server: Error Code


# SQL Server Error : 14151, Severity: 18. Replication agent

SQL Server Error : 14151, Severity: 18. Replication agent

### SQL Server Error : 14151 Details

### Relate errors below

### Cause of Error sql server 14151

### Solution for Resolving the Error SQL Server 14151

```sql

USE distribution;

SELECT * FROM distribution..MSdistribution_agents;
SELECT TOP(100) * FROM distribution..MSdistribution_history ORDER BY time DESC;
SELECT TOP(100) * FROM distribution..MSrepl_errors ORDER BY time DESC;
SELECT TOP(100) * FROM distribution..MSlogreader_history ORDER BY time DESC;
```


# Elasticsearch


# \_reindex


# Tìm hiểu sâu về API \_reindex trong Elasticsearch

API **\_reindex** trong Elasticsearch là một công cụ mạnh mẽ để sao chép hoặc chuyển đổi dữ liệu giữa các index. Bằng cách sử dụng API này, bạn có thể sao chép dữ liệu từ index này sang index khác, thay đổi cấu trúc của dữ liệu trong quá trình sao chép, và thực hiện các thao tác phức tạp khác. Dưới đây là một cái nhìn chi tiết về các tính năng và tùy chọn hỗ trợ trong API `_reindex`.

## 1. **Cấu Trúc Cơ Bản Của API \_Reindex**

Cấu trúc cơ bản của một yêu cầu `_reindex` như sau:

```json
POST _reindex
{
  "source": {
    "index": "source_index",  // Tên index nguồn
    "query": {                 // (Tùy chọn) Truy vấn lọc dữ liệu từ index nguồn
      "match_all": {}
    },
    "size": 1000               // (Tùy chọn) Số lượng tài liệu lấy trong mỗi lần truy vấn
  },
  "dest": {
    "index": "destination_index",  // Tên index đích
    "op_type": "index"             // Phương thức ghi tài liệu vào index đích (mặc định là "index")
  }
}
```

Trong đó:

* **source.index**: Chỉ định index nguồn.
* **source.query**: Câu truy vấn (query) để lọc dữ liệu trong index nguồn.
* **source.size**: Chỉ định số lượng tài liệu mà mỗi lần truy vấn sẽ lấy.
* **dest.index**: Chỉ định index đích mà dữ liệu sẽ được chuyển đến.

## 2. **Các Tùy Chọn Chính Trong API \_Reindex**

Dưới đây là các tùy chọn mà bạn có thể sử dụng trong API `_reindex` để tùy chỉnh hành động sao chép dữ liệu:

### **2.1 `op_type`**

* **Mô tả**: Chỉ định hành động ghi tài liệu vào index đích. Có hai giá trị chính:

  * `index` (mặc định): Tạo mới tài liệu trong index đích hoặc ghi đè tài liệu nếu tài liệu có `_id` trùng với tài liệu đã tồn tại.
  * `create`: Chỉ tạo tài liệu mới nếu tài liệu chưa tồn tại trong index đích. Nếu tài liệu đã tồn tại (có `_id` trùng), nó sẽ trả về lỗi.

  **Ví dụ**:
* ```json
  "op_type": "create"
  ```

### **2.2 `size`**

* **Mô tả**: Chỉ định số lượng tài liệu được lấy trong mỗi lần truy vấn khi di chuyển dữ liệu.
* **Sử dụng**: Nếu bạn có một lượng dữ liệu lớn, bạn có thể muốn điều chỉnh giá trị này để tối ưu hiệu suất.

  **Ví dụ**:
* ```json
  "size": 5000  // Lấy 5000 tài liệu mỗi lần
  ```

### **2.3 `script`**

* **Mô tả**: Sử dụng để thay đổi hoặc xử lý dữ liệu trong quá trình reindex. Bạn có thể áp dụng các script để sửa đổi giá trị của trường hoặc thêm các trường mới vào tài liệu trong quá trình sao chép.

  **Ví dụ**: Thêm một trường mới vào tài liệu trong index đích.
* ```json
  "script": {
    "source": "ctx._source['new_field'] = 'value'"
  }
  ```

### **2.4 `conflicts`**

* **Mô tả**: Xử lý các xung đột khi ghi dữ liệu vào index đích.

  * `abort`: Mặc định, nếu có xung đột, hành động sẽ bị hủy bỏ.
  * `proceed`: Tiếp tục quá trình nếu có xung đột và bỏ qua tài liệu gây xung đột.

  **Ví dụ**:
* ```json
  "conflicts": "proceed"
  ```

### **2.5 `wait_for_completion`**

* **Mô tả**: Chỉ định xem yêu cầu `_reindex` có thực hiện đồng bộ (wait for completion) hay không.

  * `true` (mặc định): Yêu cầu sẽ chờ đợi và trả kết quả khi quá trình reindex hoàn tất.
  * `false`: Yêu cầu sẽ trả ngay kết quả mà không đợi quá trình reindex hoàn tất.

  **Ví dụ**:
* ```json
  "wait_for_completion": false  // Quá trình reindex sẽ không đợi và trả kết quả ngay
  ```

### **2.6 `scroll`**

* **Mô tả**: Tùy chọn này cho phép bạn sử dụng cơ chế **scroll** khi di chuyển một lượng lớn dữ liệu, giúp phân tách việc di chuyển dữ liệu thành nhiều phần nhỏ.

  * `scroll`: Thời gian scroll, ví dụ `10m` (10 phút).

  **Ví dụ**:
* ```json
  "scroll": "10m"  // Chỉ định thời gian scroll là 10 phút
  ```

### **2.7 `routing`**

* **Mô tả**: Chỉ định chiến lược phân phối tài liệu vào các shard khi reindex. Thường được sử dụng khi bạn có shard riêng biệt và muốn điều chỉnh dữ liệu vào shard cụ thể.

  **Ví dụ**:
* ```json
  "routing": "user_id"  // Phân phối tài liệu vào shard dựa trên trường "user_id"
  ```

## 3. **Các Tình Huống Sử Dụng API \_Reindex**

Dưới đây là một số tình huống điển hình khi sử dụng **API \_reindex** trong Elasticsearch:

### **3.1 Di Chuyển Dữ Liệu Giữa Các Index**

Giả sử bạn muốn chuyển toàn bộ dữ liệu từ index `old_index` sang index `new_index`, có thể sử dụng `_reindex` mà không cần bất kỳ truy vấn hay điều kiện đặc biệt nào:

```json
POST _reindex
{
  "source": {
    "index": "old_index"
  },
  "dest": {
    "index": "new_index"
  }
}
```

### **3.2 Di Chuyển Dữ Liệu Với Điều Kiện Lọc**

Bạn có thể chỉ di chuyển một phần dữ liệu đáp ứng điều kiện lọc. Ví dụ, chỉ di chuyển các tài liệu có trường `date` nhỏ hơn ngày **1/1/2021**:

```json
POST _reindex
{
  "source": {
    "index": "old_index",
    "query": {
      "range": {
        "date": {
          "lt": "2021-01-01"
        }
      }
    }
  },
  "dest": {
    "index": "new_index"
  }
}
```

### **3.3 Chỉnh Sửa Dữ Liệu Trong Quá Trình Reindex**

Nếu bạn muốn thay đổi dữ liệu khi di chuyển, có thể sử dụng **script** để thêm hoặc chỉnh sửa các trường trong tài liệu.

```json
POST _reindex
{
  "source": {
    "index": "old_index"
  },
  "dest": {
    "index": "new_index",
    "script": {
      "source": "ctx._source['new_field'] = 'new_value'"
    }
  }
}
```

### **3.4 Reindex Với Điều Kiện Xung Đột**

Khi sử dụng `op_type: create`, bạn có thể gặp phải xung đột nếu tài liệu với `_id` đã tồn tại. Bạn có thể sử dụng tùy chọn `conflicts` để xử lý tình huống này.

```json
POST _reindex
{
  "source": {
    "index": "old_index"
  },
  "dest": {
    "index": "new_index",
    "op_type": "create",
    "conflicts": "proceed"
  }
}
```

## 4. **Tổng Kết**

API **\_reindex** trong Elasticsearch cung cấp nhiều tùy chọn linh hoạt để di chuyển, sao chép và chuyển đổi dữ liệu giữa các index. Các tính năng mạnh mẽ như lọc dữ liệu qua `query`, chỉnh sửa dữ liệu qua `script`, xử lý xung đột qua `conflicts`, và phân phối tài liệu qua `routing` giúp người dùng tối ưu hóa quy trình sao chép dữ liệu trong các môi trường Elasticsearch phức tạp.

Thông qua việc hiểu và sử dụng các tùy chọn này, bạn có thể đảm bảo rằng quá trình di chuyển dữ liệu sẽ diễn ra một cách hiệu quả, an toàn và tối ưu hóa tài nguyên.


# Hướng dẫn di chuyển dữ liệu trong Elasticsearch sử dụng API \_reindex

Elasticsearch là một công cụ mạnh mẽ để lưu trữ và truy vấn dữ liệu lớn. Tuy nhiên, khi bạn cần di chuyển dữ liệu giữa các index trong Elasticsearch, có một số bước cần phải thực hiện. Một trong những trường hợp phổ biến là khi bạn muốn sao chép hoặc di chuyển các tài liệu từ một index cũ sang một index mới, nhưng chỉ với những dữ liệu thỏa mãn điều kiện nhất định (chẳng hạn như dữ liệu có ngày nhỏ hơn một mốc thời gian nhất định). Trong bài viết này, chúng tôi sẽ hướng dẫn bạn cách di chuyển dữ liệu từ một index Elasticsearch sang index khác với điều kiện ngày nhỏ hơn 1/1/2021 sử dụng **API \_reindex**.

## 1. **API \_Reindex là gì?**

API **\_reindex** của Elasticsearch cho phép bạn sao chép dữ liệu từ một index này sang index khác. Đây là một công cụ cực kỳ hữu ích khi bạn muốn thay đổi cấu trúc dữ liệu, di chuyển dữ liệu từ index cũ sang index mới, hoặc thực hiện các thao tác khác mà không cần phải xóa dữ liệu ban đầu.

Điều đặc biệt là API \_reindex không chỉ sao chép toàn bộ dữ liệu mà còn cho phép bạn lọc dữ liệu dựa trên các điều kiện mà bạn đặt ra trong truy vấn, giúp tiết kiệm tài nguyên và đảm bảo rằng chỉ những dữ liệu quan trọng được sao chép.

## 2. **Cấu trúc cơ bản của API \_Reindex**

Cấu trúc của API \_reindex bao gồm ba phần chính:

* **`source`**: Chỉ định index nguồn mà bạn muốn sao chép dữ liệu.
* **`query`**: Đây là phần quan trọng, nơi bạn có thể xác định các điều kiện lọc dữ liệu (chẳng hạn như thời gian, giá trị trường, v.v.).
* **`dest`**: Chỉ định index đích mà bạn muốn di chuyển dữ liệu đến.

## 3. **Sử Dụng API \_Reindex Với Điều Kiện Ngày**

Giả sử bạn có một index có tên là `tbl_slack_message_log` và bạn muốn di chuyển các tài liệu có trường ngày (ví dụ: `date`) nhỏ hơn ngày **1/1/2021** sang một index mới có tên là `tbl_slack_message_log_082024`. Bạn có thể sử dụng API \_reindex như sau:

### **3.1 Cấu Hình Truy Vấn**

Trước tiên, bạn cần chắc chắn rằng trong dữ liệu của bạn có một trường ngày (ví dụ: `date` hoặc `timestamp`) để thực hiện điều kiện lọc. Cấu trúc API \_reindex với điều kiện ngày nhỏ hơn **1/1/2021** sẽ như sau:

```json
POST _reindex
{
  "source": {
    "index": "tbl_slack_message_log",
    "query": {
      "range": {
        "date": {
          "lt": "2021-01-01T00:00:00"  // Điều kiện ngày nhỏ hơn 1/1/2021
        }
      }
    }
  },
  "dest": {
    "index": "tbl_slack_message_log_082024"
  }
}
```

### **3.2 Giải Thích Cấu Trúc Truy Vấn**

* **`source.index`**: Chỉ định index nguồn là `tbl_slack_message_log` nơi chứa dữ liệu ban đầu.
* **`source.query`**: Phần này chứa truy vấn lọc dữ liệu, ở đây chúng ta sử dụng **`range`** để chỉ lấy các tài liệu có trường `date` nhỏ hơn `2021-01-01T00:00:00`.
* **`dest.index`**: Chỉ định index đích mà bạn muốn chuyển dữ liệu đến, trong trường hợp này là `tbl_slack_message_log_082024`.

### **3.3 Lọc Dữ Liệu Theo Trường Khác**

Nếu trường ngày trong dữ liệu của bạn có tên khác, chẳng hạn như `timestamp`, bạn chỉ cần thay đổi trường đó trong truy vấn. Ví dụ, nếu trường ngày của bạn là `timestamp`, truy vấn sẽ như sau:

```json
POST _reindex
{
  "source": {
    "index": "tbl_slack_message_log",
    "query": {
      "range": {
        "timestamp": {
          "lt": "2021-01-01T00:00:00"
        }
      }
    }
  },
  "dest": {
    "index": "tbl_slack_message_log_082024"
  }
}
```

## 4. **Lưu Ý Khi Sử Dụng API \_Reindex**

* **Đảm bảo rằng trường ngày (hoặc timestamp) có định dạng đúng**: Elasticsearch yêu cầu các trường ngày phải có định dạng chuẩn ISO 8601 (ví dụ: `yyyy-MM-dd'T'HH:mm:ss`). Nếu trường ngày của bạn có định dạng khác, bạn cần đảm bảo rằng truy vấn được điều chỉnh phù hợp.
* **Kiểm tra dữ liệu đã di chuyển**: Sau khi chạy API \_reindex, hãy xác nhận rằng dữ liệu đã được di chuyển chính xác sang index mới bằng cách thực hiện truy vấn trên index đích (`tbl_slack_message_log_082024`) để kiểm tra dữ liệu.
* **Hiệu suất**: Trong trường hợp có lượng dữ liệu lớn, hãy chắc chắn rằng cluster của bạn có đủ tài nguyên để xử lý việc reindex mà không gặp phải sự cố về hiệu suất hoặc bộ nhớ.

## 5. **Kết Luận**

Di chuyển dữ liệu từ một index này sang một index khác trong Elasticsearch có thể thực hiện dễ dàng với API \_reindex. Điều này rất hữu ích khi bạn muốn chỉ sao chép một phần dữ liệu dựa trên điều kiện ngày hoặc các tiêu chí khác. Với cú pháp truy vấn linh hoạt, Elasticsearch cho phép bạn thao tác với dữ liệu hiệu quả và nhanh chóng.

Hãy luôn kiểm tra lại dữ liệu sau khi di chuyển để đảm bảo mọi thứ đã được chuyển đổi chính xác. Nếu có vấn đề về hiệu suất khi di chuyển dữ liệu lớn, bạn có thể sử dụng thêm các tùy chọn như `scroll` để phân chia các batch nhỏ hơn trong quá trình di chuyển.

Hy vọng bài viết này đã giúp bạn hiểu rõ hơn về cách sử dụng API \_reindex trong Elasticsearch để di chuyển dữ liệu với các điều kiện lọc. Chúc bạn thành công trong việc quản lý và tối ưu hóa dữ liệu Elasticsearch của mình!


# \_transform


# Cẩm nang Elasticsearch: Bộ câu lệnh giám sát – chẩn đoán – tối ưu mà kỹ sư nào cũng cần

Tài liệu này tổng hợp những câu lệnh thiết yếu nhất trong quá trình vận hành thực tế, kèm theo giải thích rõ ràng và hướng dẫn sử dụng.

Elasticsearch là nền tảng tìm kiếm mạnh mẽ, nhưng để vận hành ổn định và hiệu quả, kỹ sư cần theo dõi liên tục sức khỏe của cluster, hiệu năng tìm kiếm, dung lượng lưu trữ và nhiều thông số quan trọng khác.

Khi hệ thống Elasticsearch bắt đầu lớn dần, chúng ta không chỉ quan tâm đến dữ liệu, mà còn phải theo dõi “sức khỏe” của cluster, hiệu năng tìm kiếm, chỉ số lưu trữ, cấu hình node và rất nhiều yếu tố khác. Bộ câu lệnh dưới đây là những lệnh thực tế, thường xuyên được dùng để giám sát – phân tích – khắc phục sự cố.

<figure><img src="https://raw.githubusercontent.com/nqdev-storage/s3-001/main/gitbook/blogs/cong-nghe/elasticsearch-monitoring-infographic.png" alt="" width="375"><figcaption></figcaption></figure>

Bài viết sẽ giúp bạn hiểu **ý nghĩa – mục đích – khi nào nên sử dụng** từng câu lệnh, để biến việc vận hành Elasticsearch trở nên chủ động và hiệu quả hơn.

***

## **1. Nhóm lệnh \_cat: Giám sát nhanh, trực quan**

Các API `_cat` của Elasticsearch thường trả về dữ liệu dạng bảng rất dễ đọc.

### **1.1 Kiểm tra shards**

```
GET _cat/shards?v=true
```

➡️ Hiển thị danh sách shard, trạng thái, node đang giữ shard.\
Dùng khi: kiểm tra shard bị đỏ, shard unassigned hoặc số shard quá nhiều.

***

### **1.2 Kiểm tra nodes**

```
GET _cat/nodes?v&h=ip,name,heap.percent,ram.percent,uptime,node.role
```

➡️ Xem danh sách node: IP, tên node, % RAM, % heap, role, uptime.\
Dùng khi: cần phát hiện node sắp hết heap, node vừa restart hoặc node bất thường.

***

### **1.3 Kiểm tra indices cơ bản**

```
GET _cat/indices?v&h=index,docs.count,store.size
```

➡️ Xem nhanh số lượng tài liệu và dung lượng mỗi index.

#### Danh sách index nặng nhất:

```
GET _cat/indices?v&s=store.size:desc&bytes=mb
```

➡️ Rất hữu ích khi điều tra index chiếm nhiều dung lượng nhất gây đầy ổ đĩa.

***

## **2. Nhóm lệnh kiểm tra Node Stats**

### **2.1 Thống kê node tổng quát**

```
GET _nodes/stats?pretty
```

➡️ Cung cấp toàn bộ thống kê của node: CPU, RAM, JVM, IO, network…

***

### **2.2 Thống kê chuyên sâu về search**

```
GET _nodes/stats/indices/search
```

➡️ Xem latency search, query time, fetch time.\
Dùng khi: điều tra search chậm.

***

### **2.3 Thông tin của node cụ thể**

```
GET _nodes/esms-node-1/stats?pretty
```

➡️ Hữu ích khi chỉ một node gặp sự cố (latency cao, heap đầy…).

***

### **2.4 Slowlog hiện tại**

```
GET _nodes/slowlog
```

➡️ Lấy danh sách truy vấn chậm đã được Elasticsearch ghi log.

***

### **2.5 Thống kê JVM**

```
GET _nodes/stats/jvm
```

➡️ Dùng để xem GC time, memory pool, heap usage — rất quan trọng trong tuning hiệu năng.

***

### **2.6 Nút “hot thread”**

```
GET _nodes/hot_threads
```

➡️ Hiển thị các thread đang tiêu tốn CPU cao.\
Dùng khi: node bị treo, CPU spike, search chậm bất thường.

***

## **3. Nhóm lệnh \_cluster: Kiểm tra toàn hệ thống**

### **3.1 Tình trạng chung của cluster**

```
GET _cluster/health
```

➡️ Màu sắc (green / yellow / red) phản ánh toàn bộ trạng thái cluster.

***

### **3.2 Thống kê tổng quan**

```
GET _cluster/stats
```

➡️ Số node, index, shard, dung lượng, field types…

***

### **3.3 Xem settings cluster**

```
GET _cluster/settings
GET _cluster/settings?include_defaults=true
```

➡️ Dùng để xem các cấu hình hiện tại hoặc cả giá trị mặc định.

***

### **3.4 Nhiệm vụ đang pending**

```
GET _cluster/pending_tasks
```

➡️ Phát hiện bottleneck trong cluster, đặc biệt khi reallocation chậm.

***

### **3.5 Tổng dung lượng tất cả index**

```
GET _cluster/stats?filter_path=indices.*.size_in_bytes
```

➡️ Trả về **một con số duy nhất** – rất tiện khi monitoring.

***

## **4. Nhóm lệnh thống kê hiệu năng index**

### **4.1 Thống kê tổng quan index**

```
GET _stats
```

***

### **4.2 Kiểm tra cache của từng index**

```
GET _stats?filter_path=indices.*.*.query_cache.memory_size_in_bytes
```

➡️ Hữu ích để đánh giá cache có hoạt động như kỳ vọng không.

***

### **4.3 Kiểm tra lượng dữ liệu lưu trong store**

```
GET _stats/store?filter_path=indices.*.total.store.size_in_bytes
```

***

## **5. Nhóm lệnh Tasks: Theo dõi và xử lý tác vụ**

### **5.1 Xem các tác vụ liên quan đến search**

```
GET /_tasks?detailed=true&actions=*search*&group_by=parents
```

➡️ Dùng khi search bị treo hoặc chiếm tài nguyên lâu.

***

### **5.2 Hủy tất cả task đang chạy**

```
POST /_tasks/_cancel
```

➡️ Cứu cluster khi có truy vấn quá nặng, task lang thang gây nghẽn.

***

## **6. Snapshot & Restore**

```
GET _snapshot/_status?pretty
GET _snapshot/_all?pretty
```

➡️ Dùng khi theo dõi tiến trình snapshot hoặc kiểm tra repository.

***

## **7. Nhóm lệnh Settings của index và cluster**

### **7.1 Xem hoặc thay đổi settings**

```
GET _settings
PUT _settings { ... }
```

➡️ Điều chỉnh giới hạn fields, result window… tùy theo nhu cầu.

Ví dụ tăng giới hạn:

```json
{
  "index.max_result_window": 500000000,
  "index.mapping.total_fields.limit": 100000000
}
```

***

### **7.2 Cài đặt slowlog**

```json
{
  "index.indexing.slowlog.threshold.index.warn": "10s",
  "index.indexing.slowlog.threshold.index.info": "5s",
  "index.indexing.slowlog.threshold.index.debug": "2s",
  "index.indexing.slowlog.threshold.index.trace": "500ms",
  "index.indexing.slowlog.source": "1000"
}
```

➡️ Giúp phát hiện truy vấn hoặc indexing operation chậm.

***

### **7.3 Gỡ block read-only**

```
PUT /_all/_settings
{
  "index.blocks.read_only_allow_delete": null
}
```

➡️ Thường dùng khi cluster bị đầy disk khiến ES tự động khóa chỉ mục.

***

### **7.4 Điều chỉnh watermark tạm thời**

```
PUT _cluster/settings
{
  "transient": {
    "cluster.routing.allocation.disk.watermark.flood_stage": "95%",
    "cluster.routing.allocation.disk.watermark.high": "90%",
    "cluster.routing.allocation.disk.watermark.low": "85%",
    "cluster.info.update.interval": "1m"
  }
}
```

➡️ Cứu cụm tạm thời khi sắp đầy ổ đĩa.

***

## **8. Các lệnh vệ sinh hệ thống**

### **8.1 Xóa cache**

```
POST _cache/clear
```

### **8.2 Xóa toàn bộ scroll context**

```
DELETE _search/scroll/_all
```

➡️ Dùng khi scroll query để lại session nặng gây tăng RAM.

***

## **Kết luận**

Tài liệu này không chỉ liệt kê câu lệnh mà còn cung cấp ý nghĩa và ngữ cảnh sử dụng. Khi bạn nắm vững bộ lệnh này, việc giám sát – tối ưu – xử lý sự cố Elasticsearch trở nên chủ động và tiết kiệm thời gian hơn rất nhiều.


# Operating Systems


# Linux


# Tập lệnh Linux hay dùng

Tập lệnh Linux hay dùng: Nền tảng bắt buộc cho lập trình viên hiện đại

Trong thế giới phát triển phần mềm ngày nay, Linux không còn là lựa chọn phụ mà đã trở thành **hệ điều hành cốt lõi** của server, cloud, container và hệ thống CI/CD. Việc nắm vững các tập lệnh Linux thông dụng giúp lập trình viên **chủ động kiểm soát hệ thống**, xử lý sự cố nhanh và tối ưu hiệu suất một cách bài bản.

Bài viết này trong **Cẩm nang NQDEV** sẽ hệ thống lại các nhóm lệnh Linux quan trọng nhất, không chỉ dừng ở “biết lệnh”, mà hướng tới **hiểu đúng – dùng đúng – dùng hiệu quả** trong thực tế.

***

### 1. Quản lý gói cài đặt – Nền móng của hệ thống Linux

Trên các bản phân phối dựa trên Debian/Ubuntu, `apt-get` là công cụ quản lý gói quen thuộc:

* `apt-get install <package>`\
  → Cài đặt gói phần mềm
* `apt-get remove <package>`\
  → Gỡ bỏ gói đã cài
* `apt-get update`\
  → Cập nhật cơ sở dữ liệu gói (rất quan trọng trước khi cài mới)

> 💡 Lưu ý chiến lược:\
> Mỗi bản phân phối Linux có **trình quản lý gói riêng** (`yum`, `dnf`, `pacman`, `zypper`…). Lập trình viên chuyên nghiệp cần **hiểu tư duy chung**, không chỉ học thuộc một câu lệnh.

***

### 2. Truy vấn thông tin hệ thống – Đọc “sức khỏe” máy chủ

*Static Statistical* - Đây là nhóm lệnh giúp bạn **hiểu hệ thống đang sống hay đang… hấp hối**.

* `uptime` – Thời gian chạy và tải trung bình (load average)
* `free` – Tình trạng bộ nhớ RAM
* `df` – Dung lượng trống của các filesystem
* `du` – Dung lượng thực tế thư mục đang chiếm
* `top` – Danh sách tiến trình tiêu thụ CPU/RAM
* `htop` – Phiên bản nâng cao, trực quan và tương tác hơn
* `iotop` - Disk stats
* `ps -aux` – Liệt kê tiến trình đang chạy
* `lsof` – File nào đang bị process nào “giữ”
* `netstat` – Kết nối mạng, port, routing
* `vmstat` – Thống kê bộ nhớ ảo, swap, I/O

> 🎯 Góc nhìn NQDEV Platform:\
> Khi debug hiệu năng, **đừng nhìn một lệnh đơn lẻ**. Hãy kết hợp `top + free + vmstat` để có cái nhìn toàn cảnh.

***

### 3. Làm việc với thiết bị phần cứng

Nhóm lệnh này cực kỳ quan trọng khi làm việc với server vật lý, VM hoặc troubleshooting phần cứng:

* `lsblk` – Danh sách thiết bị lưu trữ
* `lspci` – Thiết bị PCI (card mạng, GPU…)
* `lsusb` – Thiết bị USB
* `lshw` – Thông tin chi tiết phần cứng
* `lsscsi` – Thiết bị SCSI
* `dmesg` – Nhật ký kernel (vũ khí tối thượng khi lỗi driver)

> 🔍 Tư duy dài hạn:\
> `dmesg` không chỉ là log – nó là **dòng thời gian sự cố của kernel**.

***

### 4. Quản lý ổ lưu trữ và hệ thống tập tin

Đây là khu vực “nguy hiểm nhưng bắt buộc phải biết”:

* `df`, `du`, `lsblk` – Quan sát dung lượng
* `fdisk`, `parted` – Phân vùng ổ đĩa
* `mkfs` – Tạo filesystem
* `mount`, `umount` – Gắn / gỡ ổ lưu trữ
* `fsck` – Kiểm tra và sửa lỗi filesystem
* `gparted` – Công cụ đồ họa (GUI)

> ⚠️ Khuyến nghị:\
> **Luôn backup trước khi dùng `fdisk`, `mkfs`, `parted`**. Một lệnh sai có thể xóa toàn bộ dữ liệu.

***

### 5. Kết nối và làm việc với máy chủ từ xa

Không có Linux hiện đại nếu thiếu kết nối mạng:

* `ssh` – Điều khiển máy chủ từ xa an toàn
* `wget` – Tải file nhanh, gọn
* `curl` – Gửi HTTP request, kiểm thử API

> 🚀 Với DevOps:\
> `ssh + curl` là cặp đôi quyền lực để kiểm tra dịch vụ production mà không cần trình duyệt.

***

### Kết luận: Biết lệnh là một chuyện – làm chủ Linux là chuyện khác

Danh sách lệnh trên không nhằm để học thuộc, mà để xây dựng **tư duy làm việc với hệ điều hành Linux một cách chủ động**. Khi bạn hiểu vì sao dùng lệnh đó, trong ngữ cảnh nào, bạn đã vượt qua mức “người dùng Linux” để tiến gần hơn tới **kỹ sư hệ thống thực thụ**.

👉 Nếu bạn muốn tiếp tục đào sâu Linux theo hướng **lập trình – DevOps – hệ thống**, hãy theo dõi thêm các bài viết tại\
🔗 **Cẩm nang NQDEV**: <https://blogs.nhquydev.net/>

**NQDEV Platform** không chỉ chia sẻ kiến thức, mà hướng bạn đến **cách tư duy dài hạn và bền vững trong nghề công nghệ**.

***

{% code title="Tài liệu tham khảo" lineNumbers="true" %}

```
techmaster.vn
```

{% endcode %}


# Nền tảng tư duy hệ thống mà Dev không thể bỏ qua

Trong hành trình làm việc với Linux, có một ngộ nhận rất phổ biến: *“Chỉ cần biết vài lệnh cơ bản là đủ.”*\
Thực tế, điều tạo nên khác biệt giữa một người **biết dùng Linux** và một Dev **làm chủ hệ thống Linux** không nằm ở số lượng lệnh ghi nhớ, mà nằm ở **cách tư duy đằng sau mỗi lệnh**.

Bài viết về **các lệnh Linux hay dùng** trên [Cẩm nang NQDEV](https://blogs.nhquydev.net/os-linux/tap-lenh-linux-hay-dung) không đơn thuần là một danh sách cheat-sheet. Đây là một bản đồ tư duy giúp Dev hiểu rõ cách hệ điều hành Linux vận hành, tương tác và phản hồi trước từng thao tác.

Trong bài viết này, chúng ta sẽ cùng phân tích và so sánh các nhóm lệnh quan trọng, từ đó nhìn ra điểm mạnh và giá trị thực tiễn mà **Cẩm nang NQDEV** mang lại.

***

### 1. Nhóm lệnh thao tác file & thư mục – Gốc rễ của mọi hệ thống

#### Các lệnh tiêu biểu

`ls`, `cd`, `pwd`, `cp`, `mv`, `rm`, `mkdir`, `tree`

#### Nhìn bề ngoài

Đây là nhóm lệnh “ai cũng biết”, thường xuất hiện trong những ngày đầu làm quen với Linux.

#### Nhìn sâu hơn

Trong cách tiếp cận của **Cẩm nang NQDEV**, nhóm lệnh này được đặt đúng vai trò:\
👉 **File system chính là ngôn ngữ giao tiếp cốt lõi của Linux**.

* Mọi service đều đọc/ghi file
* Mọi cấu hình đều tồn tại dưới dạng text
* Mọi sự cố đều để lại “dấu vết” trong filesystem

Hiểu và thao tác thuần thục nhóm lệnh này giúp Dev:

* Debug nhanh hơn
* Đọc cấu trúc hệ thống chính xác hơn
* Không “mù đường” khi SSH vào server production

***

### 2. Nhóm lệnh xem nội dung & phân tích dữ liệu – Sức mạnh của text-based system

#### Các lệnh tiêu biểu

`cat`, `less`, `more`, `head`, `tail`, `watch`

#### Điểm khác biệt trong cách tiếp cận

Thay vì chỉ dừng lại ở “xem file”, **Cẩm nang NQDEV** định hướng rõ:

> Linux là một hệ điều hành **text-first**, mọi thứ đều có thể phân tích bằng text.

* `tail -f` không chỉ để xem log, mà để **quan sát hành vi runtime**
* `less` không chỉ để đọc file, mà để **điều tra sự cố một cách có chiến lược**
* `watch` giúp biến lệnh tĩnh thành **công cụ giám sát động**

Đây chính là nền tảng cho tư duy SRE, DevOps và Debug production.

***

### 3. Nhóm lệnh tìm kiếm & lọc – Tư duy pipeline đặc trưng của Linux

#### Các lệnh tiêu biểu

`grep`, `find`, `xargs`, `wc`, `sort`, `uniq`

#### So sánh tư duy

| Cách tiếp cận truyền thống | Tư duy Linux            |
| -------------------------- | ----------------------- |
| Mở file → đọc thủ công     | Lọc → kết hợp → tự động |
| Công cụ đơn lẻ             | Pipeline linh hoạt      |
| Phụ thuộc UI               | Chủ động qua CLI        |

Điểm mạnh mà **NQDEV Platform** nhấn mạnh:

* Không học lệnh riêng lẻ
* Học **cách kết hợp lệnh thành pipeline**
* Biến CLI thành công cụ phân tích mạnh mẽ hơn cả GUI

Một Dev hiểu pipeline Linux sẽ:

* Xử lý log vài GB trong vài giây
* Điều tra sự cố mà không cần tool nặng
* Tự động hóa mọi tác vụ lặp lại

***

### 4. Nhóm lệnh quản lý tiến trình & hệ thống – Cửa ngõ đi vào Production

#### Các lệnh tiêu biểu

`ps`, `top`, `htop`, `kill`, `uptime`, `df`, `du`, `free`

#### Giá trị thực tế

Đây là nhóm lệnh phân biệt rõ nhất giữa:

* Dev chỉ code
* Dev hiểu **hệ thống vận hành ngoài đời thực**

**Cẩm nang NQDEV** không dừng ở mô tả cú pháp, mà hướng người đọc đến:

* Nhận diện bottleneck
* Hiểu tài nguyên bị tiêu thụ ở đâu
* Phản xạ nhanh khi hệ thống có vấn đề

Đây là bước đệm bắt buộc để tiến xa hơn sang:

* Debug performance
* Phân tích memory / CPU
* Làm việc với container, cloud và microservices

***

### 5. Giá trị cốt lõi mà Cẩm nang NQDEV mang lại

Điểm khác biệt lớn nhất không nằm ở **lệnh nào**, mà ở **cách học**:

* Không học vẹt
* Không liệt kê máy móc
* Luôn gắn lệnh với **bối cảnh thực tế**

Thông qua bài viết và toàn bộ hệ sinh thái nội dung trên **NQDEV Platform**, người đọc dần hình thành:

* Tư duy hệ thống
* Phản xạ debug
* Khả năng tự học sâu hơn khi gặp vấn đề mới

***

### Kết luận: Lệnh Linux là công cụ – Tư duy mới là đích đến

Các lệnh Linux hay dùng chỉ là điểm khởi đầu.\
Điều quan trọng hơn là cách bạn **nhìn hệ điều hành như một hệ thống sống**, có dòng chảy dữ liệu, có trạng thái và có nguyên nhân – kết quả.

Nếu bạn muốn:

* Hiểu Linux một cách bài bản
* Làm chủ môi trường server, production
* Nâng cấp tư duy Dev lên System Thinking

👉 Hãy bắt đầu từ những bài viết nền tảng tại [**Cẩm nang NQDEV**](https://blogs.nhquydev.net/) và tiếp tục đào sâu cùng **NQDEV Platform**.


# Sơ đồ Linux Filesystem là gì và vì sao Dev cần hiểu?

Linux Path Cheatsheet không đơn thuần là một bảng ghi nhớ thư mục. Thực chất, nó là bản đồ tư duy của toàn bộ hệ điều hành Linux.

Khi làm việc với Linux, rất nhiều lập trình viên bắt đầu bằng việc học lệnh: `ls`, `cd`, `chmod`, `systemctl`, `docker`… Tuy nhiên, không ít người rơi vào tình trạng **“biết gõ lệnh nhưng không hiểu hệ thống”**. Nguyên nhân cốt lõi nằm ở việc bỏ qua **Linux filesystem** – nền tảng mà toàn bộ hệ điều hành vận hành trên đó.

**Linux Path Cheatsheet** không đơn thuần là một bảng ghi nhớ các thư mục như `/bin`, `/etc`, `/var`. Thực chất, nó là **bản đồ tư duy của toàn bộ hệ điều hành Linux**, phản ánh cách kernel, user, service và ứng dụng tương tác với nhau thông qua filesystem.

Trong **Cẩm nang NQDEV**, chúng tôi xem việc hiểu filesystem là **bước chuyển từ “dùng Linux” sang “làm chủ Linux”**.

***

### Linux filesystem – nền móng của mọi câu lệnh

Trong Linux:

* Lệnh là file
* Thiết bị là file
* Thông tin hệ thống cũng là file

Mọi thao tác bạn thực hiện – từ chạy một script, cấu hình server, cho tới debug production – đều xoay quanh việc **đọc, ghi hoặc thực thi file** trong filesystem.

Vì vậy, nếu không hiểu:

* File nằm ở đâu
* Thư mục đó có vai trò gì
* Ai được phép can thiệp vào nó

thì việc dùng lệnh chỉ dừng lại ở mức *thuộc cú pháp*, không phải *hiểu hệ thống*.

***

### Root filesystem `/` – gốc rễ của toàn bộ hệ điều hành

Linux không có ổ đĩa kiểu C:, D:.\
Mọi thứ bắt đầu từ **root `/`**.

Sơ đồ Linux Filesystem cho thấy từ `/` tỏa ra các nhánh, mỗi nhánh đảm nhiệm **một trách nhiệm duy nhất**, không chồng chéo và không ngẫu nhiên.

Đây là điểm khác biệt cốt lõi giữa Linux và nhiều hệ điều hành khác:\
👉 **Cấu trúc phản ánh tư duy thiết kế, không chỉ là cách lưu trữ.**

***

### Nhóm thư mục thực thi: nơi các lệnh bạn dùng hằng ngày “sống”

#### `/bin` – Command binaries

Chứa các lệnh cơ bản:

* `ls`, `cp`, `mv`, `cat`
* `chmod`, `chown`

Những lệnh quen thuộc trong bài\
👉 **Tập lệnh Linux hay dùng – Cẩm nang NQDEV**\
thực chất là các file thực thi nằm trong `/bin`.

Điều này giúp bạn hiểu rằng:

> Khi gõ một lệnh, Linux chỉ đang chạy một file cụ thể trong filesystem.

***

#### `/sbin` – System binaries

Dành cho các lệnh quản trị:

* `mount`, `ip`, `reboot`
* `fsck`, `shutdown`

Sai lầm phổ biến của Dev mới là dùng các lệnh trong `/sbin` mà không hiểu hậu quả, dẫn tới lỗi hệ thống hoặc downtime.

***

### `/etc` – nơi quyết định hệ thống vận hành ra sao

Nếu `/bin` là nơi lệnh nằm, thì `/etc` là nơi **lệnh nghe theo**.

Toàn bộ cấu hình hệ thống:

* Web server
* Database
* SSH
* Cron\
  đều tập trung tại đây.

Trong tư duy của **NQDEV Platform**:

> Hiểu `/etc` quan trọng hơn nhớ thêm 10 câu lệnh mới.

***

### Không gian người dùng: `/home` và `/root`

* `/home`: môi trường làm việc an toàn cho user
* `/root`: home của superuser, quyền lực tuyệt đối

Một Dev có tư duy hệ thống sẽ:

* Viết code, test script trong `/home`
* Chỉ dùng `/root` khi thật sự cần

Đây là ranh giới giữa **làm việc an toàn** và **phá hệ thống trong im lặng**.

***

### `/proc` và `/sys` – Linux ở tầng sâu hơn

Hai thư mục này không chứa file thật, mà là **filesystem ảo do kernel tạo ra**.

* `/proc`: thông tin CPU, RAM, process
* `/sys`: thiết bị, driver, power

Các lệnh như `top`, `free`, `uptime` không “tự đoán” thông tin, mà **đọc dữ liệu trực tiếp từ đây**.

👉 Hiểu `/proc` giúp bạn debug hiệu năng như một system engineer thực thụ.

***

### `/var` và `/tmp` – nơi dữ liệu thay đổi liên tục

* `/var`: log, cache, runtime data
* `/tmp`: file tạm, có thể bị xóa sau reboot

Rất nhiều sự cố production xuất phát từ việc:

* Không kiểm soát log trong `/var/log`
* Lưu nhầm dữ liệu quan trọng trong `/tmp`

***

### Vì sao Dev nên học Linux filesystem sớm?

Hiểu Linux filesystem giúp bạn:

* Dùng lệnh đúng ngữ cảnh
* Tránh thao tác nguy hiểm
* Debug nhanh hơn
* Tư duy hệ thống tốt hơn khi làm DevOps, Backend, Cloud

Trong **Cẩm nang NQDEV**, chúng tôi không khuyến khích học Linux theo kiểu:

> Thuộc lệnh → xong

Mà theo hướng:

> **Filesystem → Lệnh → Service → Tự động hóa**

***

### Kết luận

**Linux Path Cheatsheet** không phải để học thuộc, mà để:

* Nhìn vào là hiểu hệ thống đang vận hành thế nào
* Biết lệnh mình chạy sẽ tác động tới đâu
* Làm việc với Linux một cách tự tin, có kiểm soát

Để kết nối lý thuyết với thực hành, bạn nên đọc song song:\
👉 **Tập lệnh Linux hay dùng**\
🔗 <https://blogs.nhquydev.net/os-linux/tap-lenh-linux-hay-dung>

Khám phá thêm nhiều bài nền tảng khác tại:\
🔗 <https://blogs.nhquydev.net/>

**Cẩm nang NQDEV** – xây nền tảng vững chắc để đi đường dài với Linux và hệ thống.


# Centos 7


# Hướng dẫn cài đặt và cấu hình Centos 7 dành cho người mới bắt đầu

## **Giới thiệu**

VPS (Virtual Private Server) là một giải pháp lưu trữ được nhiều cá nhân và doanh nghiệp sử dụng để triển khai các ứng dụng, website, hoặc hệ thống. Đặc biệt, CentOS 7 là một trong những hệ điều hành phổ biến nhờ tính ổn định và bảo mật. Bài viết này sẽ hướng dẫn bạn từng bước cài đặt và cấu hình VPS CentOS 7 một cách an toàn và hiệu quả.

***

## 1. **Chuẩn Bị Trước Khi Bắt Đầu**

Trước khi tiến hành cài đặt và cấu hình, bạn cần chuẩn bị:

* **Thông tin đăng nhập VPS**: IP, tài khoản root, mật khẩu hoặc SSH key.
* **Phần mềm quản lý kết nối SSH**: Có thể sử dụng [PuTTY](https://putty.org/) (Windows) hoặc Terminal (Linux/Mac).
* **Kiến thức cơ bản về lệnh Linux**: Để thao tác dễ dàng hơn trong môi trường dòng lệnh.

***

## 2. **Kết Nối VPS**

1. Mở PuTTY (hoặc Terminal).
2. Nhập địa chỉ IP VPS và chọn **Port 22** (cổng mặc định của SSH).
3. Đăng nhập bằng tài khoản `root` và nhập mật khẩu đã được cung cấp.

📌 **Lưu ý**: Đổi mật khẩu mặc định sau khi đăng nhập lần đầu để tăng cường bảo mật.

```bash
passwd
```

***

## 3. **Cập Nhật Hệ Thống**

Việc cập nhật đảm bảo bạn có các bản vá lỗi và bảo mật mới nhất. Chạy các lệnh sau:

```bash
yum update -y
yum upgrade -y
```

***

## 4. **Cấu Hình Tường Lửa (Firewall)**

Tường lửa giúp bảo vệ VPS khỏi các truy cập trái phép. Cài đặt và cấu hình cơ bản với Firewalld:

1. Kích hoạt Firewalld:

   ```bash
   systemctl start firewalld
   systemctl enable firewalld
   ```
2. Mở các cổng cần thiết (ví dụ: HTTP, HTTPS, SSH):

   ```bash
   firewall-cmd --permanent --add-service=http
   firewall-cmd --permanent --add-service=https
   firewall-cmd --permanent --add-service=ssh
   firewall-cmd --reload
   ```

***

## 5. **Cài Đặt Các Gói Cần Thiết**

Một số gói cơ bản cần thiết cho quản trị hệ thống:

```bash
yum install wget curl nano vim -y
```

***

## 6. **Tạo Người Dùng Mới và Phân Quyền**

Không nên sử dụng tài khoản root để quản trị hàng ngày. Hãy tạo một tài khoản người dùng mới:

```bash
adduser myuser
passwd myuser
usermod -aG wheel myuser
```

📌 **Chuyển đổi quyền**: Dùng lệnh `sudo` khi cần quyền root.

***

## 7. **Cài Đặt Dịch Vụ Web (Apache/Nginx)**

### **Với Apache:**

1. Cài đặt:

   ```bash
   yum install httpd -y
   ```
2. Khởi động dịch vụ:

   ```bash
   systemctl start httpd
   systemctl enable httpd
   ```
3. Kiểm tra hoạt động: Truy cập `http://<IP-VPS>`.

### **Với Nginx:**

1. Cài đặt:

   ```bash
   yum install nginx -y
   ```
2. Khởi động dịch vụ:

   ```bash
   systemctl start nginx
   systemctl enable nginx
   ```

***

## 8. **Tăng Cường Bảo Mật VPS**

### **Tắt đăng nhập bằng root qua SSH**:

#### Tìm và sửa dòng:

```bash
nano /etc/ssh/sshd_config
```

#### Sửa file cấu hình SSH:

```bash
PermitRootLogin no
```

#### Sau đó, khởi động lại SSH:

```bash
systemctl restart sshd
```

### **Cài đặt Fail2Ban** để ngăn chặn brute-force:

```bash
yum install epel-release -y
yum install fail2ban -y
systemctl start fail2ban
systemctl enable fail2ban
```

***

## 9. **Sao Lưu và Quản Lý VPS**

Hãy thường xuyên sao lưu dữ liệu bằng cách sử dụng các công cụ như `rsync` hoặc các giải pháp cloud backup.

***

## Kết Luận

Bài viết trên đã hướng dẫn bạn cài đặt và cấu hình VPS CentOS 7 từ cơ bản đến nâng cao. Việc bảo mật và duy trì hệ thống là yếu tố then chốt để VPS của bạn hoạt động ổn định. Nếu bạn gặp khó khăn, hãy để lại bình luận trên blog [Cẩm nang NQDEV](/), chúng tôi sẽ hỗ trợ bạn kịp thời!

Chúc bạn thành công! 🚀


# Hướng Dẫn Kiểm Tra Các Cổng Đang Mở Trên Hệ Thống CentOS

Khi quản trị hệ thống Linux, việc kiểm tra các cổng mạng đang mở là một tác vụ quan trọng để theo dõi và đảm bảo an ninh.

Trên CentOS, bạn có thể sử dụng nhiều công cụ như `ss`, `netstat`, `lsof`, `firewalld` và `nmap` để xem các cổng nào đang lắng nghe (listening) và đảm bảo rằng các dịch vụ không mong muốn không hoạt động. Dưới đây là các phương pháp phổ biến để thực hiện điều này.

### **1. Sử Dụng `ss` (Socket Statistics)**

`ss` là công cụ tích hợp sẵn trong các hệ thống Linux hiện đại, bao gồm CentOS, và là lựa chọn thay thế cho `netstat`. Công cụ này cho phép bạn xem nhanh các kết nối mạng và các cổng đang mở.

* **Lệnh**:
* ```bash
  ss -tuln
  ```
* **Ý nghĩa của các tùy chọn**:
  * `-t`: Liệt kê các kết nối TCP.
  * `-u`: Liệt kê các kết nối UDP.
  * `-l`: Chỉ liệt kê các cổng đang lắng nghe (listening).
  * `-n`: Hiển thị địa chỉ IP và cổng dưới dạng số, không phân giải tên miền hoặc tên dịch vụ.

Ví dụ, sau khi chạy lệnh này, kết quả có thể trông như sau:

```plaintext
State    Recv-Q   Send-Q   Local Address:Port     Peer Address:Port
LISTEN   0        128      *:80                   *:*
LISTEN   0        128      *:22                   *:*
```

### **2. Sử Dụng `netstat`**

`netstat` là công cụ quen thuộc với nhiều quản trị viên hệ thống để kiểm tra các kết nối mạng và các cổng đang mở. Tuy nhiên, `netstat` có thể không được cài đặt sẵn trên CentOS, đặc biệt là các phiên bản mới hơn. Trong trường hợp này, bạn có thể cài đặt `net-tools` để có lệnh `netstat`.

* **Lệnh**:
* ```bash
  netstat -nutpl
  ```

Lệnh này cho ra kết quả tương tự như `ss`, hiển thị danh sách các cổng đang lắng nghe. Nếu chưa cài `netstat`, bạn có thể cài đặt qua lệnh:

* ```bash
  netstat -nutpl
  ```

Lệnh này cho ra kết quả tương tự như `ss`, hiển thị danh sách các cổng đang lắng nghe. Nếu chưa cài `netstat`, bạn có thể cài đặt qua lệnh:

```bash
sudo yum install net-tools
```

### **3. Sử Dụng `lsof` (List Open Files)**

`lsof` là công cụ mạnh mẽ có thể liệt kê tất cả các tệp và kết nối mở trên hệ thống, bao gồm các kết nối mạng.

* **Lệnh**:
* ```bash
  lsof -i -n
  ```
* **Ý nghĩa của các tùy chọn**:
  * `-i`: Liệt kê tất cả các kết nối mạng.
  * `-n`: Không phân giải tên miền hoặc địa chỉ IP, chỉ hiển thị các địa chỉ IP và cổng dưới dạng số.

Kết quả sẽ hiển thị danh sách các dịch vụ đang nghe trên các cổng mạng, ví dụ:

```sql
$ netstat -nutpl
Active Internet connections (only servers)
Proto Recv-Q Send-Q Local Address           Foreign Address         State       PID/Program name
tcp6       0      0 :::9100                 :::*                    LISTEN      1419/node_exporter
udp6       0      0 ::1:323                 :::*                                997/chronyd
```

### **4. Sử Dụng `firewalld` (Tường Lửa Mặc Định Trên CentOS)**

Nếu bạn sử dụng `firewalld` - công cụ quản lý tường lửa mặc định trên CentOS 7 và các phiên bản mới hơn, bạn có thể dễ dàng liệt kê các dịch vụ và cổng được phép qua tường lửa.

* **Lệnh**:
* ```bash
  sudo firewall-cmd --list-ports
  ```

Lệnh này sẽ trả về danh sách các cổng đang mở trong tường lửa. Ví dụ, kết quả có thể như sau:

```plaintext
80/tcp 22/tcp
```

### **5. Sử Dụng** `iptables`

Để liệt kê các quy tắc (rules) trong `iptables`, bạn có thể sử dụng lệnh:

```bash
sudo iptables -L -n -v
```

* `-L` : Liệt kê các quy tắc trong tường lửa.
* `-n` : Hiển thị địa chỉ IP và cổng dưới dạng số, không phân giải tên miền.
* `-v` : Hiển thị chi tiết về số lượng kết nối và lưu lượng mạng qua các quy tắc.

Kết quả sẽ trông giống như sau:

```sql
Chain INPUT (policy ACCEPT 1234 packets, 23456 bytes)
 pkts bytes target     prot opt in     out     source               destination         
 1234  23456 ACCEPT     all  --  *      *       0.0.0.0/0            0.0.0.0/0            state RELATED,ESTABLISHED
 5678  67890 ACCEPT     tcp  --  *      *       0.0.0.0/0            0.0.0.0/0            tcp dpt:22
 4321  12345 ACCEPT     tcp  --  *      *       0.0.0.0/0            0.0.0.0/0            tcp dpt:80
```

Ở đây, cổng 22 (SSH) và cổng 80 (HTTP) đang mở và được phép qua firewall. Bạn có thể tìm thấy các cổng mà bạn muốn kiểm tra trong các mục `dpt:<port_number>`.

### **6. Sử Dụng `nmap` (Network Mapper)**

`nmap` là công cụ mạnh mẽ giúp quét các cổng và khám phá các dịch vụ mạng trên một thiết bị. Tuy nhiên, `nmap` có thể không được cài đặt sẵn, bạn có thể cài đặt bằng lệnh:

```bash
sudo yum install nmap
```

* **Lệnh quét cổng trên localhost**:
* ```bash
  nmap -sT -O localhost
  ```
* **Ý nghĩa của các tùy chọn**:
  * `-sT`: Thực hiện quét kết nối TCP.
  * `-O`: Thử nhận diện hệ điều hành của máy chủ.

Lệnh này sẽ liệt kê các cổng đang mở trên máy chủ và các dịch vụ đang chạy. Đây là cách dễ dàng để kiểm tra bảo mật cổng mạng khi bạn quản trị nhiều dịch vụ trên một hệ thống CentOS.

## Tóm Tắt Các Lệnh Chính

| Công Cụ       | Lệnh                             | Mục Đích                                                  |
| ------------- | -------------------------------- | --------------------------------------------------------- |
| **ss**        | `ss -tuln`                       | Liệt kê các cổng TCP và UDP đang mở                       |
| **netstat**   | `netstat -tuln`                  | Liệt kê cổng đang mở (cần cài `net-tools`)                |
| **lsof**      | `lsof -i -n`                     | Liệt kê tất cả các kết nối mạng đang mở                   |
| **firewalld** | `sudo firewall-cmd --list-ports` | Liệt kê các cổng mở trong firewall                        |
| **nmap**      | `nmap -sT -O localhost`          | Quét cổng mở trên máy tính và phát hiện dịch vụ đang chạy |

## Kết Luận

Qua hướng dẫn trên, bạn có thể dễ dàng kiểm tra và quản lý các cổng mạng đang mở trên hệ thống CentOS, từ đó giúp bảo vệ hệ thống khỏi các lỗ hổng bảo mật. Lựa chọn công cụ phù hợp phụ thuộc vào nhu cầu cụ thể của bạn, như kiểm tra nhanh hay quét toàn diện. Hy vọng các phương pháp này sẽ hỗ trợ bạn quản lý và đảm bảo an ninh mạng hiệu quả hơn!


# Hướng Dẫn Sử Dụng zip Trên CentOS

Với bài viết này, bạn có thể chia sẻ cho đồng nghiệp của mình những kỹ năng cần thiết để làm việc hiệu quả với các file nén trên CentOS.

Trong bài viết này, chúng ta sẽ học cách sử dụng công cụ `zip` trên hệ điều hành CentOS để nén và giải nén các file. `zip` là một công cụ nén phổ biến giúp giảm kích thước file và tổ chức dữ liệu một cách gọn gàng. Hãy làm theo các bước dưới đây để sử dụng `zip` một cách hiệu quả.

## 1. Cài Đặt Công Cụ `zip`

Trước khi có thể sử dụng `zip`, bạn cần chắc chắn rằng công cụ này đã được cài đặt trên hệ thống của mình. Trên CentOS, công cụ `zip` có thể được cài đặt thông qua công cụ quản lý gói `yum` (hoặc `dnf` nếu bạn đang sử dụng CentOS 8 hoặc cao hơn).

### **Cài Đặt `zip` trên CentOS 7 hoặc thấp hơn:**

Mở terminal và chạy lệnh sau để cài đặt `zip`:

```bash
sudo yum install zip
```

### **Cài Đặt `zip` trên CentOS 8 hoặc cao hơn:**

Nếu bạn đang sử dụng CentOS 8 hoặc một phiên bản cao hơn, bạn có thể cài đặt `zip` bằng lệnh:

```bash
sudo dnf install zip
```

## 2. Cách Nén File Với `zip`

Sau khi cài đặt xong, bạn có thể bắt đầu sử dụng công cụ `zip` để nén các file và thư mục. Dưới đây là một số ví dụ cơ bản về cách sử dụng `zip`.

### **Nén Một File Đơn**

Để nén một file duy nhất, bạn sử dụng cú pháp sau:

```bash
zip [tên_file_nén].zip [tên_file_cần_nén]
```

Ví dụ, để nén file `file1.txt` thành file `file1.zip`, bạn thực hiện lệnh sau:

```bash
zip file1.zip file1.txt
```

### **Nén Nhiều File Vào Một File `.zip`**

Để nén nhiều file vào một file `.zip` duy nhất, bạn có thể liệt kê tất cả các file cần nén:

```bash
zip [tên_file_nén].zip [tên_file_1] [tên_file_2] [tên_file_3]
```

#### Ví dụ:

```bash
zip files.zip file1.txt file2.txt file3.txt
```

### **Nén Một Thư Mục**

Để nén một thư mục và tất cả các file con bên trong thư mục đó, bạn sử dụng tùy chọn `-r` (đệ quy). Cú pháp:

```bash
zip -r [tên_file_nén].zip [tên_thư_mục]
```

#### Ví dụ:

Để nén thư mục `my_folder` thành file `my_folder.zip`, bạn chạy lệnh sau:

```bash
zip -r my_folder.zip my_folder/
```

## 3. Giải Nén File `.zip` Với `unzip`

Để giải nén một file `.zip`, bạn sử dụng công cụ `unzip`. Dưới đây là cách giải nén một file:

### **Giải Nén Một File `.zip`**

Cú pháp đơn giản để giải nén file `.zip`:

```bash
unzip [tên_file_nén].zip
```

Ví dụ, để giải nén file `files.zip`:

```bash
unzip files.zip
```

### **Giải Nén File Đến Thư Mục Cụ Thể**

Bạn có thể chỉ định thư mục đích để giải nén các file vào đó bằng cách sử dụng tùy chọn `-d`:

```bash
unzip [tên_file_nén].zip -d [đường_dẫn_thư_mục]
```

Ví dụ, để giải nén `files.zip` vào thư mục `/home/user/backup/`:

```bash
unzip files.zip -d /home/user/backup/
```

## 4. Các Tùy Chọn Thông Dụng Khi Sử Dụng `zip`

* **-r**: Nén thư mục và tất cả các file con bên trong.
* **-e**: Mã hóa file nén (yêu cầu mật khẩu khi giải nén).
* **-q**: Tắt thông báo trong quá trình nén.
* **-9**: Sử dụng mức độ nén cao nhất (nén tốt hơn nhưng tốn thời gian hơn).

Ví dụ về việc sử dụng các tùy chọn này:

```bash
zip -r -9 my_folder.zip my_folder/
```

## 5. Lưu Ý Quan Trọng

* Đảm bảo rằng bạn có quyền đọc và ghi đối với các file và thư mục mà bạn đang cố gắng nén hoặc giải nén.
* Khi sử dụng tùy chọn mã hóa (`-e`), bạn sẽ cần nhập mật khẩu khi giải nén file. Điều này giúp bảo vệ dữ liệu bên trong file `.zip` khỏi việc truy cập trái phép.

## Kết Luận

Công cụ `zip` rất hữu ích trong việc nén và giải nén file trên CentOS. Bài viết này đã hướng dẫn bạn các bước cơ bản để sử dụng `zip` trong các tình huống khác nhau. Hy vọng rằng bạn sẽ tìm thấy các lệnh này hữu ích trong công việc hàng ngày. Chúc bạn thành công!


# Hướng dẫn cấu hình iptables để mở tất cả các cổng cho IP private

Trong bài viết này, chúng ta sẽ tìm hiểu cách sử dụng **iptables** để cấu hình hệ thống mở tất cả các cổng cho một dải địa chỉ IP private (thường là địa chỉ trong mạng nội bộ). Đây là một bước quan trọng khi bạn muốn đảm bảo rằng các thiết bị hoặc máy chủ trong mạng nội bộ của mình có thể truy cập vào tất cả các cổng của hệ thống mà không gặp phải bất kỳ sự hạn chế nào từ tường lửa.

## **1. Giới thiệu về `iptables`**

`iptables` là một công cụ tường lửa mạnh mẽ được sử dụng để cấu hình và quản lý các quy tắc tường lửa trên hệ thống Linux. Bạn có thể sử dụng `iptables` để lọc và kiểm soát các kết nối mạng đến và đi từ máy tính của mình, bao gồm việc cho phép hoặc từ chối kết nối từ các dải địa chỉ IP cụ thể.

Trong ví dụ này, chúng ta sẽ cấu hình để mở tất cả các cổng từ một dải địa chỉ IP private, ví dụ như `192.168.1.0/24`.

## **2. Mở tất cả các cổng cho mạng IP private**

Để cho phép tất cả các kết nối từ một mạng nội bộ (IP private) vào tất cả các cổng trên máy chủ của bạn, bạn cần sử dụng lệnh `iptables` để tạo các quy tắc cho phép tất cả các kết nối từ dải IP đó.

Giả sử mạng của bạn có dải địa chỉ `192.168.1.0/24`, bạn có thể thực hiện như sau:

### **Bước 1: Mở tất cả các kết nối TCP từ mạng nội bộ**

```bash
sudo iptables -A INPUT -p tcp -s 192.168.1.0/24 -j ACCEPT
```

Quy tắc trên sẽ cho phép tất cả các kết nối TCP (ví dụ, HTTP, HTTPS) từ địa chỉ IP trong mạng `192.168.1.0/24` vào hệ thống của bạn.

### **Bước 2: Mở tất cả các kết nối UDP từ mạng nội bộ**

```bash
sudo iptables -A INPUT -p udp -s 192.168.1.0/24 -j ACCEPT
```

Nếu bạn muốn cho phép các kết nối UDP (ví dụ, DNS, NTP) từ mạng nội bộ, bạn cũng cần thêm quy tắc này.

### **Bước 3: Mở tất cả các kết nối từ mạng nội bộ vào tất cả các cổng**

Nếu bạn muốn mở tất cả các cổng cho mọi loại kết nối (TCP, UDP, ICMP, etc.) từ dải IP `192.168.1.0/24`, bạn có thể sử dụng quy tắc chung sau:

```bash
sudo iptables -A INPUT -s 192.168.1.0/24 -j ACCEPT
```

Quy tắc này sẽ cho phép mọi loại kết nối từ mạng nội bộ mà không cần phải chỉ định từng loại giao thức cụ thể.

## **3. Chặn các kết nối từ các IP khác (nếu cần)**

Nếu bạn chỉ muốn cho phép kết nối từ mạng nội bộ và chặn tất cả các kết nối từ ngoài mạng nội bộ, bạn có thể tạo các quy tắc để từ chối các kết nối không phải từ mạng `192.168.1.0/24`.

Ví dụ, để chặn các kết nối từ bên ngoài vào các cổng HTTP (80), HTTPS (443), và cổng quản trị (81), bạn có thể sử dụng các lệnh sau:

```bash
sudo iptables -A INPUT -p tcp --dport 80 -j REJECT
sudo iptables -A INPUT -p tcp --dport 443 -j REJECT
sudo iptables -A INPUT -p tcp --dport 81 -j REJECT
```

Những quy tắc này sẽ từ chối các kết nối đến các cổng `80`, `443`, và `81` từ các địa chỉ IP không phải trong dải `192.168.1.0/24`.

## **4. Lưu lại cấu hình iptables**

Sau khi bạn đã cấu hình xong các quy tắc tường lửa, điều quan trọng là phải lưu lại chúng để không bị mất khi hệ thống khởi động lại.

* **Trên các hệ thống Ubuntu/Debian sử dụng `iptables-persistent`**, bạn có thể lưu các quy tắc với lệnh sau:

```bash
sudo netfilter-persistent save
```

* **Trên các hệ thống CentOS/RHEL**, bạn có thể sử dụng:

```bash
sudo service iptables save
```

* **Trên các hệ thống sử dụng `iptables-save`**, bạn có thể lưu trực tiếp các quy tắc vào file cấu hình:

```bash
sudo iptables-save > /etc/iptables/rules.v4
```

## **5. Kiểm tra lại các quy tắc iptables**

Sau khi lưu cấu hình, bạn có thể kiểm tra lại các quy tắc đã được áp dụng với lệnh:

```bash
sudo iptables -L
```

Lệnh này sẽ liệt kê tất cả các quy tắc hiện tại của `iptables`, giúp bạn xác nhận rằng các kết nối từ mạng nội bộ đã được mở và các kết nối từ bên ngoài đã bị chặn.

### 5.1 Kiểm tra iptables hiện tại

Chạy lệnh:

```bash
sudo iptables -L INPUT -n -v --line-numbers
```

Xem:

* **Chain INPUT** có policy là **ACCEPT** hay **DROP**.
* Có quy tắc nào cho phép cổng **445** (tcp) không.
* Nếu policy DROP mà không có quy tắc cho phép thì kết nối bị chặn.

Ví dụ output mong muốn có dòng:

```bash
ACCEPT     tcp  --  0.0.0.0/0            0.0.0.0/0            tcp dpt:445
```

***

## **6. Kết luận**

Bằng cách sử dụng các quy tắc `iptables`, bạn có thể dễ dàng mở tất cả các cổng cho một mạng IP private (ví dụ: `192.168.1.0/24`) và kiểm soát các kết nối đến hệ thống của mình. Điều này rất hữu ích trong các môi trường mạng nội bộ, nơi bạn muốn cho phép các thiết bị hoặc máy chủ trong mạng truy cập vào tất cả các dịch vụ của hệ thống mà không bị gián đoạn bởi tường lửa.

Nhớ rằng, luôn luôn kiểm tra lại các quy tắc và lưu lại chúng để đảm bảo rằng chúng sẽ không bị mất sau khi hệ thống khởi động lại.


# Các lệnh xem ổ đĩa trên CentOS / Linux

Hướng dẫn các lệnh xem ổ đĩa trên CentOS/Linux: df -h, lsblk, fdisk -l và du -sh kèm ví dụ output, bảng so sánh và mẹo vặt.

Khi quản trị VPS hoặc máy chủ CentOS, kiểm tra ổ đĩa là tác vụ gần như hằng ngày: xem còn bao nhiêu dung lượng trống, phân vùng nào đang đầy, ổ cứng nào đang gắn trên hệ thống. Bài viết này tổng hợp 4 lệnh cốt lõi mà bạn cần nắm chắc: `df -h`, `lsblk`, `fdisk -l` và `du -sh` — kèm ví dụ output thực tế và gợi ý dùng lệnh nào cho từng tình huống.

## Khi Nào Cần Xem Ổ Đĩa?

* **Website/Service báo lỗi `No space left on device`:** Cần `df -h` để xác định phân vùng nào đang đầy.
* **Cần biết hệ thống đang có những ổ cứng, phân vùng nào:** Dùng `lsblk` để xem tổng quan dạng cây.
* **Cần chi tiết bảng phân vùng, sector, loại GPT/MBR:** Dùng `fdisk -l`.
* **Cần tìm thư mục nào đang "ngốn" nhiều dung lượng:** Dùng `du -sh` kết hợp `sort`.

## Tổng Quan Nhanh Các Lệnh

| Lệnh       | Chức năng chính                                                 | Cần root?   |
| ---------- | --------------------------------------------------------------- | ----------- |
| `df -h`    | Dung lượng đã dùng và còn trống của các phân vùng đang mount    | Không       |
| `lsblk`    | Danh sách ổ đĩa và phân vùng dạng cây phân cấp                  | Không       |
| `fdisk -l` | Chi tiết tất cả ổ cứng và bảng phân vùng (sector, boot flag...) | Có          |
| `du -sh`   | Dung lượng thực tế mà một thư mục cụ thể chiếm dụng             | Tùy thư mục |

## 1. `df -h` — Xem Dung Lượng Đã Dùng Và Còn Trống

`df` (disk free) hiển thị dung lượng trên các filesystem đang được mount. Tùy chọn `-h` (human-readable) giúp hiển thị kích thước theo định dạng dễ đọc như GB, MB thay vì số block thô.

{% code title="Xem dung lượng các phân vùng đang mount" overflow="wrap" lineNumbers="true" %}

```bash
df -h
```

{% endcode %}

Ví dụ output:

{% code title="Output của df -h" overflow="wrap" %}

```plaintext
Filesystem      Size  Used Avail Use% Mounted on
/dev/sda2        75G   23G   49G  32% /
/dev/sda5        24G   22G  1.2G  95% /home
/dev/sda3        29G   25G  2.6G  91% /data
/dev/sda1       289M   22M  253M   8% /boot
tmpfs           252M    0   252M   0% /dev/shm
```

{% endcode %}

* **Filesystem:** Tên device hoặc filesystem (ví dụ `/dev/sda2`, `tmpfs`).
* **Size:** Tổng dung lượng của phân vùng.
* **Used:** Dung lượng đã sử dụng.
* **Avail:** Dung lượng còn trống.
* **Use%:** Phần trăm đã sử dụng — chú ý phân vùng nào gần 100%.
* **Mounted on:** Điểm mount (thư mục gốc của phân vùng).

### Các tùy chọn hữu ích

* **-T (--print-type):** Hiển thị thêm cột Type (xfs, ext4, tmpfs...) — rất hữu ích khi cần biết filesystem đang dùng.
* **-i (--inodes):** Hiển thị thông tin inode thay vì dung lượng — dùng khi nghi ngờ hết inode.
* **-t TYPE:** Chỉ hiển thị filesystem loại TYPE, ví dụ `df -t xfs`.
* **-x TYPE:** Loại trừ loại filesystem, ví dụ `df -x tmpfs` để bỏ qua tmpfs cho output gọn hơn.

{% code title="Kết hợp nhiều tùy chọn" overflow="wrap" lineNumbers="true" %}

```bash
df -hT
df -h -x tmpfs -x devtmpfs
```

{% endcode %}

{% code title="Output của df -hT" overflow="wrap" %}

```plaintext
Filesystem     Type      Size  Used Avail Use% Mounted on
/dev/sda2      xfs        75G   23G   49G  32% /
/dev/sda1      xfs       289M   22M  253M   8% /boot
```

{% endcode %}

{% hint style="info" %}
`df` chỉ thống kê các filesystem **đang mount**, không phải dung lượng vật lý của ổ cứng. Muốn xem cấu trúc ổ cứng thực tế, hãy dùng `lsblk` hoặc `fdisk -l`.
{% endhint %}

## 2. `lsblk` — Xem Danh Sách Ổ Đĩa Và Phân Vùng Dạng Cây

`lsblk` (list block devices) đọc thông tin trực tiếp từ kernel và hiển thị danh sách ổ đĩa cùng phân vùng dưới dạng cây phân cấp trực quan — ổ đĩa vật lý là cấp cao nhất, các phân vùng nằm bên dưới. Lệnh này không cần quyền root và là lựa chọn đầu tiên khi cần cái nhìn tổng quan nhanh.

{% code title="Xem danh sách ổ đĩa và phân vùng" overflow="wrap" lineNumbers="true" %}

```bash
lsblk
```

{% endcode %}

Ví dụ output:

{% code title="Output của lsblk" overflow="wrap" %}

```plaintext
NAME   MAJ:MIN RM  SIZE RO TYPE MOUNTPOINT
sda      8:0    0   80G  0 disk
├─sda1   8:1    0  500M  0 part /boot
├─sda2   8:2    0   75G  0 part /
└─sda3   8:3    0  4.5G  0 part [SWAP]
sr0     11:0    1 1024M  0 rom
```

{% endcode %}

* **NAME:** Tên device rút gọn (`sda`, `sda1`...).
* **MAJ:MIN:** Số major/minor của device.
* **RM:** Removable device (1 = thiết bị tháo rời như USB).
* **SIZE:** Kích thước ổ đĩa/phân vùng.
* **RO:** Read-only (1 = chỉ đọc).
* **TYPE:** Loại device — `disk` (ổ đĩa vật lý), `part` (phân vùng), `rom` (ổ đĩa quang).
* **MOUNTPOINT:** Thư mục đang mount, `[SWAP]` nếu là phân vùng swap.

### Các tùy chọn hữu ích

* **-f:** Hiển thị thêm filesystem type và UUID — rất cần khi cấu hình `/etc/fstab`.
* **-p:** Hiển thị đường dẫn đầy đủ (`/dev/sda1`) thay vì tên rút gọn.
* **-m:** Hiển thị ownership và permission của device.
* **-a:** Hiển thị cả các device rỗng (không có phân vùng).

{% code title="Xem filesystem type và UUID" overflow="wrap" lineNumbers="true" %}

```bash
lsblk -f
```

{% endcode %}

{% code title="Output của lsblk -f" overflow="wrap" %}

```plaintext
NAME   FSTYPE LABEL UUID                                 MOUNTPOINT
sda
├─sda1 xfs           a1b2c3d4-e5f6-4a5b-9c8d-1e2f3a4b5c6d /boot
├─sda2 xfs           e5f6a7b8-c9d0-4e5f-8a9b-0c1d2e3f4a5b /
└─sda3 swap          1234abcd-5678-9def-0123-456789abcdef [SWAP]
```

{% endcode %}

{% hint style="info" %}
Nhận biết USB drive bằng cột `RM` — nếu giá trị là `1` thì đó là thiết bị tháo rời được, không phải ổ cứng gắn trong.
{% endhint %}

## 3. `fdisk -l` — Xem Chi Tiết Ổ Đĩa Và Bảng Phân Vùng

`fdisk` là công cụ quản lý partition table kinh điển trên Linux. Tùy chọn `-l` (list) liệt kê tất cả ổ cứng và phân vùng kèm thông tin chi tiết về sector, kích thước và loại phân vùng. Lệnh này **yêu cầu quyền root**.

{% code title="Xem chi tiết tất cả ổ cứng và bảng phân vùng" overflow="wrap" lineNumbers="true" %}

```bash
sudo fdisk -l
```

{% endcode %}

Ví dụ output:

{% code title="Output của fdisk -l" overflow="wrap" %}

```plaintext
Disk /dev/sda: 80 GiB, 85899345920 bytes, 167772160 sectors
Disk model: Virtual disk
Units: sectors of 1 * 512 = 512 bytes
Sector size (logical/physical): 512 bytes / 512 bytes
I/O size (minimum/optimal): 512 bytes / 512 bytes
Disklabel type: dos
Disk identifier: 0x000d5a1e

Device     Boot   Start       End   Sectors  Size Id Type
/dev/sda1  *       2048   1026047   1024000  500M 83 Linux
/dev/sda2       1026048 158308351 157282304   75G 83 Linux
/dev/sda3      158308352 167772159   9463808  4.5G 82 Linux swap / Solaris
```

{% endcode %}

* **Disk model:** Model ổ cứng (hữu ích trên máy vật lý).
* **Disklabel type:** Loại bảng phân vùng — `dos` (MBR) hoặc `gpt` (GPT).
* **Device:** Tên phân vùng.
* **Boot:** Dấu `*` đánh dấu phân vùng boot.
* **Start/End/Sectors:** Vị trí và số sector — dùng khi khôi phục dữ liệu hoặc phân tích chi tiết.
* **Id/Type:** Mã và loại phân vùng (`83` = Linux, `82` = Linux swap).

### Các biến thể thường dùng

{% code title="Xem một ổ cụ thể và kiểm tra loại bảng phân vùng" overflow="wrap" lineNumbers="true" %}

```bash
# Xem chỉ riêng ổ /dev/sda
sudo fdisk -l /dev/sda

# Kiểm tra nhanh bảng phân vùng GPT hay MBR
sudo fdisk -l | grep "Disklabel type"
```

{% endcode %}

{% hint style="warning" %}
`fdisk -l` cần quyền root — luôn chạy với `sudo`. Khi dùng `fdisk` ở chế độ tương tác (không có `-l`) để thao tác ghi, hãy hết sức cẩn thận vì thay đổi partition table có thể làm mất dữ liệu.
{% endhint %}

## 4. `du -sh` — Kiểm Tra Dung Lượng Thực Tế Của Thư Mục

`du` (disk usage) tính toán dung lượng mà các file và thư mục đang chiếm dụng. Tùy chọn `-s` (summarize) chỉ hiển thị tổng dung lượng, kết hợp `-h` (human-readable) để đọc dễ dàng. Đây là lệnh quan trọng nhất khi cần tìm "thủ phạm" chiếm dung lượng.

{% code title="Xem dung lượng thực tế của một thư mục" overflow="wrap" lineNumbers="true" %}

```bash
du -sh /var/log
```

{% endcode %}

Ví dụ output:

{% code title="Output của du -sh" overflow="wrap" %}

```plaintext
2.3G	/var/log
```

{% endcode %}

### Các tùy chọn hữu ích

* **-s (--summarize):** Chỉ hiển thị tổng dung lượng, không liệt kê từng thư mục con.
* **-h (--human-readable):** Hiển thị kích thước theo K, M, G.
* **-a (--all):** Hiển thị cả file lẫn thư mục con.
* **--max-depth=N:** Hiển thị cây thư mục con tới độ sâu N.

### Tìm thư mục chiếm nhiều dung lượng nhất

Kết hợp `du` với `sort` và `head` để tìm nhanh 10 thư mục "ngốn" dung lượng nhất:

{% code title="Top thư mục chiếm nhiều dung lượng" overflow="wrap" lineNumbers="true" %}

```bash
du -sh /var/* 2>/dev/null | sort -rh | head -n 10
du -h --max-depth=1 / 2>/dev/null | sort -rh | head -n 10
```

{% endcode %}

{% code title="Output ví dụ" overflow="wrap" %}

```plaintext
2.3G	/var/log
1.8G	/var/lib
800M	/var/www
```

{% endcode %}

{% hint style="info" %}
Thêm `2>/dev/null` để bỏ qua các thư mục không có quyền đọc — tránh output bị "phủ" bởi các thông báo lỗi Permission denied.
{% endhint %}

## Phân Biệt `df` Và `du`

Hai lệnh này dễ gây nhầm lẫn vì đều hiển thị dung lượng, nhưng bản chất khác nhau:

{% tabs %}
{% tab title="df" %}
`df` đo ở mức **filesystem đang mount** (block-level) — đọc trực tiếp metadata của filesystem. Kết quả phản ánh dung lượng thực tế mà phân vùng cấp phát, không cần quét từng file. Nhanh, chính xác cho câu hỏi "phân vùng còn bao nhiêu?".
{% endtab %}

{% tab title="du" %}
`du` quét **từng file và thư mục** trên đĩa, cộng dồn kích thước lại. Kết quả chậm hơn nhưng trả lời đúng câu hỏi "thư mục này đang chiếm bao nhiêu?". Lưu ý: file đã bị xóa nhưng process còn giữ handle vẫn chiếm dung lượng — lúc này `df` vẫn báo đầy dù `du` không thấy.
{% endtab %}
{% endtabs %}

{% hint style="warning" %}
Khi đã xóa file mà `df -h` vẫn báo phân vùng đầy, nguyên nhân thường là một process vẫn đang giữ file đã xóa. Kiểm tra bằng `lsof | grep deleted` rồi restart process đó.
{% endhint %}

## Lệnh Nào Dùng Khi Nào?

| Tình huống                                                   | Lệnh gợi ý                                                      |
| ------------------------------------------------------------ | --------------------------------------------------------------- |
| Còn bao nhiêu dung lượng trống trên server?                  | `df -h`                                                         |
| Hệ thống đang có những ổ cứng, phân vùng nào?                | `lsblk`                                                         |
| Cần UUID và filesystem type để mount (cấu hình `/etc/fstab`) | `lsblk -f` hoặc `sudo blkid`                                    |
| Cần chi tiết bảng phân vùng, sector, boot flag               | `sudo fdisk -l`                                                 |
| Thư mục nào chiếm nhiều dung lượng nhất?                     | `du -sh /path` kết hợp `sort -rh`                               |
| Phân vùng đang đầy, tìm file lớn                             | `df -h` → `find / -xdev -type f -size +100M -exec ls -lh {} \;` |

## Mẹo Vặt

* **Theo dõi liên tục:** `watch -n 5 df -h` tự cập nhật kết quả mỗi 5 giây — hữu ích khi đang theo dõi dung lượng biến động.
* **Bỏ qua tmpfs cho output gọn:** `df -h -x tmpfs -x devtmpfs`.
* **Kiểm tra inode khi disk còn trống nhưng báo đầy:** `df -i` — hết inode cũng gây lỗi "No space left on device".
* **Tìm các file lớn hơn 100MB:** `find / -xdev -type f -size +100M -exec ls -lh {} \; 2>/dev/null`.
* **Phát hiện file đã xóa nhưng còn giữ:** `lsof +L1` liệt kê các file bị xóa mà process vẫn đang mở.
* **Trên CentOS:** tất cả các lệnh trên đều có sẵn trong bộ `coreutils`/`util-linux`, không cần cài đặt thêm gói nào.

## Kết Luận

Bốn lệnh trên tạo thành bộ công cụ đủ để xử lý hầu hết tình huống liên quan đến ổ đĩa trên CentOS/Linux: `df -h` cho câu hỏi dung lượng còn trống, `lsblk` cho cái nhìn tổng quan cấu trúc ổ đĩa, `fdisk -l` khi cần chi tiết bảng phân vùng, và `du -sh` khi phải tìm thủ phạm chiếm dung lượng. Hãy bắt đầu với `df -h` + `lsblk` cho kiểm tra nhanh hằng ngày, và dành `fdisk -l` + `du` cho các ca "khó chịu" hơn. Chúc bạn quản trị hệ thống hiệu quả!

## Tài liệu tham khảo

* [How to Check Disk Partitions in Linux (TecMint)](https://www.tecmint.com/list-disks-partitions-linux/)
* [Linux - Các lệnh kiểm tra thông số VPS/Server (Viblo)](https://viblo.asia/p/linux-cac-lenh-linux-kiem-tra-cac-thong-so-vpsserver-Qbq5QEbw5D8)
* [Xem Disk Và Partition Trên Linux Hiệu Quả Bằng 7 Lệnh Thực Tế (TungLe.Blog)](https://tungle.blog/2026/03/xem-disk-partition-linux.html)
* [Lệnh (command line) xem dung lượng trên máy chủ Linux (Mắt Bão)](https://wiki.matbao.net/kb/lenh-command-line-xem-dung-luong-tren-may-chu-linux/)


# Debian

Debian là hệ điều hành và là một bản phân phối của Phần mềm Tự do. Nó được bảo trì và cập nhật thông qua việc làm của nhiều người những người mà tình nguyện dành thời gian và công sức để đóng góp.


# Ubuntu


# SMB - Hướng dẫn chia sẻ thư mục qua Samba trên Ubuntu

SMB (Server Message Block) – còn được biết đến với tên gọi CIFS (Common Internet File System) – là giao thức chia sẻ file và máy in phổ biến nhất trong môi trường Windows.

Nhờ có **Samba**, Ubuntu có thể trở thành một máy chủ chia sẻ file hoạt động liền mạch với Windows, macOS và cả các bản phân phối Linux khác.

Trong bài viết này, tôi sẽ hướng dẫn bạn từng bước thiết lập một thư mục chia sẻ qua SMB trên Ubuntu, kèm theo các tùy chọn xác thực và phân quyền cơ bản.

***

### 1. Điều kiện tiên quyết

* Một máy tính cài **Ubuntu 20.04/22.04/24.04** (các phiên bản khác cũng tương tự).
* Quyền `sudo` hoặc tài khoản root.
* Máy chủ và máy khách nằm trong cùng mạng nội bộ.
* Địa chỉ IP tĩnh được khuyến khích để tránh thay đổi sau mỗi lần khởi động lại.

***

### 2. Cập nhật hệ thống và cài đặt Samba

Trước tiên, hãy cập nhật danh sách gói và nâng cấp hệ thống:

bash

```bash
sudo apt update && sudo apt upgrade -y
```

Sau đó cài đặt Samba:

bash

```bash
sudo apt install samba -y
```

Sau khi cài đặt, bạn có thể kiểm tra phiên bản Samba:

bash

```bash
smbd --version
```

Kết quả tương tự: `Version 4.15.13-Ubuntu`.

***

### 3. Tạo thư mục muốn chia sẻ

Giả sử bạn muốn chia sẻ thư mục `share` nằm trong thư mục người dùng `nqdev`.\
Tạo thư mục và cấp quyền phù hợp:

bash

```bash
mkdir -p /home/nqdev/share
sudo chmod -R 0755 /home/nqdev/share
sudo chown -R nqdev:nqdev /home/nqdev/share
```

* `chmod 0755`: chủ sở hữu có toàn quyền (đọc, ghi, thực thi), nhóm và người khác chỉ đọc và thực thi.
* `chown nqdev:nqdev`: gán chủ sở hữu và nhóm là `nqdev`.

Nếu bạn muốn cho phép người dùng khác ghi vào thư mục, hãy đặt quyền `0777` (không an toàn) hoặc tạo nhóm riêng và gán quyền.

***

### 4. Sao lưu file cấu hình gốc

Trước khi sửa file cấu hình, hãy sao lưu để dễ khôi phục:

bash

```bash
sudo cp /etc/samba/smb.conf /etc/samba/smb.conf.bak
```

***

### 5. Cấu hình Samba

Mở file cấu hình bằng trình soạn thảo (nano hoặc vim):

bash

```bash
sudo nano /etc/samba/smb.conf
```

#### 5.1. Cấu hình phần `[global]` (tuỳ chọn)

Bạn có thể để mặc định hoặc thêm các tuỳ chỉnh sau vào cuối phần `[global]`:

ini

```ini
[global]
   workgroup = WORKGROUP
   server string = %h server (Samba, Ubuntu)
   netbios name = ubuntu-server
   map to guest = bad user
   dns proxy = no
```

* `map to guest = bad user`: nếu người dùng không tồn tại, tự động chuyển thành guest (hữu ích khi bật guest access).

#### 5.2. Định nghĩa share

Cuối file, thêm một định nghĩa share. Ví dụ:

ini

```ini
[MyShare]
   comment = Thư mục chia sẻ của NQDEV
   path = /home/nqdev/share
   browseable = yes
   read only = no
   guest ok = no
   valid users = nqdev
   create mask = 0755
   directory mask = 0755
```

**Giải thích các tuỳ chọn**:

* `[MyShare]` – tên share sẽ hiển thị trên mạng.
* `comment` – mô tả (xuất hiện khi duyệt mạng).
* `path` – đường dẫn thư mục thực tế.
* `browseable` – hiển thị trong danh sách share khi duyệt mạng.
* `read only = no` – cho phép ghi.
* `guest ok = no` – yêu cầu xác thực (đặt `yes` nếu muốn cho phép khách không cần mật khẩu).
* `valid users` – chỉ cho phép người dùng `nqdev` truy cập.
* `create mask` / `directory mask` – quyền tạo file/thư mục mới (theo chuẩn Linux).

Nếu bạn muốn **cho phép truy cập guest (không cần mật khẩu)** và không yêu cầu tài khoản, đặt:

ini

```ini
   guest ok = yes
   read only = no
   force user = nqdev          # tuỳ chọn: áp dụng quyền của người dùng nqdev cho guest
```

Lưu file và thoát (Ctrl + O, Enter, Ctrl + X với nano).

***

### 6. Thêm người dùng Samba

Samba sử dụng cơ sở dữ liệu riêng để quản lý mật khẩu.\
Tạo người dùng Samba với mật khẩu (người dùng này phải tồn tại trong hệ thống Ubuntu):

bash

```bash
sudo smbpasswd -a nqdev
```

Hệ thống sẽ yêu cầu nhập mật khẩu (có thể khác với mật khẩu đăng nhập Ubuntu).\
Để kích hoạt tài khoản:

bash

```bash
sudo smbpasswd -e nqdev
```

***

### 7. Khởi động lại dịch vụ Samba và cấu hình tường lửa

Khởi động lại các dịch vụ `smbd` (server SMB) và `nmbd` (hỗ trợ NetBIOS):

bash

```bash
sudo systemctl restart smbd nmbd
```

Kích hoạt tự động khởi động cùng hệ thống:

bash

```bash
sudo systemctl enable smbd nmbd
```

Nếu bạn đang sử dụng tường lửa **ufw**, hãy mở các cổng cho Samba:

bash

```bash
sudo ufw allow samba
```

hoặc cụ thể hơn:

bash

```bash
sudo ufw allow 445/tcp
sudo ufw allow 139/tcp
sudo ufw allow 137/udp
sudo ufw allow 138/udp
```

***

### 8. Kiểm tra trạng thái dịch vụ

Xem `smbd` đã chạy chưa:

bash

```bash
sudo systemctl status smbd
```

Kiểm tra cấu hình Samba có lỗi cú pháp không:

bash

```bash
testparm
```

Lệnh này sẽ hiển thị cấu hình hợp lệ và cảnh báo nếu có lỗi.

***

### 9. Truy cập thư mục chia sẻ

#### 9.1. Từ máy tính Windows

* Mở **File Explorer**, nhập đường dẫn:

  text

  ```bash
  \\địa_chỉ_ip_ubuntu\MyShare
  ```

  Ví dụ: `\\192.168.1.100\MyShare`
* Nhập tên người dùng và mật khẩu Samba (đã tạo ở bước 6).
* Nếu không thấy share, hãy thử dùng IP thay vì tên máy.

#### 9.2. Từ macOS

* Mở **Finder** → menu **Go** → **Connect to Server...** (⌘K)
* Nhập: `smb://địa_chỉ_ip_ubuntu/MyShare`
* Nhập thông tin đăng nhập.

#### 9.3. Từ Linux

Dùng lệnh `smbclient`:

bash

```bash
smbclient //192.168.1.100/MyShare -U nqdev
```

Hoặc mount thư mục vào hệ thống:

bash

```bash
sudo mount -t cifs //192.168.1.100/MyShare /mnt/share -o username=nqdev,password=your_password
```

***

### 10. Xử lý sự cố thường gặp

#### 10.1. Lỗi “Permission denied” khi ghi file

* Kiểm tra quyền Linux của thư mục: `ls -ld /home/nqdev/share`
* Kiểm tra `create mask` và `directory mask` trong `smb.conf`.
* Nếu dùng guest, hãy thêm `force user = nqdev` để đảm bảo quyền ghi.

#### 10.2. Không thể kết nối từ Windows

* Tắt tường lửa tạm thời để kiểm tra: `sudo ufw disable` (sau đó bật lại).
* Đảm bảo máy khách và máy chủ cùng subnet.
* Kiểm tra log Samba: `sudo tail -f /var/log/samba/log.smbd`

#### 10.3. Vẫn hỏi mật khẩu dù đã đặt guest ok = yes

Thêm dòng `map to guest = bad user` vào phần `[global]` trong `smb.conf` và khởi động lại Samba.

#### 10.4. Lỗi “You do not have permission to access” trên Windows 10/11

* Mở **Control Panel** → **Programs and Features** → **Turn Windows features on or off** → bật **SMB 1.0/CIFS Client** (không khuyến khích vì bảo mật) hoặc đảm bảo máy chủ Samba hỗ trợ SMB2/3 (Samba mặc định hỗ trợ).
* Đôi khi Windows yêu cầu đăng nhập với định dạng `tên_máy\tên_người_dùng`.

***

### 11. Kết luận

Bạn đã hoàn tất việc thiết lập một máy chủ chia sẻ file SMB trên Ubuntu. Với cấu hình trên, bạn có thể dễ dàng chia sẻ dữ liệu giữa các hệ điều hành khác nhau trong mạng nội bộ.

Samba còn rất nhiều tuỳ chỉnh nâng cao như chia sẻ theo nhóm, tích hợp với Active Directory, giới hạn băng thông, v.v. Tuỳ vào nhu cầu, bạn có thể mở rộng cấu hình để đáp ứng các yêu cầu phức tạp hơn.

Hy vọng bài viết này hữu ích với bạn. Nếu có bất kỳ thắc mắc, hãy để lại bình luận bên dưới.

***

**Cẩm nang NQDEV** – Kiến thức IT thực chiến, dễ hiểu và áp dụng ngay.


# SMB - Bảo mật chia sẻ thư mục SMB trên Ubuntu với iptables và WireGuard

SMB (Samba) là giải pháp chia sẻ file phổ biến, nhưng khi mở cổng 445/139 trực tiếp ra internet, bạn đang tự đặt hệ thống vào tầm ngắm của tấn công mạng.

Bài viết này hướng dẫn bạn xây dựng một hệ thống **an toàn** trên Ubuntu: chỉ cho phép truy cập SMB qua **WireGuard VPN** và kiểm soát chặt chẽ bằng **iptables** – tường lửa mạnh mẽ tích hợp sẵn trong nhân Linux.

***

### Mô hình triển khai

* **Ubuntu Server**: chạy đồng thời Samba (SMB) và WireGuard VPN.
* **Client**: kết nối VPN bằng WireGuard, nhận IP trong dải riêng (ví dụ `10.0.0.0/24`).
* **iptables**: chỉ cho phép truy cập đến cổng SMB (139, 445) từ các IP thuộc VPN. Mọi kết nối SMB từ mạng khác (kể cả internet) đều bị chặn.

***

### 1. Cài đặt Samba và tạo thư mục chia sẻ

#### 1.1. Cập nhật hệ thống

bash

```bash
sudo apt update && sudo apt upgrade -y
```

#### 1.2. Cài đặt Samba

bash

```bash
sudo apt install samba -y
```

#### 1.3. Tạo thư mục chia sẻ

Giả sử người dùng là `nqdev`:

bash

```bash
mkdir -p /home/nqdev/share
sudo chmod 0755 /home/nqdev/share
sudo chown -R nqdev:nqdev /home/nqdev/share
```

#### 1.4. Cấu hình Samba

Sao lưu file cấu hình gốc:

bash

```bash
sudo cp /etc/samba/smb.conf /etc/samba/smb.conf.bak
```

Mở file cấu hình:

bash

```bash
sudo nano /etc/samba/smb.conf
```

Thêm vào cuối file:

ini

```ini
[MyShare]
   comment = Thư mục chia sẻ qua VPN
   path = /home/nqdev/share
   browseable = yes
   read only = no
   guest ok = no
   valid users = nqdev
   create mask = 0755
   directory mask = 0755
```

Lưu và thoát.

#### 1.5. Thêm người dùng Samba

bash

```bash
sudo smbpasswd -a nqdev   # nhập mật khẩu Samba
sudo smbpasswd -e nqdev   # kích hoạt
```

#### 1.6. Khởi động dịch vụ Samba

bash

```bash
sudo systemctl restart smbd nmbd
sudo systemctl enable smbd nmbd
```

***

### 2. Cấu hình tường lửa iptables

iptables là tường lửa mặc định của Ubuntu. Chúng ta sẽ xây dựng các rule để:

* Chỉ cho phép kết nối đến cổng SMB từ dải VPN `10.0.0.0/24`.
* Mở các cổng cần thiết: SSH, WireGuard.
* Đặt chính sách mặc định an toàn.

#### 2.1. Xóa các rule cũ (nếu có)

bash

```bash
sudo iptables -F
sudo iptables -X
sudo iptables -t nat -F
```

#### 2.2. Xây dựng bộ rule

Giả sử giao diện mạng chính là `eth0` (nếu dùng cloud có thể là `ens3`, `ens5` – kiểm tra bằng `ip a`).

bash

```bash
# Chính sách mặc định: DROP tất cả INPUT, FORWARD, ACCEPT OUTPUT
sudo iptables -P INPUT DROP
sudo iptables -P FORWARD DROP
sudo iptables -P OUTPUT ACCEPT

# Cho phép loopback
sudo iptables -A INPUT -i lo -j ACCEPT

# Cho phép các kết nối đã được thiết lập và liên quan
sudo iptables -A INPUT -m state --state ESTABLISHED,RELATED -j ACCEPT

# Cho phép SSH (tuỳ chỉnh cổng nếu cần)
sudo iptables -A INPUT -p tcp --dport 22 -j ACCEPT

# Cho phép WireGuard (UDP 51820)
sudo iptables -A INPUT -p udp --dport 51820 -j ACCEPT

# Cho phép truy cập SMB CHỈ từ dải VPN
sudo iptables -A INPUT -p tcp -s 10.0.0.0/24 --dport 139 -j ACCEPT
sudo iptables -A INPUT -p tcp -s 10.0.0.0/24 --dport 445 -j ACCEPT

# Chặn mọi truy cập SMB khác (không bắt buộc vì policy đã DROP, nhưng để rõ ràng)
sudo iptables -A INPUT -p tcp --dport 139 -j DROP
sudo iptables -A INPUT -p tcp --dport 445 -j DROP

# (Tuỳ chọn) Cho phép ping để kiểm tra
sudo iptables -A INPUT -p icmp --icmp-type echo-request -j ACCEPT
```

**Lưu ý quan trọng**: Khi policy INPUT là DROP, nếu bạn chưa có rule cho SSH, bạn sẽ bị khóa mất kết nối. Hãy chắc chắn đã thêm rule SSH trước khi áp dụng policy DROP. Để an toàn, bạn có thể thực thi từng bước và kiểm tra.

#### 2.3. Lưu rule iptables

Cài gói lưu trữ rule:

bash

```bash
sudo apt install iptables-persistent -y
sudo netfilter-persistent save
```

Khi khởi động lại, các rule sẽ tự động được phục hồi.

***

### 3. Cài đặt WireGuard

#### 3.1. Cài đặt gói WireGuard

bash

```bash
sudo apt install wireguard -y
```

#### 3.2. Tạo khóa cho server

bash

```bash
wg genkey | sudo tee /etc/wireguard/private.key
sudo chmod 600 /etc/wireguard/private.key
sudo cat /etc/wireguard/private.key | wg pubkey | sudo tee /etc/wireguard/public.key
```

#### 3.3. Tạo file cấu hình server `/etc/wireguard/wg0.conf`

bash

```bash
sudo nano /etc/wireguard/wg0.conf
```

Nội dung:

ini

```ini
[Interface]
Address = 10.0.0.1/24
ListenPort = 51820
PrivateKey = <private-key-của-server>   # thay bằng nội dung file private.key

# PostUp/PostDown: cho phép chuyển tiếp gói tin và NAT để client VPN có thể ra internet
PostUp = iptables -A FORWARD -i wg0 -j ACCEPT; iptables -t nat -A POSTROUTING -o eth0 -j MASQUERADE
PostDown = iptables -D FORWARD -i wg0 -j ACCEPT; iptables -t nat -D POSTROUTING -o eth0 -j MASQUERADE

[Peer]
PublicKey = <public-key-của-client>    # sẽ thêm sau khi tạo key client
AllowedIPs = 10.0.0.2/32
```

#### 3.4. Bật chuyển tiếp IP (IP forwarding)

bash

```bash
echo 'net.ipv4.ip_forward=1' | sudo tee -a /etc/sysctl.conf
sudo sysctl -p
```

#### 3.5. Khởi động WireGuard

bash

```bash
sudo systemctl enable wg-quick@wg0
sudo systemctl start wg-quick@wg0
```

***

### 4. Cấu hình client WireGuard

Trên máy client (Windows, macOS, Linux), cài đặt WireGuard và tạo cặp khóa.

**Ví dụ trên Linux client**:

bash

```bash
wg genkey | tee client_private.key
cat client_private.key | wg pubkey > client_public.key
```

Tạo file cấu hình (ví dụ `wg0.conf`):

ini

```ini
[Interface]
PrivateKey = <private-key-client>
Address = 10.0.0.2/24
DNS = 8.8.8.8

[Peer]
PublicKey = <public-key-server>
Endpoint = <địa-chỉ-ip-công-cộng-của-server>:51820
AllowedIPs = 10.0.0.0/24
```

* `AllowedIPs = 10.0.0.0/24`: chỉ gửi lưu lượng đến dải VPN qua tunnel. Nếu muốn tất cả lưu lượng internet đều qua VPN, đặt `0.0.0.0/0` (nhưng cần NAT trên server).

Sau khi có file cấu hình, import vào ứng dụng WireGuard và kích hoạt.

***

### 5. Kiểm tra và sử dụng

#### 5.1. Kiểm tra kết nối VPN

Từ client, ping địa chỉ VPN của server:

bash

```bash
ping 10.0.0.1
```

Nếu ping thành công, WireGuard đã hoạt động.

#### 5.2. Truy cập SMB qua VPN

**Trên Windows**:

* Mở File Explorer, nhập `\\10.0.0.1\MyShare`
* Đăng nhập với tài khoản Samba `nqdev` và mật khẩu đã đặt.

**Trên Linux client**:

* Dùng `smbclient`:

bash

```bash
smbclient //10.0.0.1/MyShare -U nqdev
```

* Hoặc mount:

bash

```bash
sudo mount -t cifs //10.0.0.1/MyShare /mnt/share -o username=nqdev,password=yourpass
```

#### 5.3. Kiểm tra tường lửa

Từ một máy không nằm trong VPN (hoặc từ chính server nhưng không qua wg0), thử telnet đến cổng 445:

bash

```bash
telnet 10.0.0.1 445   # từ client đã kết nối VPN sẽ thành công
telnet <ip-public> 445 # từ internet sẽ bị chặn
```

***

### 6. Một số lưu ý và xử lý sự cố

* **Mất kết nối SSH sau khi cấu hình iptables**: hãy truy cập bằng console (nếu có) hoặc khởi động lại vào chế độ recovery để sửa rule. Luôn kiểm tra rule SSH trước khi đặt policy DROP.
* **Samba yêu cầu xác thực nhưng không thể kết nối**: kiểm tra `valid users` trong `smb.conf` và đảm bảo người dùng Samba đã được kích hoạt.
* **WireGuard không khởi động**: kiểm tra log bằng `sudo journalctl -u wg-quick@wg0`.
* **Để mở thêm cổng khác qua VPN**: thêm các rule iptables tương tự với dải `10.0.0.0/24`.

***

### 7. Kết luận

Bạn đã thiết lập thành công một hệ thống chia sẻ file SMB an toàn trên Ubuntu, sử dụng iptables để kiểm soát truy cập và WireGuard để mã hóa đường truyền. Giải pháp này phù hợp cho các tổ chức hoặc cá nhân cần truy cập dữ liệu từ xa với mức độ bảo mật cao.

***

**Cẩm nang NQDEV** – Kiến thức IT thực chiến, dễ hiểu và áp dụng ngay.


# Tools


# smem – Công cụ đo lường bộ nhớ chính xác hơn trên Linux

smem – Công cụ đo lường bộ nhớ chính xác hơn trên Linux mà DevOps không nên bỏ qua

Trong quá trình vận hành hệ thống Linux, hẳn bạn đã không ít lần sử dụng `top`, `htop` hay `ps` để truy vết tiến trình “ngốn” RAM. Tuy nhiên, càng đi sâu vào môi trường production, bạn sẽ càng nhận ra một thực tế: **những con số đó không phản ánh đầy đủ bản chất cách Linux sử dụng bộ nhớ**.

Đó là lúc **smem** trở thành một mảnh ghép quan trọng – một công cụ nhỏ gọn nhưng mang lại góc nhìn *chuẩn xác và công bằng hơn* về RAM. Bài viết này thuộc chuỗi kiến thức thực chiến của **Cẩm nang NQDEV**, giúp bạn hiểu đúng – dùng đúng – và tối ưu hệ thống hiệu quả hơn trên **NQDEV Platform**.

***

### 1. smem là gì và vì sao nó “khác biệt”?

`smem` là tiện ích dòng lệnh chuyên phân tích **mức sử dụng bộ nhớ thực tế của các tiến trình Linux**, đặc biệt tập trung vào cách bộ nhớ **được chia sẻ** giữa nhiều process.

Khác với `top` hay `ps` – vốn chỉ hiển thị RSS một cách “thô”, `smem` áp dụng mô hình phân bổ bộ nhớ hợp lý thông qua các chỉ số sau:

| Chỉ số                          | Ý nghĩa                                               |
| ------------------------------- | ----------------------------------------------------- |
| **USS (Unique Set Size)**       | Lượng RAM *chỉ tiến trình này sử dụng*, không chia sẻ |
| **PSS (Proportional Set Size)** | RAM chia sẻ được *chia theo tỷ lệ công bằng*          |
| **RSS (Resident Set Size)**     | Tổng RAM tiến trình đang chiếm trong bộ nhớ vật lý    |
| **VSS (Virtual Set Size)**      | Tổng bộ nhớ ảo được ánh xạ (kể cả chưa dùng)          |
| **SWAP**                        | Lượng bộ nhớ đã bị đẩy sang swap                      |

👉 **Cách hiểu nhanh**:

* **USS** → RAM “thuần” của tiến trình
* **PSS** → RAM dùng chung nhưng được phân bổ công bằng
* **RSS** → Con số quen thuộc nhưng dễ gây hiểu nhầm

Chính nhờ PSS, `smem` cho bạn một bức tranh *gần với thực tế hệ thống nhất*.

***

### 2. Cài đặt smem trên Linux

#### Ubuntu / Debian

```bash
sudo apt update
sudo apt install smem
```

#### CentOS / RHEL

```bash
sudo yum install smem
```

> Lưu ý: nên chạy `smem` với quyền `root` để thu thập đủ dữ liệu bộ nhớ chia sẻ.

***

### 3. Xem mức sử dụng RAM chi tiết theo tiến trình

Lệnh cơ bản thường dùng trong production:

```bash
smem -r -k -c "pid user name uss pss rss swap command"
```

**Giải thích nhanh**:

* `-r`: chạy với quyền root
* `-k`: hiển thị theo KB
* `-c`: chọn các cột cần quan sát

Đây là cách tiếp cận *có chiều sâu hơn rất nhiều* so với việc nhìn mỗi RSS trong `top`.

***

### 4. Truy vết tiến trình “ngốn” RAM thật sự

Thay vì hỏi: *“Process nào RSS cao nhất?”*\
Hãy hỏi đúng hơn: **“Process nào đang dùng RAM riêng nhiều nhất?”**

```bash
smem -r -k -c "pid user name uss pss rss swap command" | sort -nk4 -r | head -20
```

* `sort -nk4 -r`: sắp xếp giảm dần theo **USS**
* `head -20`: lấy 20 tiến trình đứng đầu

👉 Đây là bước rất quan trọng khi:

* Phát hiện **memory leak**
* Đánh giá đúng mức độ ảnh hưởng của từng service
* Ra quyết định scale hoặc giới hạn tài nguyên

***

### 5. Xuất dữ liệu smem ra CSV để phân tích sâu hơn

```bash
smem -r -k -c "pid user name uss pss rss swap command" > smem_output.csv
```

File CSV này có thể:

* Mở bằng Excel / Google Sheets
* Vẽ biểu đồ RAM – SWAP theo tiến trình
* Phục vụ audit, báo cáo, hoặc phân tích xu hướng dài hạn

Đây là một cách làm **rất được khuyến nghị trên NQDEV Platform** khi tối ưu hệ thống production.

***

### 6. smem vs top/ps – So sánh nhanh, nhìn là hiểu

| Tiêu chí                  | top / ps          | smem               |
| ------------------------- | ----------------- | ------------------ |
| Chia sẻ bộ nhớ            | ❌ Không chính xác | ✅ Phân bổ theo PSS |
| Theo dõi swap             | ❌ Hạn chế         | ✅ Rõ ràng          |
| Phân tích theo tiến trình | ❌ Nông            | ✅ Chi tiết         |
| Xuất dữ liệu              | ❌ Không hỗ trợ    | ✅ CSV / biểu đồ    |

➡️ Với những hệ thống nhiều service, container, hoặc workload phức tạp, `smem` gần như là **công cụ bắt buộc**.

***

### 7. Góc nhìn từ Cẩm nang NQDEV

Điều quan trọng không nằm ở công cụ, mà ở **tư duy đo lường đúng**:

> *“Không tối ưu thứ bạn không đo đúng.”*

`smem` giúp bạn:

* Hiểu cách Linux phân bổ bộ nhớ *thực sự*
* Tránh quyết định sai lầm dựa trên RSS
* Tối ưu tài nguyên một cách có cơ sở

Đây cũng chính là triết lý xuyên suốt của **Cẩm nang NQDEV**:\
👉 *Hiểu bản chất – rồi mới tối ưu.*

***

### 🧭 Kết luận

`smem` không chỉ cho bạn biết *ai đang dùng RAM*, mà còn trả lời câu hỏi quan trọng hơn:\
\&#xNAN;**“RAM đó thực sự thuộc về ai?”**

Nếu bạn là:

* Sysadmin
* DevOps Engineer
* Backend Developer vận hành production

Hãy dành thời gian làm quen với `smem`. Đây là một khoản đầu tư nhỏ nhưng mang lại **lợi ích dài hạn cho độ ổn định hệ thống**.

📌 Để khám phá thêm nhiều kiến thức thực chiến tương tự, bạn có thể truy cập [**Cẩm nang NQDEV**](https://blogs.nhquydev.net/) – nơi tổng hợp các góc nhìn kỹ thuật sâu, thực tế và có thể áp dụng ngay trên **NQDEV Platform**.


# ss - Socket Statistics


# FFmpeg

FFmpeg là tập hợp các thư viện và công cụ để xử lý nội dung đa phương tiện như âm thanh, video, phụ đề và siêu dữ liệu liên quan.

#### 🛠️ Cách 1: Lấy trực tiếp URL luồng từ TikTok Live (dùng `yt-dlp` + `ffmpeg`)

Cách này hiệu quả nếu TikTok cung cấp luồng qua giao thức chuẩn (HLS/RTMP) và bạn có thể trích xuất được URL.

**Bước 1: Cài đặt `yt-dlp`**

`yt-dlp` là công cụ mạnh mẽ để tải video và trích xuất luồng từ nhiều trang web, bao gồm TikTok.

bash

```
# Trên Ubuntu/Debian
sudo apt update && sudo apt install yt-dlp ffmpeg -y

# Trên macOS (dùng Homebrew)
brew install yt-dlp ffmpeg

# Trên Windows: tải từ https://github.com/yt-dlp/yt-dlp/releases và cài ffmpeg riêng
```

**Bước 2: Lấy URL luồng trực tiếp từ TikTok Live**

Giả sử bạn có link TikTok Live hợp lệ (ví dụ: `https://www.tiktok.com/@ten_nguoi_dung/live`), chạy lệnh:

bash

```
yt-dlp -g "https://www.tiktok.com/@ten_nguoi_dung/live"
```

Lệnh này sẽ in ra URL luồng video (có thể là `.m3u8` hoặc `.flv`). Nếu có nhiều luồng (âm thanh riêng), bạn có thể thêm tùy chọn `-f` để chọn chất lượng.

> **Lưu ý:** Một số TikTok Live yêu cầu cookie đăng nhập. Nếu gặp lỗi, hãy thử xuất cookie từ trình duyệt và dùng `--cookies-from-browser`:
>
> bash
>
> ```
> yt-dlp -g --cookies-from-browser chrome "https://www.tiktok.com/@ten_nguoi_dung/live"
> ```

**Bước 3: Dùng `ffmpeg` để relay lên YouTube**

Sau khi có URL luồng (ví dụ `https://.../stream.m3u8`), bạn chạy ffmpeg để đọc và đẩy lên YouTube:

bash

```
ffmpeg -i "URL_LUONG_TIKTOK" -c copy -f flv "RTMP_YOUTUBE"
```

Trong đó:

* `URL_LUONG_TIKTOK` là URL bạn vừa lấy được.
* `RTMP_YOUTUBE` là địa chỉ RTMP kèm stream key từ YouTube Studio (ví dụ: `rtmp://a.rtmp.youtube.com/live2/xxxx-xxxx-xxxx`).

**Ví dụ hoàn chỉnh (chạy trong loop để tự động kết nối lại):**

bash

```
#!/bin/bash
YOUTUBE_RTMP="rtmp://a.rtmp.youtube.com/live2/STREAM_KEY"
TIKTOK_LIVE_URL="https://www.tiktok.com/@ngocnhi_269/live"

while true; do
    echo "Lấy URL luồng TikTok..."
    STREAM_URL=$(yt-dlp -g --cookies-from-browser chrome "$TIKTOK_LIVE_URL" 2>/dev/null | tail -n1)
    if [ -n "$STREAM_URL" ]; then
        echo "Relay từ $STREAM_URL lên YouTube..."
        ffmpeg -i "$STREAM_URL" -c copy -f flv "$YOUTUBE_RTMP"
    else
        echo "Không lấy được URL, thử lại sau 10s..."
    fi
    sleep 10
done
```

***

#### 🖥️ Cách 2: Thu lại màn hình (Screen Capture) dùng `ffmpeg`

Nếu không lấy được URL trực tiếp, bạn vẫn có thể dùng ffmpeg để ghi lại màn hình đang xem TikTok Live (giống OBS). Cách này hoạt động với mọi live stream nhưng chất lượng phụ thuộc vào cấu hình máy và độ trễ cao hơn.

**Trên Linux (X11):**

bash

```
ffmpeg -f x11grab -s 1920x1080 -i :0.0+0,0 \
       -f alsa -i default \
       -c:v libx264 -preset ultrafast -b:v 2500k \
       -c:a aac -b:a 128k \
       -f flv "rtmp://a.rtmp.youtube.com/live2/STREAM_KEY"
```

* `-s 1920x1080`: độ phân giải thu màn hình.
* `-i :0.0+0,0`: tọa độ màn hình (có thể điều chỉnh).
* `-f alsa -i default`: thu âm thanh từ hệ thống.

**Trên Windows:**

bash

```
ffmpeg -f gdigrab -framerate 30 -i desktop \
       -f dshow -i audio="Microphone (Realtek Audio)" \
       -c:v libx264 -preset ultrafast -b:v 2500k \
       -c:a aac -b:a 128k \
       -f flv "rtmp://a.rtmp.youtube.com/live2/STREAM_KEY"
```

* `-f gdigrab -i desktop`: thu toàn màn hình.
* `-f dshow -i audio="..."`: thu âm thanh (cần kiểm tra tên thiết bị âm thanh).

**Trên macOS:**

bash

```
ffmpeg -f avfoundation -i "1:0" -framerate 30 \
       -c:v libx264 -preset ultrafast -b:v 2500k \
       -c:a aac -b:a 128k \
       -f flv "rtmp://a.rtmp.youtube.com/live2/STREAM_KEY"
```

* `-i "1:0"`: thu màn hình (1) và micro (0), có thể thay đổi.

***

#### ⚠️ Cảnh báo quan trọng

1. **Bản quyền nội dung**: Việc phát lại livestream của người khác khi chưa được phép có thể vi phạm bản quyền và dẫn đến khóa kênh YouTube/TikTok.
2. **Tính hợp lệ của link**: Link bạn cung cấp hiện không phải là live, hãy kiểm tra lại tài khoản có đang phát trực tiếp hay không.
3. **Stream key YouTube**: Lấy từ YouTube Studio → tab "Phát trực tiếp" → "Tạo luồng mới" → chọn "Phần mềm mã hóa". Key có thời hạn và chỉ dùng cho một phiên.

Nếu bạn cần hướng dẫn chi tiết hơn về cách lấy stream key hoặc cài đặt cookie cho yt-dlp, hãy cho mình biết nhé!


# Windows


# Quản lý khởi động cùng Windows bằng: Registry Editor

Hướng Dẫn Kiểm Tra và Quản Lý Ứng Dụng Khởi Động Tự Động (Startup Apps) Trên Windows Bằng Registry Editor

Trong quá trình vận hành một máy Windows lâu dài, việc hệ thống ngày càng khởi động chậm, tiêu tốn tài nguyên ngay từ lúc đăng nhập là điều rất phổ biến. Nguyên nhân cốt lõi thường không nằm ở phần cứng, mà đến từ **các ứng dụng tự động chạy cùng Windows**.

Nhiều người quen xử lý vấn đề này thông qua Task Manager hoặc các công cụ bên thứ ba. Tuy nhiên, với Dev, System Engineer hay người làm IT chuyên nghiệp, **Registry Editor** mới là nơi phản ánh đầy đủ và chính xác nhất cơ chế khởi động của Windows.

Bài viết này trong **Cẩm nang NQDEV** sẽ giúp bạn:

* Hiểu bản chất cách Windows quản lý startup application
* Biết chính xác các nhánh Registry liên quan
* Kiểm soát ứng dụng khởi động một cách chủ động, an toàn và có chiến lược

***

### 1. Vì sao Registry Editor là “nguồn gốc sự thật” của Startup trên Windows?

Task Manager chỉ là lớp giao diện phía trên. Mọi thông tin về ứng dụng khởi động đều **được đọc từ Registry** khi Windows boot.

Điều này có nghĩa:

* Nếu ứng dụng **không hiển thị trong Task Manager**, nó vẫn có thể tồn tại trong Registry
* Malware, adware hoặc phần mềm cũ thường **ẩn mình tại đây**
* Muốn debug triệt để, bạn không thể bỏ qua Registry

Đối với người làm kỹ thuật, Registry không phải nơi “đáng sợ”, mà là **bản đồ cấu hình sống của hệ điều hành**.

***

### 2. Các nhánh Registry quan trọng quản lý ứng dụng khởi động

#### 2.1. Startup cho toàn bộ hệ thống (All Users)

```
HKEY_LOCAL_MACHINE\Software\Microsoft\Windows\CurrentVersion\Run
```

* Ứng dụng tại đây sẽ chạy với **mọi user**
* Thường là driver helper, agent, updater hệ thống
* Cần quyền Administrator để chỉnh sửa

👉 Nếu một máy có nhiều user mà tất cả đều bị ảnh hưởng → kiểm tra nhánh này đầu tiên.

***

#### 2.2. Startup theo từng người dùng (Current User)

```
HKEY_CURRENT_USER\Software\Microsoft\Windows\CurrentVersion\Run
```

* Chỉ ảnh hưởng tới user đang đăng nhập
* Phổ biến với app cá nhân: chat, cloud sync, launcher

👉 Đây là nơi an toàn nhất để tối ưu startup mà **không ảnh hưởng user khác**.

***

#### 2.3. Nhánh RunOnce – chạy một lần duy nhất

```
HKEY_LOCAL_MACHINE\...\RunOnce
HKEY_CURRENT_USER\...\RunOnce
```

* Thường dùng cho:
  * Hoàn tất cài đặt phần mềm
  * Script cấu hình sau update
* Sau khi chạy xong sẽ **tự động bị xóa**

👉 Nếu thấy app chạy “chỉ một lần rồi biến mất”, khả năng cao là từ RunOnce.

***

### 3. Cách đọc và hiểu giá trị trong Registry Startup

Một entry startup thường có cấu trúc:

* **Name**: Tên logic (không nhất thiết là tên file)
* **Value**: Đường dẫn file thực thi

Ví dụ:

```
Name: OneDrive
Value: "C:\Program Files\Microsoft OneDrive\OneDrive.exe" /background
```

#### Kinh nghiệm thực tế:

* Đường dẫn **không tồn tại** → entry rác, có thể xóa
* File nằm trong `Temp`, `AppData` bất thường → cần cảnh giác
* Có tham số lạ → kiểm tra kỹ trước khi cho chạy

***

### 4. Cách vô hiệu hóa ứng dụng khởi động an toàn

#### Nguyên tắc vàng:

> **Không xóa vội – hãy vô hiệu hóa trước**

#### Các cách làm an toàn:

* Export key Registry trước khi chỉnh sửa
* Comment bằng cách đổi tên value (thêm `_disabled`)
* Ghi chú lại trạng thái ban đầu để rollback

Đây là tư duy **production mindset**: luôn có đường lui.

***

### 5. Khi nào nên dùng Registry thay vì Task Manager?

| Tình huống              | Công cụ phù hợp     |
| ----------------------- | ------------------- |
| App hiển thị rõ         | Task Manager        |
| App ẩn, không rõ nguồn  | Registry Editor     |
| Debug malware           | Registry + Autoruns |
| Tối ưu hệ thống lâu dài | Registry            |

Registry không dành cho thao tác vội vàng, mà dành cho **kiểm soát có chủ đích**.

***

### 6. Góc nhìn hệ thống: Startup là một phần của hiệu năng tổng thể

Quản lý startup không chỉ giúp:

* Máy khởi động nhanh hơn
* Giảm RAM, CPU nền

Mà còn:

* Giảm surface attack
* Tăng độ ổn định hệ thống
* Dễ debug khi có sự cố production (đặc biệt với máy dev/test)

Đây chính là tư duy mà **NQDEV Platform** luôn hướng tới:\
👉 *Hiểu tận gốc – kiểm soát toàn cục – tối ưu bền vững.*

***

### Kết luận

Registry Editor không phải công cụ “nguy hiểm”, mà là **công cụ quyền lực** nếu bạn hiểu mình đang làm gì. Khi nắm được cơ chế startup của Windows, bạn không còn phụ thuộc vào giao diện hay tool bên ngoài, mà **chủ động làm chủ hệ thống của mình**.

Nếu bạn muốn đào sâu hơn về:

* Debug Windows
* Hiệu năng hệ điều hành
* Tư duy vận hành hệ thống cho Dev

👉 Hãy tiếp tục theo dõi các bài viết tại **Cẩm nang NQDEV**\
🔗 <https://blogs.nhquydev.net/>


# Quản lý dịch vụ Windows bằng: net start và sc

Hướng dẫn dùng lệnh net start và sc để quản lý, khởi động, dừng, tạo và cấu hình dịch vụ Windows, kèm ví dụ và script tự động hóa thực tế.

### 1. Giới thiệu

Trong hệ điều hành **Windows**, các **dịch vụ (services)** đóng vai trò quan trọng trong việc duy trì hoạt động ổn định của hệ thống – từ in ấn, mạng, bảo mật cho đến phần mềm chạy nền.

Để quản lý các dịch vụ này, Windows cung cấp hai công cụ dòng lệnh mạnh mẽ:

* **`net start` / `net stop`** – dùng để **bật hoặc tắt dịch vụ** nhanh chóng.
* **`sc` (Service Control)** – cho phép **tạo, xóa, cấu hình và kiểm tra chi tiết dịch vụ**.

Bài viết này sẽ hướng dẫn bạn **từng bước từ cơ bản đến nâng cao**, giúp bạn nắm rõ cách dùng, điểm khác biệt và ứng dụng thực tế của hai công cụ này.

***

### 2. Lệnh `net start` – Quản lý dịch vụ cơ bản

#### ✅ Cú pháp:

```
net start [tên_dịch_vụ]
```

#### 🔹 Một số ví dụ phổ biến:

1. **Xem danh sách các dịch vụ đang chạy:**

   ```
   net start
   ```
2. **Khởi động một dịch vụ cụ thể (ví dụ Print Spooler):**

   ```
   net start "Print Spooler"
   ```
3. **Dừng dịch vụ:**

   ```
   net stop "Print Spooler"
   ```

🟢 **Ưu điểm:**

* Dễ dùng, nhanh chóng.
* Phù hợp khi bạn chỉ cần bật/tắt dịch vụ.

🔴 **Hạn chế:**

* Không thể tạo, cấu hình hoặc xóa dịch vụ.
* Không hiển thị chi tiết trạng thái.

***

### 3. Lệnh `sc` – Công cụ điều khiển dịch vụ nâng cao

`sc` (Service Control) là công cụ dòng lệnh mạnh mẽ giúp bạn tương tác sâu hơn với hệ thống dịch vụ Windows.

#### ✅ Cú pháp chung:

```
sc [lệnh] [tên_dịch_vụ] [các_tham_số_khác]
```

#### 📋 Các lệnh thông dụng nhất:

| Lệnh        | Chức năng                   |
| ----------- | --------------------------- |
| `sc start`  | Khởi động dịch vụ           |
| `sc stop`   | Dừng dịch vụ                |
| `sc delete` | Xóa dịch vụ                 |
| `sc query`  | Kiểm tra trạng thái dịch vụ |
| `sc create` | Tạo dịch vụ mới             |
| `sc config` | Cấu hình thông số dịch vụ   |

***

### 4. Tạo dịch vụ tùy chỉnh bằng `sc create`

Khi bạn cần chạy một ứng dụng hoặc tiến trình nền như một dịch vụ Windows, hãy dùng `sc create`.

#### 🧾 Cú pháp:

```
sc create [Tên_dịch_vụ] binPath= "[Đường_dẫn_đến_file_thực_thi]" start= [kiểu_khởi_động]
```

#### 📘 Ví dụ:

Tạo dịch vụ tên **MyService** chạy tự động khi khởi động máy:

```
sc create MyService binPath= "C:\Tools\MyApp.exe" start= auto
```

> ⚠️ **Lưu ý:** Sau dấu `=` cần có khoảng trắng (`start= auto`), và file `.exe` phải hỗ trợ chạy dạng dịch vụ.

***

### 5. Kiểm tra và cấu hình dịch vụ bằng `sc`

#### 🔹 Kiểm tra trạng thái dịch vụ:

```
sc query MyService
```

Kết quả hiển thị:

```
SERVICE_NAME: MyService
        TYPE               : 10  WIN32_OWN_PROCESS
        STATE              : 4  RUNNING
```

* `STATE: 4 RUNNING` → dịch vụ đang chạy
* `STATE: 1 STOPPED` → dịch vụ đã dừng

#### 🔹 Cấu hình kiểu khởi động:

```
sc config MyService start= auto
```

| Giá trị    | Ý nghĩa                        |
| ---------- | ------------------------------ |
| `auto`     | Tự động khởi động cùng Windows |
| `demand`   | Khởi động thủ công             |
| `disabled` | Vô hiệu hóa dịch vụ            |

***

### 6. So sánh nhanh `net start` và `sc`

| Tiêu chí                     | `net start` / `net stop` | `sc`                         |
| ---------------------------- | ------------------------ | ---------------------------- |
| Mức độ phức tạp              | Dễ dùng                  | Nâng cao                     |
| Chức năng chính              | Bật/tắt dịch vụ          | Quản lý toàn diện            |
| Tạo/xóa dịch vụ              | ❌ Không                  | ✅ Có                         |
| Hiển thị trạng thái chi tiết | ❌ Không                  | ✅ Có (`sc query`)            |
| Đối tượng phù hợp            | Người dùng phổ thông     | Quản trị viên, kỹ thuật viên |

***

### 7. Tự động hóa quản lý dịch vụ bằng file Batch (.bat)

Khi bạn cần thao tác thường xuyên, việc dùng **file `.bat`** sẽ giúp tiết kiệm thời gian và tự động hóa quá trình.

***

#### 🧩 Ví dụ 1 – Trình quản lý dịch vụ mini

**📄 File: `service-control.bat`**

```bat
@echo off
title Trinh quan ly dich vu Windows
echo =========================================
echo      CONG CU QUAN LY DICH VU WINDOWS
echo =========================================
echo.
echo 1. Kiem tra trang thai dich vu
echo 2. Khoi dong dich vu
echo 3. Dung dich vu
echo 4. Xoa dich vu
echo 5. Thoat
echo.

set /p choice=Nhap lua chon (1-5): 
set /p service=Nhap ten dich vu: 

if "%choice%"=="1" (
    sc query "%service%"
) else if "%choice%"=="2" (
    net start "%service%"
) else if "%choice%"=="3" (
    net stop "%service%"
) else if "%choice%"=="4" (
    sc stop "%service%"
    sc delete "%service%"
    echo Da xoa dich vu "%service%"
) else (
    echo Tam biet!
)
pause
```

💡 *Cách dùng:*

* Lưu file `.bat` → chạy với quyền **Administrator**
* Nhập số tương ứng với thao tác bạn muốn thực hiện.

***

#### 🧩 Ví dụ 2 – Tự động kiểm tra và khởi động lại dịch vụ bị dừng

**📄 File: `auto-restart-service.bat`**

```bat
@echo off
set servicename=MyService

:loop
sc query "%servicename%" | find "RUNNING" >nul
if errorlevel 1 (
    echo [%date% %time%] Dich vu %servicename% khong chay. Dang khoi dong lai...
    net start "%servicename%"
) else (
    echo [%date% %time%] Dich vu %servicename% van dang hoat dong.
)
timeout /t 60 >nul
goto loop
```

✅ **Tác dụng:**

* Kiểm tra dịch vụ mỗi 60 giây.
* Nếu phát hiện dừng → tự động khởi động lại.
* Có thể chạy ẩn bằng **Task Scheduler** khi khởi động Windows.

***

### 8. Mẹo và thủ thuật hữu ích

| Nhiệm vụ                           | Lệnh tương ứng                                 |
| ---------------------------------- | ---------------------------------------------- |
| Xem toàn bộ dịch vụ (kể cả dừng)   | `sc query type= service state= all`            |
| Ghi log trạng thái dịch vụ ra file | `sc query MyService >> C:\Logs\service.log`    |
| Dừng rồi khởi động lại dịch vụ     | `net stop MyService && net start MyService`    |
| Tự động chạy script khi bật máy    | Dùng **Task Scheduler** → Trigger “At startup” |

***

### 9. Kết luận – Làm chủ dòng lệnh, tối ưu hệ thống

Khi nắm vững `net start` và `sc`, bạn có thể:

* **Kiểm soát toàn bộ dịch vụ Windows** bằng vài dòng lệnh.
* **Tự động hóa** việc khởi động, dừng, khởi tạo hoặc khắc phục lỗi dịch vụ.
* **Tiết kiệm thời gian** và giảm rủi ro thao tác sai trong môi trường thực tế.

{% hint style="info" %}
💬 **Gợi ý cho người dùng nâng cao:**\
Bạn có thể kết hợp thêm **PowerShell** để tạo log chi tiết, gửi thông báo, hoặc tự động khởi động lại dịch vụ khi phát hiện sự cố – giúp quản lý hệ thống chuyên nghiệp hơn nữa.
{% endhint %}


# PowerShell ISE


# Hướng dẫn kiểm tra, bật và tắt logging tường lửa Windows

Trong quá trình vận hành hệ thống hoặc debug kết nối (SSH, HTTP, database…), việc bị chặn bởi Windows Firewall là tình huống rất phổ biến nhưng lại khó phát hiện nếu không có log.

Bài viết này trong **Cẩm nang NQDEV** sẽ giúp bạn:

* Hiểu cách kiểm tra trạng thái logging của firewall
* Bật log để theo dõi gói tin bị chặn / cho phép
* Đọc log để phân tích nguyên nhân
* Tắt log khi không còn cần thiết

👉 Tham khảo thêm tại: [**Cẩm nang NQDEV**](https://blogs.nhquydev.net/) để cập nhật các hướng dẫn thực tế khác trên **NQDEV Platform**.

***

### 1. Khi nào bạn nên bật logging Firewall?

Bạn nên bật log khi gặp các tình huống như:

* Không kết nối được đến server (timeout, connection refused)
* Service chạy bình thường nhưng không truy cập được từ bên ngoài
* Nghi ngờ firewall đang chặn port hoặc IP

👉 Logging sẽ giúp bạn trả lời câu hỏi quan trọng:

> **Gói tin có bị firewall drop hay không?**

***

### 2. Kiểm tra trạng thái logging hiện tại

Mở **PowerShell (Run as Administrator)** và chạy:

```
Get-NetFirewallProfile | Select Name, Enabled, LogFileName, LogAllowed, LogBlocked
```

#### Ý nghĩa:

* `LogFileName`: đường dẫn file log
* `LogAllowed`: có log gói tin được phép không
* `LogBlocked`: có log gói tin bị chặn không

👉 Nếu `False` → logging đang tắt

***

### 3. Bật logging tường lửa Windows

#### Lệnh bật log đầy đủ (khuyến nghị khi debug):

```
Set-NetFirewallProfile -Profile Private,Public `
-LogFileName "C:\Windows\System32\LogFiles\Firewall\pfirewall.log" `
-LogAllowed True `
-LogBlocked True
```

#### Giải thích:

* `Private, Public`: áp dụng cho mạng nội bộ & mạng công cộng
* `LogAllowed True`: ghi log các kết nối được phép
* `LogBlocked True`: ghi log các kết nối bị chặn

👉 Trong thực tế:

* Chỉ cần bật `LogBlocked` là đủ để debug nhanh
* `LogAllowed` nên bật khi cần phân tích sâu

***

### 4. Vị trí file log Firewall

File log mặc định:

```
C:\Windows\System32\LogFiles\Firewall\pfirewall.log
```

#### Cách mở nhanh:

* Dùng Notepad
* Hoặc PowerShell:

```
notepad C:\Windows\System32\LogFiles\Firewall\pfirewall.log
```

***

### 5. Cách đọc log Firewall (rất quan trọng)

<figure><img src="https://raw.githubusercontent.com/nqdev-storage/s3-001/main/gitbook/blogs/cong-nghe/windows/powershell-ise/ps-wf-001.jpg" alt=""><figcaption></figcaption></figure>

<figure><img src="https://raw.githubusercontent.com/nqdev-storage/s3-001/main/gitbook/blogs/cong-nghe/windows/powershell-ise/ps-wf-002.jpg" alt=""><figcaption></figcaption></figure>

<figure><img src="https://raw.githubusercontent.com/nqdev-storage/s3-001/main/gitbook/blogs/cong-nghe/windows/powershell-ise/ps-wf-004.jpg" alt=""><figcaption></figcaption></figure>

Một dòng log mẫu:

```
2026-03-22 10:15:30 DROP TCP 192.168.1.10 192.168.1.20 12345 80 ...
```

#### Ý nghĩa nhanh:

* `DROP` → bị chặn ❌
* `ALLOW` → được phép ✅
* `TCP/UDP` → giao thức
* `IP nguồn → IP đích`
* `Port nguồn → Port đích`

👉 Ví dụ:

* Nếu thấy `DROP TCP ... port 3306` → MySQL bị chặn
* Nếu thấy `DROP TCP ... port 22` → SSH bị chặn

***

### 6. Test lại kết nối sau khi bật log

Sau khi bật logging:

1. Thử lại kết nối (curl, telnet, browser…)
2. Mở file log
3. Tìm theo:
   * IP
   * Port
   * Thời gian

👉 Đây là cách debug nhanh nhất khi deploy trên **NQDEV Platform** hoặc server Windows.

***

### 7. Tắt logging khi không cần thiết

Logging liên tục có thể:

* Làm file log rất lớn
* Ảnh hưởng hiệu năng (nhẹ nhưng đáng lưu ý)

#### Tắt log:

```
Set-NetFirewallProfile -Profile Private,Public `
-LogAllowed False `
-LogBlocked False
```

***

### 8. Best Practices (kinh nghiệm thực tế)

* Chỉ bật log khi debug → tắt sau khi xong
* Luôn kiểm tra `DROP` trước khi nghi ngờ ứng dụng
* Kết hợp với:
  * `netstat -an`
  * `Test-NetConnection`
* Nếu không có log → vấn đề có thể không nằm ở firewall

***

### Kết luận

Logging của Windows Firewall là một công cụ cực kỳ mạnh nhưng thường bị bỏ qua. Khi biết cách sử dụng đúng, bạn có thể:

* Xác định chính xác nguyên nhân lỗi kết nối
* Tránh mất thời gian debug sai hướng
* Hiểu rõ hơn cách hệ thống mạng hoạt động

Trong hệ sinh thái vận hành hiện đại, đặc biệt khi làm việc với cloud, container hay CI/CD trên **NQDEV Platform**, việc nắm vững kỹ năng này sẽ giúp bạn xử lý sự cố nhanh và chính xác hơn rất nhiều.


# VMware


# Cách ảo hóa macOS Sierra trong VMWare Windows 10

Ảo hóa hệ điều hành là một thứ ngày càng phổ biến trong giới hâm mộ công nghệ, vì nó cho phép chúng ta có hai hệ điều hành trên cùng một máy tính. Một ví dụ về điều này là ảo hóa Mac OS X El Capitan bằng VirtualBox hoặc trường hợp ngược lại, đó là ảo hóa Windows 10 trên Mac

Với sự xuất hiện của hệ điều hành mới của Apple có tên macOS Sierra cách đây không lâu, nhiều người dùng rất muốn dùng thử các tính năng và phạm vi mới của hệ thống mới và tuyệt vời này, nhưng họ không luôn có nguồn tài chính để mua máy tính Mac với giá cao. và do đó, giải pháp thiết thực nhất là triển khai **ảo hóa Mac OS Sierra trong môi trường Windows 10** .

Chúng tôi biết sự không tương thích về nhiều mặt giữa các hệ điều hành Windows và Mac OS nhưng trong phân tích này, chúng tôi sẽ xem cách chúng tôi có thể gắn máy ảo Mac OS Sierra trong môi trường VMware trong Windows 10. Công cụ VMware có thể được tải xuống từ liên kết sau.

Tải xuống VMware

Có thể tải xuống các công cụ để tạo **bản vá VMware và hỗ trợ Mac OS tương ứng** từ liên kết sau:

<figure><img src="broken://files/EcNY8XOY3CUJ8AsuOO8v" alt=""><figcaption></figcaption></figure>

**mở khóa208.zip 9.61MB** 10345 Tải xuống

### **1.** Tạo máy ảo trong VMware Windows 10

\
Bước 1\
Bước đầu tiên chúng ta phải thực hiện là sử dụng công cụ vá để kích hoạt hỗ trợ VMware cho máy macOS Sierra. Để làm điều này, chúng tôi đi đến tập tin được tải xuống đường dẫn:

```
 Tất cả Công cụ / Công cụ vá / công cụ mở khóa208 
```

Ở đó chúng ta phải nhấp chuột phải vào tệp **win-install** và chọn tùy chọn **Chạy với tư cách quản trị viên**

<figure><img src="broken://files/EcNY8XOY3CUJ8AsuOO8v" alt=""><figcaption></figcaption></figure>

Khi chúng tôi chọn tùy chọn này, chúng tôi sẽ thấy rằng dấu nhắc lệnh mở ra và chúng tôi hy vọng rằng quy trình được thực hiện tự động.

Bước 2 Khi quá trình này được thực hiện, chúng tôi tiến hành mở VMware và chúng tôi sẽ thấy như sau:


# Tự tin làm chủ mạng lưới: Cẩm nang tính toán địa chỉ IP từ A đến Z

## Tìm hiểu về cách tính địa chỉ IP

Địa chỉ IP (Internet Protocol) là một mã số định danh duy nhất được gán cho mỗi thiết bị kết nối với mạng internet. Nó đóng vai trò như địa chỉ nhà của thiết bị trên mạng, giúp các thiết bị khác có thể định vị và giao tiếp với nhau.

Bài viết này sẽ hướng dẫn bạn cách tính địa chỉ IP, bao gồm phân tích địa chỉ IP, giải thích công thức tính lớp và VLAN của địa chỉ IP.

## **Phân tích địa chỉ IP:**

Địa chỉ IP được chia thành 4 phần, mỗi phần được biểu diễn bởi một số thập phân từ 0 đến 255. Các phần này được ngăn cách nhau bởi dấu chấm. Ví dụ: 192.168.1.1 là một địa chỉ IP.

### **Công thức tính lớp:**

Địa chỉ IP được chia thành 5 lớp: A, B, C, D và E. Lớp mạng được xác định bởi 8 bit đầu tiên của địa chỉ IP. Dưới đây là công thức tính lớp địa chỉ IP:

* Lớp A: 0 - 127 (126 mạng)
* Lớp B: 128 - 191 (16384 mạng)
* Lớp C: 192 - 223 (2.097.152 mạng)
* Lớp D: 224 - 239 (được sử dụng cho multicast)
* Lớp E: 240 - 254 (được sử dụng cho nghiên cứu)

### **VLAN:**

VLAN (Virtual Local Area Network) là một mạng LAN ảo được tạo ra trên một mạng LAN vật lý. VLAN giúp chia nhỏ mạng LAN thành các nhóm nhỏ hơn, giúp tăng cường bảo mật và quản lý mạng hiệu quả hơn.

## **Cách tính địa chỉ IP:**

Để tính địa chỉ IP, bạn cần biết:

* Lớp mạng
* Số mạng con
* Số máy chủ trong mỗi mạng con

### **Công thức tính địa chỉ IP:**

* Địa chỉ mạng: Lấy số mạng và dịch sang hệ nhị phân.
* Địa chỉ mạng con: Lấy số mạng con và dịch sang hệ nhị phân.
* Địa chỉ máy chủ: Lấy số máy chủ và dịch sang hệ nhị phân.

#### **Ví dụ:**

Giả sử bạn muốn tính địa chỉ IP cho mạng sau:

* Lớp mạng: B
* Số mạng con: 254
* Số máy chủ trong mỗi mạng con: 254

### **Địa chỉ mạng:**

Lớp B có 8 bit đầu tiên là 10 (1010 trong hệ nhị phân).

#### **Địa chỉ mạng con:**

Số mạng con 254 được dịch sang hệ nhị phân là 11111110.

#### **Địa chỉ máy chủ:**

Số máy chủ 254 được dịch sang hệ nhị phân là 11111110.

#### **Địa chỉ IP:**

Kết hợp các phần địa chỉ mạng, mạng con và máy chủ, ta có địa chỉ IP là:

1010.11111110.11111110

## **Kết luận:**

Bài viết này đã hướng dẫn bạn cách tính địa chỉ IP, bao gồm phân tích địa chỉ IP, giải thích công thức tính lớp và VLAN của địa chỉ IP.

### **Lưu ý:**

Bài viết này chỉ cung cấp thông tin cơ bản về cách tính địa chỉ IP. Để có thể tính toán chính xác địa chỉ IP cho mạng của bạn, bạn cần tham khảo thêm các tài liệu chuyên môn và có kiến thức về mạng máy tính.

<img src="https://twemoji.maxcdn.com/v/14.0.2/72x72/2615.png" alt="☕️" data-size="line"><img src="https://twemoji.maxcdn.com/v/14.0.2/72x72/2615.png" alt="☕️" data-size="line"> *Nếu thấy nội dung này bổ ích, hãy mời tôi một tách cà phê nha!* [***https://me.momo.vn/nhquydev***](https://me.momo.vn/nhquydev)


# Container & Infra


# Docker

Docker là một nền tảng mở, giúp tự động hóa việc triển khai ứng dụng trong môi trường được đóng gói, gọi là container.


# Getting Started with Docker

Docker - Beginners | Intermediate | Advanced

Chào mừng bạn đến với thế giới của Docker - một công cụ tuyệt vời mà mọi nhà phát triển phần mềm cần biết. Docker là một nền tảng mở, giúp tự động hóa việc triển khai ứng dụng trong môi trường được đóng gói, gọi là container. Với Docker, bạn có thể dễ dàng tạo, triển khai và chạy ứng dụng của mình trên bất kỳ máy tính nào mà không cần lo lắng về việc cài đặt môi trường phần mềm phức tạp. Hãy cùng tôi khám phá Docker từ cơ bản đến nâng cao và tại sao bạn nên bắt đầu sử dụng nó ngay hôm nay!

## 1. Docker là gì? <a href="#id-1-docker-la-gi" id="id-1-docker-la-gi"></a>

Docker là một nền tảng phát triển ứng dụng dựa trên ý tưởng tạo ra các container. Một container giống như một chiếc hộp mà bạn có thể đóng gói tất cả những gì cần thiết để chạy ứng dụng của mình: mã nguồn, thư viện, biến môi trường, và cả hệ điều hành vi mô. Mỗi container là một môi trường riêng biệt, đảm bảo rằng ứng dụng của bạn chạy nhất quán ở mọi nơi.

## 2. Lợi ích của việc sử dụng Docker <a href="#id-2-loi-ich-cua-viec-su-dung-docker" id="id-2-loi-ich-cua-viec-su-dung-docker"></a>

Docker mang lại nhiều lợi ích:

* **Nhất quán và cô lập**: Docker giúp mỗi ứng dụng chạy trong một môi trường nhất quán và độc lập, từ đó giảm thiểu "lỗi máy tính khác nhau".
* **Cải thiện hiệu suất phát triển**: Bạn có thể nhanh chóng chia sẻ, sao chép và sao lưu môi trường làm việc mà không cần cài đặt từ đầu.
* **Tối ưu hóa tài nguyên**: Docker sử dụng tài nguyên hệ thống hiệu quả hơn so với các máy ảo truyền thống.
* **Phát triển liên tục và triển khai nhanh**: Docker hỗ trợ quy trình phát triển software hiện đại, cho phép triển khai nhanh chóng và dễ dàng.

## 3. Cách bắt đầu với Docker <a href="#id-3-cach-bat-dau-voi-docker" id="id-3-cach-bat-dau-voi-docker"></a>

Để bắt đầu với Docker, bạn chỉ cần theo các bước đơn giản sau:

* **Cài đặt Docker Desktop**: Tải về và cài đặt Docker Desktop trên máy tính của bạn. Docker hỗ trợ cả Windows và MacOS.
* **Học từ Docker Tutorials**: Có hơn 500+ hướng dẫn và bài viết từ cơ bản đến nâng cao để bạn có thể tìm hiểu một cách bài bản.
* **Tham gia cộng đồng**: Gia nhập cộng đồng Slack hoặc Discord của Docker để nhận sự hỗ trợ và chia sẻ kiến thức với các nhà phát triển khác.
* **Làm quen với DockerLabs**: Truy cập vào kho lưu trữ trên GitHub để fork, đóng góp và chia sẻ với cộng đồng.

### 3.1 Để bắt đầu sử dụng Docker, bạn có thể làm theo các bước cơ bản sau đây:

1. **Tải về và cài đặt Docker Desktop**: Truy cập trang web chính thức của Docker (<https://www.docker.com/>) và tải về Docker Desktop phù hợp với hệ điều hành của bạn (Windows, macOS hoặc Linux). Theo hướng dẫn trên trang để cài đặt Docker Desktop.
2. **Tạo tài khoản DockerHub**: DockerHub là một dịch vụ lưu trữ cho các Docker image. Việc tạo một tài khoản sẽ giúp bạn tải lên, tải xuống và quản lý các images của mình. Truy cập <https://hub.docker.com/> để đăng ký một tài khoản miễn phí.
3. **Thực hành với Hello World**: Học cách chạy một example đơn giản để hiểu cách Docker hoạt động. Bạn có thể mở Terminal hoặc Command Prompt và nhập lệnh sau:

{% code title="terminal" overflow="wrap" lineNumbers="true" %}

```bash
docker run hello-world
```

{% endcode %}

Lệnh này sẽ tải xuống và chạy một container từ image `hello-world`.

4. **Làm việc với Docker Image**: Học cách tìm kiếm và tải xuống các images từ DockerHub, sau đó chạy chúng dưới dạng containers. Thêm vào đó, học cách tạo Dockerfile để tạo ra Docker image cho ứng dụng của bạn.
5. **Lưu và chia sẻ Containers và Images**: Học cách lưu containers và images của bạn dưới dạng file `.tar` để có thể dễ dàng chia sẻ chúng với người khác.
6. **Tham gia cộng đồng**: Do Docker là một công cụ phổ biến và có một cộng đồng lớn, bạn có thể học hỏi rất nhiều từ kinh nghiệm của những nhà phát triển khác. Hãy tham gia vào các nhóm trên Slack hoặc Discord mà Docker cung cấp.
7. **Khám phá tài liệu và học liệu**: Sử dụng tài liệu hướng dẫn, cảm nhận từ cộng đồng và tài liệu chính thức từ Docker để học hỏi. Các nguồn này cung cấp một lượng lớn thông tin từ cơ bản đến nâng cao để bạn nắm vững Docker.

Nhớ rằng, việc học cách sử dụng Docker cần thời gian và thực hành. Đừng ngần ngại thực hành nhiều lần và tìm kiếm sự trợ giúp từ cộng đồng nếu bạn gặp khó khăn.

## 4. Học hỏi và chia sẻ <a href="#id-4-hoc-hoi-va-chia-se" id="id-4-hoc-hoi-va-chia-se"></a>

Khi bạn đã sẵn sàng đắm chìm vào thế giới Docker, đừng ngần ngại thử nghiệm và xây dựng các dự án của riêng bạn. Học hỏi từ cộng đồng, chia sẻ và nhận phản hồi từ những người khác để cải thiện kỹ năng của bạn. Docker không ngừng đổi mới và cập nhật, vì vậy hãy theo dõi các bài viết và bản cập nhật mới nhất để không bị lạc hậu.\
Ứng dụng Docker vào quy trình phát triển của bạn, và bạn sẽ nhanh chóng thấy được sự khác biệt trong việc triển khai và quản lý ứng dụng. Đó chính là khởi đầu của một hành trình mới - một hành trình mà ở đó sự sáng tạo và hiệu năng đi đôi với sự tiện lợi và linh hoạt. Chúc bạn may mắn và thành công với Docker!


# Hướng dẫn di chuyển Containerd sang partition khác để giải phóng dung lượng root filesystem Ubuntu

Hướng dẫn chi tiết di chuyển containerd từ root filesystem (/) sang partition khác để giải phóng dung lượng, tránh lỗi Disk Full trên Ubuntu Linux với Docker.

Khi root filesystem bị đầy do containerd snapshots chiếm quá nhiều dung lượng — dù các partition khác vẫn còn trống — bạn cần di chuyển containerd data sang partition có dung lượng trống để giải phóng dung lượng cho hệ thống. Hướng dẫn này giúp bạn thực hiện điều đó một cách an toàn và nhanh chóng.

***

## **1. Vấn đề gặp phải**

Triển khai Docker trên Ubuntu, bạn có thể gặp tình huống:

* **Root filesystem đầy trên 80-90%** trong khi các partition khác vẫn còn rất nhiều dung lượng trống.
* Docker containers vẫn hoạt động bình thường nhưng hệ thống cảnh báo dung lượng thấp.
* Lỗi `no space left on device` xuất hiện khi trying pull image hoặc tạo container mới.

Ví dụ thực tế:

```bash
df -h /
# Filesystem      Size  Used Avail Use% Mounted on
# /dev/sda1        54G   47G  4.2G  92% /

df -h /mnt/e02
# /dev/mapper/vg01-lv_data  500G  100G  380G  21% /mnt/e02
```

Root filesystem đã đầy **92%** trong khi partition `/mnt/e02` chỉ dùng **21%**.

***

## **2. Nguyên nhân**

Containerd lưu trữ snapshots của Docker images trên root filesystem tại đường dẫn mặc định:

* **Docker data:** Có thể đã được cấu hình ở partition khác (ví dụ: `/mnt/e02/docker`).
* **Containerd snapshots:** Vẫn nằm trên root filesystem tại `/var/lib/containerd/`.
* **Overlay Layers:** Docker containers sử dụng overlay filesystem được store trong containerd snapshots.

Cấu trúc phụ thuộc:

```
Overlay Layers (Docker containers)
  └── Containerd Snapshots (root filesystem /var/lib/containerd/)
        └── Chứa images, base layers, container layers
```

Vì vậy dù Docker data đã ở partition khác, dung lượng root filesystem vẫn bị chiếm dụng bởi containerd snapshots.

***

## **3. Giải pháp**

Di chuyển containerd data từ `/var/lib/containerd` sang partition có dung lượng trống (ví dụ: `/mnt/e02/uenv/var/lib/containerd`).

Lợi ích của phương pháp này:

* **Giải phóng root filesystem:** Ví dụ từ 92% xuống còn 40%.
* **Tận dụng dung lượng partition khác:** Partition trống trở thành nơi lưu trữ chính.
* **Không mất Docker containers:** Containers vẫn hoạt động bình thường sau khi migrate.
* **Không cần thay đổi Docker config:** Docker daemon vẫn sử dụng cấu hình hiện tại.
* **Thời gian thực hiện nhanh:** Chỉ \~5-10 phút cho \~27GB dữ liệu trên SSD.

***

## **4. Yêu cầu trước khi thực hiện**

Trước khi bắt đầu, đảm bảo hệ thống đáp ứng các yêu cầu sau:

* **Hệ điều hành:** Ubuntu 24.04 LTS (hoặc các bản phân phối Linux khác).
* **Docker:** Docker CE (latest version).
* **Containerd:** v1.7 trở lên.
* **Filesystem:** LVM + ext4 hoặc tương đương.
* **Quyền:** sudo/root access.
* **Partition đích:** Có dung lượng trống >20GB.

***

## **5. Hướng dẫn chi tiết**

### **Bước 1: Kiểm tra tình trạng hiện tại**

Trước khi thực hiện, kiểm tra dung lượng root filesystem, partition đích, dung lượng containerd, và Docker config:

{% code title="Kiểm tra dung lượng" overflow="wrap" lineNumbers="true" %}

```bash
# Kiểm tra dung lượng root filesystem
df -h /

# Kiểm tra dung lượng partition đích
df -h /mnt/e02

# Kiểm tra dung lượng containerd hiện tại
sudo du -sh /var/lib/containerd

# Kiểm tra Docker daemon config
cat /etc/docker/daemon.json
```

{% endcode %}

Kết quả mong đợi:

* **Root filesystem:** >80% used.
* **Containerd:** >10GB.
* **Partition đích:** >100GB available.

### **Bước 2: Dừng Docker và Containerd**

Dừng các dịch vụ Docker và Containerd trước khi di chuyển dữ liệu:

{% code title="Dừng services" overflow="wrap" lineNumbers="true" %}

```bash
sudo systemctl stop docker
sudo systemctl stop containerd

# Xác nhận đã dừng
sudo systemctl is-active docker containerd
```

{% endcode %}

{% hint style="warning" %}
Tất cả containers sẽ bị dừng trong quá trình thực hiện. Hãy thông báo cho team/users trước khi bắt đầu.
{% endhint %}

### **Bước 3: Tạo thư mục đích**

Tạo thư mục trên partition đích để lưu containerd data:

{% code title="Tạo thư mục đích" overflow="wrap" lineNumbers="true" %}

```bash
sudo mkdir -p /mnt/e02/uenv/var/lib/containerd

# Xác nhận thư mục đã tạo
ls -ld /mnt/e02/uenv/var/lib/containerd
```

{% endcode %}

### **Bước 4: Di chuyển dữ liệu**

Di chuyển toàn bộ dữ liệu containerd từ root filesystem sang partition đích:

{% code title="Di chuyển dữ liệu containerd" overflow="wrap" lineNumbers="true" %}

```bash
# Di chuyển dữ liệu
sudo mv /var/lib/containerd/* /mnt/e02/uenv/var/lib/containerd/ 2>/dev/null || true

# Kiểm tra dung lượng sau di chuyển
sudo du -sh /var/lib/containerd
sudo du -sh /mnt/e02/uenv/var/lib/containerd
```

{% endcode %}

Kết quả mong đợi:

* `/var/lib/containerd` = 4.0K (rỗng).
* `/mnt/e02/uenv/var/lib/containerd` = \~27GB.

### **Bước 5: Sửa cấu hình Containerd**

Backup config hiện tại và sửa `root =` trong `/etc/containerd/config.toml`:

{% code title="Backup và sửa config" overflow="wrap" lineNumbers="true" %}

```bash
# Backup config
sudo cp /etc/containerd/config.toml /etc/containerd/config.toml.bak

# Sửa config
sudo nano /etc/containerd/config.toml
```

{% endcode %}

Thay đổi dòng `root`:

```
# Trước
root = "/var/lib/containerd"

# Sau
root = "/mnt/e02/uenv/var/lib/containerd"
```

### **Bước 6: Khởi động lại services**

Khởi động lại Containerd và Docker để áp dụng cấu hình mới:

{% code title="Khởi động services" overflow="wrap" lineNumbers="true" %}

```bash
sudo systemctl start containerd
sudo systemctl start docker

# Kiểm tra trạng thái
sudo systemctl status containerd docker
```

{% endcode %}

### **Bước 7: Xác minh containers chạy bình thường**

Sau khi khởi động, kiểm tra Docker hoạt động bình thường:

{% code title="Xác minh Docker" overflow="wrap" lineNumbers="true" %}

```bash
# Danh sách containers đang chạy
sudo docker ps

# Kiểm tra Docker Root Dir
sudo docker info | grep "Docker Root Dir"

# Chạy thử container
sudo docker run --rm alpine echo "Hello World"
```

{% endcode %}

***

## **6. Xác minh kết quả**

Sau khi hoàn thành, kiểm tra kỹ lưỡng các khía cạnh sau:

### **Kiểm tra dung lượng filesystem**

{% code title="Kiểm tra dung lượng" overflow="wrap" lineNumbers="true" %}

```bash
df -h /
df -h /mnt/e02
sudo du -sh /var/lib/containerd
sudo du -sh /mnt/e02/uenv/var/lib/containerd
```

{% endcode %}

### **Kiểm tra Containerd config**

{% code title="Kiểm tra config" overflow="wrap" lineNumbers="true" %}

```bash
grep "^root = " /etc/containerd/config.toml
sudo ctr snapshots list | head -5
```

{% endcode %}

### **Kiểm tra Docker operation**

{% code title="Kiểm tra Docker" overflow="wrap" lineNumbers="true" %}

```bash
sudo docker images | head -5
sudo docker volume ls
```

{% endcode %}

***

## **7. Troubleshooting**

### **Lỗi "permission denied" khi di chuyển dữ liệu**

{% code title="Fix permission" overflow="wrap" lineNumbers="true" %}

```bash
sudo chown -R root:root /mnt/e02/uenv/var/lib/containerd
sudo chmod -R 755 /mnt/e02/uenv/var/lib/containerd
```

{% endcode %}

### **Docker không start sau khi config**

{% code title="Debug Docker startup" overflow="wrap" lineNumbers="true" %}

```bash
# Validate containerd config
sudo /usr/bin/containerd -c /etc/containerd/config.toml validate

# Kiểm tra thư mục đích
ls -la /mnt/e02/uenv/var/lib/containerd

# Xem logs containerd
sudo journalctl -u containerd -n 50 --no-pager

# Xem logs docker
sudo journalctl -u docker -n 50 --no-pager
```

{% endcode %}

### **Containers không start sau migration**

{% code title="Debug containers" overflow="wrap" lineNumbers="true" %}

```bash
# Kiểm tra snapshots
sudo ctr snapshots list

# Fix permission nếu cần
sudo chown -R root:root /mnt/e02/uenv/var/lib/containerd

# Restart services
sudo systemctl restart containerd
sudo systemctl restart docker
```

{% endcode %}

### **Rollback nếu có vấn đề**

Nếu gặp sự cố không thể giải quyết, hoàn nguyên về cấu hình cũ:

{% code title="Rollback" overflow="wrap" lineNumbers="true" %}

```bash
sudo systemctl stop docker containerd

# Restore config
sudo cp /etc/containerd/config.toml.bak /etc/containerd/config.toml

# Di chuyển dữ liệu về vị trí cũ
sudo mv /mnt/e02/uenv/var/lib/containerd/* /var/lib/containerd/ 2>/dev/null || true

# Khởi động lại
sudo systemctl start containerd docker
```

{% endcode %}

***

## **8. Best Practices**

* **Lên kế hoạch trước:** Thông báo team, chọn lịch giờ ít traffic, backup containers quan trọng.
* **Giám sát trong quá trình migrate:** Sử dụng `watch -n 1 'df -h / | tail -1'` và `sudo lsof | grep containerd` để theo dõi.
* **Tối ưu thêm nếu cần:** Chạy `sudo docker image prune -a -f` để dọn dẹp images không dùng, cleanup snapd cache.
* **Document lại:** Lưu note containerd root path mới, backup config, thêm vào runbook team.
* **Giám sát dài hạn:** Thiết lập cron job kiểm tra dung lượng hoặc dùng monitoring tools (Prometheus + Grafana, Datadog).

***

## **9. Kết quả thực tế**

Trên một máy Ubuntu 24.04 LTS với Docker CE và Containerd v1.7+:

### **Trước khi di chuyển**

* **Root filesystem:** 54G volume, 47G used (**92%**)
* **Containerd:** 27G (trên root)
* **Status:** FULL

### **Sau khi di chuyển**

* **Root filesystem:** 54G volume, 21G used (**40%**)
* **Containerd:** Đã chuyển sang `/mnt/e02/uenv` (27G)
* **Status:** HEALTHY

Kênh giải phóng: **26GB** (+52% khả dụng root filesystem).

***

## **10. Tài liệu tham khảo**

* **Containerd:** <https://containerd.io/docs/>
* **Docker:** <https://docs.docker.com/>
* **LVM:** <https://ubuntu.com/server/docs/lvm2>
* **Systemd:** <https://systemd.io/>

***

## **FAQ**

* **Q: Có ảnh hưởng gì đến containers không?**
  * **A:** Không. Containers sẽ restart tự động khi Docker start lại. Dữ liệu containers được lưu trên overlay filesystem, không bị mất.
* **Q: Nên chọn partition nào?**
  * **A:** Chọn partition có dung lượng trống >50GB, SSD ưu tiên để đảm bảo hiệu năng I/O.
* **Q: Có cần thay đổi Docker config không?**
  * **A:** Không. Docker chỉ phụ thuộc vào containerd config. Docker daemon vẫn sử dụng cấu hình hiện tại.
* **Q: Tốn bao lâu để di chuyển?**
  * **A:** Với \~27GB dữ liệu trên SSD, thời gian di chuyển khoảng 5-10 phút.
* **Q: Có thể di chuyển lại không?**
  * **A:** Được. Làm tương tự các bước trên với path đích khác. Lưu ý cập nhật config cho đúng.

***

## **Ghi chú**

* Hướng dẫn dựa trên Ubuntu 24.04 LTS, Docker CE, Containerd v1.7+, LVM + ext4.
* Các bản phân phối Linux khác có thể cần điều chỉnh nhỏ về đường dẫn và tên package.
* Luôn backup config trước khi thực hiện bất kỳ thay đổi nào.


# Docker HUB


# nqdev/nginx

ViHAT's customized version of NGINX includes additional useful modules for usage.

Đây là container NGINX tùy chỉnh với các module mở rộng và tích hợp Redis, được phát triển bởi NQDEV team. Container này cung cấp web server hiệu năng cao với advanced features cho production environments.

### 🚀 Khởi động nhanh

```
# START: docker-compose up -d --build --force-recreate --remove-orphans
# STOP: docker-compose down -v
docker-compose up -d --build --force-recreate --remove-orphans
```

### 🧱 Thành phần & Tính năng

#### Core Components

* **NGINX 1.27.2**: High-performance web server và reverse proxy
* **LuaJIT 2.0**: High-performance Lua scripting engine
* **Alpine Linux**: Base image tối ưu về kích thước
* **Redis Integration**: Session management và caching

#### Custom Modules

* ✅ **headers-more-nginx-module**: Advanced HTTP header manipulation
* ✅ **rate-limit-nginx-module**: Request rate limiting
* ✅ **ngx\_http\_geoip\_module**: Geographic IP location
* ✅ **ngx\_http\_image\_filter\_module**: On-the-fly image processing
* ✅ **ngx\_http\_xslt\_filter\_module**: XML transformation
* ✅ **ngx\_http\_js\_module**: JavaScript scripting support

#### Advanced Features

* ✅ **Automated Configuration Backup** với cron jobs
* ✅ **Real IP Detection** từ multiple proxy layers
* ✅ **SSL/TLS Optimization** với modern ciphers
* ✅ **Caching Strategy** với multiple cache zones
* ✅ **GeoIP Location Services** cho geographic routing
* ✅ **Status Monitoring** endpoint trên port 8080
* ✅ **Custom Error Handling** với detailed logging
* ✅ **Multi-port Support** cho different services

### 📦 Build & Deployment

#### Build với custom modules

```
# Build container với all modules
docker build -t nqdev/nginx:1.27.2-alpine-vhs-custom-1.5.1 .

# Kiểm tra modules đã install
docker run --rm nqdev/nginx:1.27.2-alpine-vhs-custom-1.5.1 nginx -V
```

#### Docker Compose (Khuyến nghị)

```
# # # # # Nginx Proxy with Redis Integration
# START: docker-compose up -d --build --force-recreate --remove-orphans
# STOP: docker-compose down -v
# # # # #

services:
  nginx-server:
    image: nqdev/nginx:1.27.2-alpine-vhs-custom-1.5.1
    build:
      context: ./
      dockerfile: ./Dockerfile
    container_name: nginx-server
    restart: always
    user: root
    ports:
      - "32768:80" # HTTP main port
      - "18080:8080" # Status monitoring
      - "32769:81" # Additional service port
      - "32770:82" # Additional service port
      - "32771:83" # Additional service port
    environment:
      TZ: Asia/Ho_Chi_Minh
      NGINX_HTTP_PORT_NUMBER: 80
      NGINX_HTTPS_PORT_NUMBER: 443
      CRONTAB_ENABLE: true
    volumes:
      - ./data-etc/nginx/nginx.conf:/etc/nginx/nginx.conf:rw
      - ./data-etc/nginx/conf.d/:/etc/nginx/conf.d:rw
      - ./data-etc/nginx/njs/:/etc/nginx/njs:rw
      - ./data-etc/nginx/stream.d/:/etc/nginx/stream.d:rw
      - ./data-log/nginx/:/var/log/nginx:rw
      - ./data-share/GeoIP/:/usr/share/GeoIP:rw
      - ./data-share/nginx/:/usr/share/nginx:rw
    depends_on:
      - nginx-redis
    dns:
      - 8.8.8.8
      - 8.8.4.4
      - 1.1.1.1
      - 1.0.0.1
    deploy:
      resources:
        limits:
          cpus: "0.80"
          memory: "3.2G"
        reservations:
          cpus: "0.25"
          memory: "256M"

  nginx-redis:
    image: redis:alpine3.18
    container_name: nginx-redis
    restart: always
    ports:
      - "6379:6379"
    environment:
      - TZ=Asia/Ho_Chi_Minh
    deploy:
      resources:
        limits:
          cpus: "0.80"
          memory: "3.2G"
        reservations:
          cpus: "0.25"
          memory: "256M"
```

#### Standalone Docker

```
docker run -d \
  --name nginx-server \
  -p 32768:80 \
  -p 18080:8080 \
  -e TZ=Asia/Ho_Chi_Minh \
  -e CRONTAB_ENABLE=true \
  -v ./nginx.conf:/etc/nginx/nginx.conf:rw \
  -v ./logs:/var/log/nginx:rw \
  nqdev/nginx:1.27.2-alpine-vhs-custom-1.5.1
```

### 🗂️ Cấu trúc Container

#### Thư mục chính

```
/etc/nginx/                           # NGINX configuration
├── nginx.conf                        # Main configuration
├── conf.d/                           # Server configurations
│   └── nginx_status.conf             # Status endpoint
├── include/                          # Shared configurations
│   ├── log.conf                      # Logging setup
│   ├── resolvers.conf                # DNS resolvers
│   ├── ip_ranges.conf                # IP range definitions
│   ├── ssl-ciphers.conf              # SSL configuration
│   └── proxy.conf                    # Proxy settings
├── njs/                              # JavaScript files
└── stream.d/                         # Stream configurations

/usr/lib/nginx/modules/               # Custom modules
├── ngx_http_headers_more_filter_module.so
├── ngx_http_rate_limit_module.so
├── ngx_http_geoip_module.so
├── ngx_http_image_filter_module.so
├── ngx_http_xslt_filter_module.so
└── ngx_http_js_module.so

/usr/share/GeoIP/                     # GeoIP databases
├── GeoIP.dat                         # Country database
└── GeoLiteCity.dat                   # City database

/var/backups/nginx_config/            # Automated backups
└── nginx_config_YYYYMMDD.tar.gz

/var/tmp/nginx/cache/                 # Cache directories
├── body/                             # Request body cache
├── public/                           # Public cache zone
└── private/                          # Private cache zone
```

### ⚙️ Configuration Features

#### Custom Modules Loading

```
# Load custom modules
load_module /usr/lib/nginx/modules/ngx_http_headers_more_filter_module.so;
load_module /usr/lib/nginx/modules/ngx_http_image_filter_module.so;
load_module /usr/lib/nginx/modules/ngx_http_xslt_filter_module.so;
load_module /usr/lib/nginx/modules/ngx_http_geoip_module.so;
load_module /usr/lib/nginx/modules/ngx_stream_geoip_module.so;
load_module /usr/lib/nginx/modules/ngx_http_js_module.so;
```

#### Real IP Detection

```
# Real IP từ multiple proxy layers
set_real_ip_from 10.0.0.0/8;
set_real_ip_from 172.16.0.0/12;
set_real_ip_from 192.168.0.0/16;
real_ip_header X-Real-IP;
real_ip_recursive on;
```

#### Proxy Cache Configuration

```
# Multiple cache zones
proxy_cache_path /var/tmp/nginx/cache/public  levels=1:2 keys_zone=public-cache:30m max_size=192m;
proxy_cache_path /var/tmp/nginx/cache/private levels=1:2 keys_zone=private-cache:5m max_size=1024m;
```

#### GeoIP Integration

```
# Geographic location services
geoip_country /usr/share/GeoIP/GeoIP.dat;
geoip_city    /usr/share/GeoIP/GeoLiteCity.dat;
geoip_proxy_recursive on;
```

#### Security Headers

```
# Remove sensitive headers
more_clear_headers "X-Powered-By";
more_clear_headers "Server";

# SSL optimization
ssl_prefer_server_ciphers on;
```

### 🔧 Advanced Usage Examples

#### Rate Limiting với Custom Module

```
http {
    # Rate limiting zones
    limit_req_zone $binary_remote_addr zone=api:10m rate=10r/s;
    limit_req_zone $binary_remote_addr zone=general:10m rate=1r/s;

    server {
        location /api/ {
            limit_req zone=api burst=20 nodelay;
            proxy_pass http://backend;
        }
    }
}
```

#### Image Processing với Image Filter

```
location ~ ^/resize/(\d+)x(\d+)/(.+) {
    set $width $1;
    set $height $2;
    set $image_path $3;

    image_filter resize $width $height;
    image_filter_jpeg_quality 95;

    try_files /$image_path =404;
}
```

#### Header Manipulation

```
server {
    # Custom security headers
    more_set_headers "X-Frame-Options: DENY";
    more_set_headers "X-Content-Type-Options: nosniff";
    more_set_headers "X-XSS-Protection: 1; mode=block";

    # Custom application headers
    more_set_headers "X-Backend-Server: $upstream_addr";
    more_set_headers "X-Response-Time: $upstream_response_time";
}
```

#### Geographic Routing

```
map $geoip_country_code $allowed_country {
    default no;
    VN yes;
    US yes;
    JP yes;
}

server {
    if ($allowed_country = no) {
        return 403;
    }
}
```

### 📊 Monitoring & Status

#### Status Endpoint

* **URL**: <http://localhost:18080/nginx_status>
* **Features**: Active connections, requests per second, server metrics
* **Access**: Restricted to localhost và local networks

#### Status Response Example

```
Active connections: 15
server accepts handled requests
 1234 1234 5678
Reading: 2 Writing: 5 Waiting: 8
```

#### Backup Monitoring

```
# Check backup logs
docker exec nginx-server tail -f /var/log/nginx/nginx_backup.log

# Manual backup
docker exec nginx-server /usr/local/bin/100-backup-nginx.sh
```

### 🔍 Management Scripts

#### Configuration Validation

```
# Verify NGINX configuration
./01-verify-config.sh

# Reload configuration
./02-reload-config.sh

# Startup with build
./00-startup.sh
```

#### Health Checks

```
# Test configuration syntax
docker exec nginx-server nginx -t

# Check loaded modules
docker exec nginx-server nginx -V

# View active processes
docker exec nginx-server ps aux | grep nginx
```

### 📋 Environment Variables

| Biến                       | Mặc định           | Mô tả                    |
| -------------------------- | ------------------ | ------------------------ |
| `TZ`                       | `Asia/Ho_Chi_Minh` | Container timezone       |
| `NGINX_HTTP_PORT_NUMBER`   | `80`               | HTTP port number         |
| `NGINX_HTTPS_PORT_NUMBER`  | `443`              | HTTPS port number        |
| `NGINX_STATUS_PORT_NUMBER` | `8080`             | Status monitoring port   |
| `CRONTAB_ENABLE`           | `false`            | Enable automated backups |

### 🔒 Security Features

#### SSL/TLS Configuration

```
# Modern SSL configuration
ssl_protocols TLSv1.2 TLSv1.3;
ssl_ciphers ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256;
ssl_prefer_server_ciphers off;
```

#### Access Control

```
# IP-based access control
allow 192.168.1.0/24;
allow 10.0.0.0/8;
deny all;

# Geographic restrictions
if ($geoip_country_code !~ ^(VN|US|JP)$) {
    return 403;
}
```

#### Request Filtering

```
# Block suspicious requests
if ($request_method !~ ^(GET|HEAD|POST|PUT|DELETE|OPTIONS)$ ) {
    return 405;
}

# Rate limiting per IP
limit_req zone=general burst=10 nodelay;
```

### 🚀 Production Deployment

#### High Availability Setup

```
# Load balancer configuration
upstream backend_servers {
least_conn;
server web1:80 weight=3;
server web2:80 weight=2;
server web3:80 weight=1 backup;
}

server {
location / {
proxy_pass http://backend_servers;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
}
}
```

#### Performance Optimization

```
# Worker optimization
worker_processes auto;
worker_connections 1024;

# Buffer optimization
client_body_buffer_size 128k;
client_max_body_size 2000m;
large_client_header_buffers 4 16k;

# Timeout optimization
keepalive_timeout 90s;
proxy_connect_timeout 90s;
proxy_read_timeout 90s;
```

#### Caching Strategy

```
# Static asset caching
location ~* \.(jpg|jpeg|png|gif|ico|css|js)$ {
    expires 1y;
    add_header Cache-Control "public, immutable";
}

# Dynamic content caching
location /api/ {
    proxy_cache private-cache;
    proxy_cache_valid 200 302 10m;
    proxy_cache_valid 404 1m;
}
```

### 📜 License

Distributed under the MIT License. See `LICENSE` for more information.

### 👨‍💻 Maintainer

**NQDEV Team**

* 📧 Email: <quynh@nhquydev.net>
* 🌐 Website: [nhquydev.net](https://nhquydev.net/)
* 📦 Container Registry: [GitHub Packages](https://github.com/nqdev-group/containers/pkgs/container/nginx)
* 📖 NGINX Documentation: [NGINX Documentation](https://nginx.org/en/docs/)


# nqdev/postgres-pgagent

docker pull nqdev/postgres-pgagent:latest

Đây là container PostgreSQL tùy chỉnh với pgAgent và HTTP extension, được phát triển bởi NQDEV team. Container này tích hợp đầy đủ các tính năng để quản lý job scheduling và HTTP requests trực tiếp từ PostgreSQL.

### 🚀 Khởi động nhanh

```
# START: docker-compose up -d --build --force-recreate --remove-orphans
# STOP: docker-compose down -v
docker-compose up -d --build --force-recreate --remove-orphans
```

### 🧱 Thành phần & Tính năng

#### Core Components

* **PostgreSQL 17.5**: Database engine chính với timezone Vietnam (`Asia/Ho_Chi_Minh`)
* **pgAgent**: Hệ thống job scheduling cho PostgreSQL
* **HTTP Extension**: Cho phép thực hiện HTTP requests từ PostgreSQL
* **Multi-stage Build**: Tối ưu kích thước image với builder pattern

#### Tính năng đặc biệt

* ✅ **Tự động khởi tạo extensions** (pgagent, http)
* ✅ **Error handling** với trap mechanism trong shell scripts
* ✅ **Custom initialization scripts** với logging chi tiết
* ✅ **Wait-for-it utility** để đảm bảo database sẵn sàng
* ✅ **Data checksums** mặc định cho integrity checking
* ✅ **Resource limits** (CPU: 80%, RAM: 3.2G)

### 📦 Build & Deployment

#### Build với version tùy chỉnh

```
# Build với PostgreSQL version mặc định (17.5)
docker build -t nqdev/postgres-pgagent:latest .

# Build với version khác
docker build --build-arg VERSION=16.4 -t nqdev/postgres-pgagent:16.4 .
```

#### Docker Compose (Khuyến nghị)

```
# # # # # PostgreSQL + pgAgent, pgsql-http extension
# START: docker-compose up -d --build --force-recreate --remove-orphans
# STOP: docker-compose down -v
# # # # #

services:
  postgres-pgagent:
    container_name: postgres-pgagent-custom
    image: postgres:17.5-custom
    build:
      context: ./
      dockerfile: ./Dockerfile
    ports:
      - "5432:5432"
    environment:
      TZ: Asia/Ho_Chi_Minh
      POSTGRES_USER: ${POSTGRES_USER:-superuser}
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD:-superuser}
      POSTGRES_DB: ${POSTGRES_DB:-postgresdb}
      POSTGRES_HOST_AUTH_METHOD: trust
      POSTGRES_PORT: ${POSTGRES_PORT:-5432}
      POSTGRES_INITDB_ARGS: ${POSTGRES_INITDB_ARGS:-"--data-checksums"}
    env_file:
      - .env
    volumes:
      - ./data:/var/lib/postgresql/data:rw
    extra_hosts:
      - "host.docker.internal:host-gateway"
    dns:
      - 1.1.1.1
      - 1.0.0.1
      - 8.8.8.8
      - 8.8.4.4
    logging:
      driver: "json-file"
      options:
        max-size: "100m"
        max-file: "5"
    deploy:
      resources:
        limits:
          cpus: "0.80"
          memory: "3.2G"
        reservations:
          memory: "256M"
```

#### Standalone Docker

```
docker run -d \
  --name postgres-pgagent-custom \
  -e POSTGRES_PASSWORD=superuser \
  -e POSTGRES_USER=superuser \
  -e POSTGRES_DB=postgresdb \
  -e TZ=Asia/Ho_Chi_Minh \
  -v ./data:/var/lib/postgresql/data:rw \
  -p 5432:5432 \
  nqdev/postgres-pgagent:latest
```

### 🗂️ Cấu trúc Container

#### Thư mục chính

```
/docker-entrypoint-initdb.d/          # Auto-initialization scripts
├── 10-init-http.sql                  # HTTP extension setup
└── 11-init-pgagent.sql               # pgAgent extension setup

/nqdev/postgres/                       # Custom NQDEV structure
├── data/                              # Database data (volume mount)
├── logs/                              # Application logs (volume mount)
└── scripts/                           # Shell utilities
    ├── 00-init-custom.sh              # Custom SQL initialization
    ├── 01-docker-entrypoint.sh        # Main entrypoint script
    ├── 02-docker-ensure-initdb.sh     # Init verification
    └── 10-wait-for-it.sh              # Connection utility
```

#### Library locations

* **HTTP Extension**: `/usr/lib/postgresql/17/lib/http.so`
* **pgAgent**: Installed via system packages
* **PostgreSQL Server Dev**: `/usr/include/postgresql/`

### 🧪 Sử dụng Extensions

#### HTTP Extension

```
-- Kích hoạt extension
CREATE EXTENSION IF NOT EXISTS http;

-- Thực hiện GET request
SELECT status, content::json
FROM http_get('https://api.github.com/repos/octocat/Hello-World');

-- POST request với data
SELECT status, content
FROM http_post('https://httpbin.org/post',
               '{"key": "value"}',
               'application/json');
```

#### pgAgent Job Scheduling

```
-- Kích hoạt extension
CREATE EXTENSION IF NOT EXISTS pgagent;

-- Tạo job đơn giản
DO $$
DECLARE
    jid integer;
    scid integer;
BEGIN
    -- Tạo job
    INSERT INTO pgagent.pga_job (jobjclid, jobname)
    VALUES (1, 'Daily Maintenance') RETURNING jobid INTO jid;

    -- Tạo step
    INSERT INTO pgagent.pga_jobstep (jstjobid, jstname, jstkind, jstcode)
    VALUES (jid, 'Analyze Tables', 's', 'ANALYZE;');
END $$;
```

### ⚙️ Biến môi trường

| Biến                        | Mặc định           | Mô tả                   |
| --------------------------- | ------------------ | ----------------------- |
| `POSTGRES_USER`             | `superuser`        | Username cho PostgreSQL |
| `POSTGRES_PASSWORD`         | `superuser`        | Password (bắt buộc)     |
| `POSTGRES_DB`               | `postgresdb`       | Database name mặc định  |
| `POSTGRES_HOST_AUTH_METHOD` | `trust`            | Phương thức xác thực    |
| `POSTGRES_PORT`             | `5432`             | Port PostgreSQL         |
| `POSTGRES_INITDB_ARGS`      | `--data-checksums` | Tham số initdb          |
| `TZ`                        | `Asia/Ho_Chi_Minh` | Timezone                |

### 🔧 Scripts & Automation

#### Initialization Flow

1. **00-init-custom.sh**: Thực thi custom SQL scripts với error handling
2. **01-docker-entrypoint.sh**: Main PostgreSQL entrypoint với extended features
3. **02-docker-ensure-initdb.sh**: Đảm bảo database được khởi tạo đúng cách

#### Error Handling Features

* Global error trapping với `set -Eeo pipefail`
* Detailed logging cho mọi bước initialization
* Graceful error messages với line number tracking

#### Wait-for-it Utility

```
# Đợi PostgreSQL sẵn sàng
./scripts/10-wait-for-it.sh localhost:5432 --timeout=30 -- echo "PostgreSQL is ready!"
```

### 🔍 Health Checks & Monitoring

#### Kiểm tra trạng thái

```
# Kết nối database
docker exec -it postgres-pgagent-custom psql -U superuser -d postgresdb

# Kiểm tra extensions
docker exec -it postgres-pgagent-custom psql -U superuser -d postgresdb -c "\dx"

# Xem logs
docker logs postgres-pgagent-custom
```

#### Performance Monitoring

```
-- Kiểm tra connection stats
SELECT * FROM pg_stat_activity;

-- Monitor job execution (pgAgent)
SELECT * FROM pgagent.pga_joblog ORDER BY jlgstart DESC LIMIT 10;
```

### 📋 Volumes & Data Management

#### Recommended Volume Mounts

```
# Persistent data storage
-v ./data:/var/lib/postgresql/data:rw

# Log access (optional)
-v ./logs:/nqdev/postgres/logs:rw

# Custom config (optional)
-v ./custom-config:/nqdev/postgres/config:ro
```

#### Backup Strategy

```
# Database dump
docker exec postgres-pgagent-custom pg_dump -U superuser postgresdb > backup.sql

# Full data directory backup (với container dừng)
docker-compose down
tar -czf postgres-backup-$(date +%Y%m%d).tar.gz ./data
docker-compose up -d
```

### 🔒 Security Notes

* **Host Auth Method**: Mặc định `trust` cho development, khuyến nghị `scram-sha-256` cho production
* **Network Security**: Container isolated với custom DNS servers
* **Resource Limits**: CPU 80%, Memory 3.2G để tránh system overload
* **Data Checksums**: Enabled mặc định cho data integrity

### 🚀 Production Deployment

#### Docker Compose Override

```
# docker-compose.prod.yml
services:
  postgres-pgagent:
    environment:
      POSTGRES_HOST_AUTH_METHOD: scram-sha-256
    volumes:
      - postgres-data:/var/lib/postgresql/data
      - postgres-logs:/nqdev/postgres/logs
    networks:
      - postgres-network

volumes:
  postgres-data:
    driver: local
  postgres-logs:
    driver: local

networks:
  postgres-network:
    driver: bridge
```

### 📜 License

Distributed under the MIT License. See `LICENSE` for more information.

### 👨‍💻 Maintainer

**NQDEV Team**

* 📧 Email: <quynh@nhquydev.net>
* 🌐 Website: [nhquydev.net](https://nhquydev.net/)
* 📦 Container Registry: [GitHub Packages](https://github.com/nqdev-group/containers/pkgs/container/postgres-pgagent)


# Native Apps


# Tini


# Tini là gì? Vì sao gần như mọi container đều nên dùng?

Trong thế giới container hoá, nơi ứng dụng được đóng gói gọn nhẹ và chạy độc lập, có một “người hùng thầm lặng” nhưng cực kỳ quan trọng: tini.

Dù kích thước chỉ vài kilobytes, tini lại giải quyết một vấn đề cốt lõi — điều mà rất nhiều lập trình viên chỉ nhận ra khi ứng dụng bắt đầu bị treo, zombie process tăng dần, hoặc các tín hiệu điều khiển (SIGTERM, SIGINT…) không hoạt động như mong đợi.

***

## **1. Vì sao cần một init process trong container?**

Khác với hệ điều hành truyền thống, một container **không có đầy đủ hệ thống init** để quản lý tiến trình. Điều này dẫn đến một loạt vấn đề:

#### **■ Zombie process không được thu gom**

Các tiến trình con kết thúc nhưng không được `wait()` → trở thành zombie → chiếm tài nguyên và dồn ứ theo thời gian.

#### **■ Ứng dụng không nhận đúng tín hiệu tắt**

Docker gửi `SIGTERM` để dừng container.\
Nhưng nếu ứng dụng nằm dưới nhiều lớp process, tín hiệu có thể **không truyền xuống** đúng nơi cần thiết.

#### **■ Container dừng chậm, shutdown không sạch**

Khi ứng dụng không nhận tín hiệu, Docker buộc phải `SIGKILL` → dừng đột ngột → rủi ro mất dữ liệu hoặc ngắt kết nối không an toàn.

Chính vì vậy, cần một tiến trình đứng ở PID 1 đủ “khôn ngoan” để xử lý tín hiệu và thu gom tiến trình con.

***

## **2. Tini – init system tối giản nhưng hiệu quả**

#### **Tini làm gì?**

* Đóng vai trò **PID 1** bên trong container.
* Nhận và chuyển tiếp mọi tín hiệu chuẩn (SIGTERM, SIGINT…) đến ứng dụng của bạn.
* Thu gom zombie process để tránh tràn tài nguyên.
* Đảm bảo container dừng đúng cách, an toàn và có kiểm soát.

#### **Điểm nổi bật**

* **Rất nhẹ** – chỉ vài kilobytes.
* **Không phụ thuộc phức tạp** – không cần cấu hình nhiều.
* **Ổn định và được Docker khuyên dùng**.
* **Tích hợp sẵn trong Docker (tùy chọn `--init`)**.

***

## **3. So sánh Tini với các giải pháp khác**

### **a/ So với việc không dùng init (chạy thẳng ứng dụng)**

| Tiêu chí       | Không init              | Tini                 |
| -------------- | ----------------------- | -------------------- |
| Xử lý tín hiệu | Thường sai lệch, bỏ sót | Đầy đủ, chính xác    |
| Zombie process | Dễ phát sinh            | Được thu gom tự động |
| Shutdown       | Chậm hoặc không sạch    | An toàn, theo chuẩn  |
| Độ ổn định     | Phụ thuộc ứng dụng      | Đồng đều, ổn định    |
| Thiết lập      | Dễ nhưng rủi ro         | Chỉ thêm 1 dòng lệnh |

**Kết luận:** tini giải quyết triệt để các vấn đề mà ứng dụng đơn lẻ không thể tự xử lý.

***

### **b/ So với s6, runit hoặc systemd**

| Công cụ        | Trọng lượng | Độ phức tạp  | Mục đích               |
| -------------- | ----------- | ------------ | ---------------------- |
| **systemd**    | Nặng        | Rất phức tạp | Quản lý dịch vụ đầy đủ |
| **s6 / runit** | Nhẹ vừa     | Vừa phải     | Supervisor + init      |
| **tini**       | Siêu nhẹ    | Tối giản     | Chỉ làm init + signal  |
| **Không init** | Rất nhẹ     | Không có     | Nhiều rủi ro           |

**Tini hợp lý nhất** khi bạn chỉ cần một init an toàn, đơn giản, không rườm rà.

***

## **4. Cách dùng Tini trong Docker**

#### **Cách 1: Bật init tích hợp sẵn của Docker**

```bash
docker run --init your-image
```

#### **Cách 2: Dùng trực tiếp trong Dockerfile**

```dockerfile
ENTRYPOINT ["/usr/bin/tini", "--"]
CMD ["your_app"]
```

#### **Dùng Alpine Linux (rất phổ biến)**

```dockerfile
apk add --no-cache tini
ENTRYPOINT ["/sbin/tini", "--"]
```

***

## **Kết luận – Một lựa chọn nhỏ, mang lại sự ổn định lớn**

Tuy nhỏ bé, **tini lại đóng vai trò nền tảng để container vận hành ổn định và chuyên nghiệp**.\
Trong môi trường triển khai thực tế — từ server cá nhân đến hệ thống Kubernetes quy mô lớn — tini giúp ứng dụng:

* Vận hành an toàn
* Xử lý tín hiệu chính xác
* Dọn dẹp tiến trình sạch sẽ
* Giảm lỗi khó đoán và tiết kiệm tài nguyên

Nếu bạn hướng đến một hệ thống bền vững, dễ bảo trì, việc bổ sung tini vào container là một bước nhỏ nhưng có tầm nhìn dài hạn.


# Podman


# Visual Studio 2026 Insiders chính thức hỗ trợ Podman – Phát triển container an toàn hơn, linh hoạt

Trong nhiều năm qua, **Docker** gần như là “chuẩn mặc định” trong thế giới container. Hầu hết các quy trình CI/CD, môi trường phát triển, và công cụ IDE đều xây dựng quanh Docker. Tuy nhiên, thế giới phần mềm không ngừng thay đổi — và giờ đây, **Visual Studio 2026 Insiders** đã đánh dấu một bước ngoặt quan trọng: **hỗ trợ chính thức Podman**, cho phép các nhà phát triển **xây dựng, chạy và gỡ lỗi ứng dụng container trực tiếp trong Visual Studio mà không cần Docker daemon**.

<figure><img src="https://raw.githubusercontent.com/nqdev-storage/s3-001/refs/heads/main/gitbook/blogs/cong-nghe/visual-studio-2026-insiders-podman.jpg" alt="Visual Studio 2026 Insiders - Podman"><figcaption><p>Visual Studio 2026 Insiders - Podman</p></figcaption></figure>

Đây không chỉ là một cập nhật kỹ thuật, mà còn là **một thay đổi lớn trong cách chúng ta phát triển và triển khai phần mềm containerized**.

***

### 🧩 Podman là gì?

**Podman** (Pod Manager) là một công cụ mã nguồn mở do **Red Hat** phát triển, được thiết kế như một **thay thế tương thích với Docker**. Giống Docker, Podman cho phép người dùng tạo, chạy, và quản lý container OCI (Open Container Initiative). Nhưng điểm khác biệt cốt lõi nằm ở **kiến trúc không có daemon** và khả năng **chạy container không cần quyền root (rootless containers)**.

Cụ thể, Podman hoạt động như một tập hợp các tiến trình người dùng (user-space processes), thay vì một dịch vụ nền duy nhất có quyền cao.\
Điều này mang lại lợi ích lớn về **bảo mật, linh hoạt, và khả năng tích hợp trong môi trường doanh nghiệp**.

***

### ⚙️ Docker vs Podman – So sánh toàn diện

| Tiêu chí                   | **Docker**                                      | **Podman**                                                                     |
| -------------------------- | ----------------------------------------------- | ------------------------------------------------------------------------------ |
| **Daemon**                 | Có (Docker Daemon chạy nền, yêu cầu quyền root) | Không có daemon – mọi tiến trình chạy trực tiếp dưới quyền người dùng          |
| **Bảo mật**                | Chạy dưới root (có rủi ro cao hơn)              | Hỗ trợ rootless containers, giảm bề mặt tấn công                               |
| **Tương thích CLI**        | Docker CLI                                      | Podman CLI gần như tương thích 100% với Docker (`alias docker=podman`)         |
| **Quản lý container**      | Container hoạt động tách biệt                   | Dựa trên khái niệm “Pods” (nhóm container chia sẻ namespace, giống Kubernetes) |
| **Tích hợp hệ thống**      | Phụ thuộc vào Docker daemon                     | Sử dụng `conmon` và `runc`, tuân thủ chuẩn OCI                                 |
| **Tích hợp IDE & CI/CD**   | Rất phổ biến                                    | Đang được mở rộng mạnh mẽ (Visual Studio, GitHub Actions, OpenShift, v.v.)     |
| **Hiệu năng & tài nguyên** | Có thể nặng khi daemon hoạt động liên tục       | Nhẹ hơn, khởi chạy nhanh hơn, không tốn tài nguyên nền                         |
| **Tương thích nền tảng**   | Windows, macOS, Linux                           | Linux native, hỗ trợ Windows thông qua WSL2 hoặc Podman Machine                |

Nói cách khác, **Podman là phiên bản “hiện đại hóa” của Docker**, với triết lý tập trung vào **bảo mật, tính mở và khả năng tích hợp tốt với hạ tầng cloud-native**.

***

### 💡 Tại sao Visual Studio 2026 lại chọn hỗ trợ Podman?

Khi Microsoft ra mắt Visual Studio 2026 Insiders, họ không chỉ giới thiệu tính năng mới — mà là **thông điệp rõ ràng về hướng phát triển tương lai**:\
👉 **Visual Studio không còn bị ràng buộc bởi Docker.**

Lý do đằng sau quyết định này rất thuyết phục:

#### 1. **Bảo mật tốt hơn cho nhà phát triển**

Docker daemon thường chạy với quyền root, tạo ra rủi ro nếu có lỗi bảo mật hoặc lạm dụng quyền truy cập.\
Podman giải quyết triệt để vấn đề này bằng mô hình **rootless container**, giúp giảm thiểu nguy cơ leo thang đặc quyền (privilege escalation).

#### 2. **Tính tương thích CLI cao**

Podman được thiết kế “drop-in replacement” cho Docker.\
Các lệnh quen thuộc như `docker build`, `docker run`, `docker ps`… đều có thể dùng với Podman mà không cần chỉnh sửa mã hay script.

Điều này giúp Visual Studio dễ dàng **chuyển đổi backend từ Docker sang Podman** mà không thay đổi trải nghiệm của người dùng.

#### 3. **Hiệu suất và độ nhẹ vượt trội**

Do không có daemon chạy nền, Podman tiêu tốn ít tài nguyên hơn, khởi chạy container nhanh hơn và dễ tích hợp vào quy trình phát triển nhẹ (lightweight dev workflows).

#### 4. **Khả năng mở rộng container pods**

Podman hỗ trợ khái niệm **Pods**, tương tự như Kubernetes.\
Điều này cho phép các nhà phát triển mô phỏng môi trường nhiều container (multi-container) ngay trong máy tính cá nhân – mà không cần cluster thật.

***

### 🔧 Trải nghiệm Podman trong Visual Studio 2026 Insiders

Sau khi cài bản **Visual Studio 2026 Insiders** mới nhất, người dùng có thể:

1. **Cài đặt Podman** trên hệ thống (Windows, Linux, hoặc macOS).
2. **Mở dự án có Dockerfile** – Visual Studio sẽ tự động phát hiện và chuyển sang sử dụng Podman backend.
3. **Build, Run, Debug** container trực tiếp trong IDE như với Docker trước đây.

#### 🔍 Những điểm nổi bật khi tích hợp:

* **Tích hợp CLI đầy đủ:** Visual Studio nhận diện Podman CLI tương tự Docker CLI.
* **Gỡ lỗi container trực tiếp:** Debugging hoạt động liền mạch nhờ tích hợp Visual Studio Container Tools.
* **Không yêu cầu Docker Desktop:** Giảm chi phí bản quyền và tài nguyên hệ thống.
* **Hỗ trợ rootless:** Các container chạy trong không gian người dùng, an toàn hơn trên Windows và WSL2.

Microsoft cũng cung cấp bộ **Container Tools** cập nhật để tương thích hoàn toàn với Podman, bao gồm hỗ trợ IntelliSense, logging, và container explorer.

***

### 🧱 Podman và xu hướng “rootless container” trong DevOps

Việc Visual Studio tích hợp Podman không chỉ là tiện ích — mà phản ánh **xu hướng lớn trong cộng đồng DevOps và Cloud-native**.

Các tổ chức ngày càng chú trọng đến:

* **Bảo mật phát triển nội bộ (developer security posture)**
* **Chính sách zero-trust**
* **Giảm quyền hệ thống trong môi trường build/test**

Podman, với mô hình rootless, chính là công cụ lý tưởng để đáp ứng những yêu cầu đó.\
Nó giúp các nhóm DevOps tạo ra môi trường phát triển an toàn hơn mà không ảnh hưởng đến tốc độ hay trải nghiệm.

***

### 💬 Góc nhìn của cộng đồng lập trình viên

Trên các diễn đàn như Reddit, Stack Overflow và GitHub Discussions, phản ứng của cộng đồng khá tích cực.\
Nhiều lập trình viên hoan nghênh việc Visual Studio mở cửa cho Podman, vì:

* Họ có thể **thoát khỏi sự phụ thuộc Docker Desktop** (đặc biệt từ khi Docker chuyển sang mô hình license mới).
* **Podman hoạt động mượt mà trong WSL2** – điều mà nhiều dev Windows yêu cầu.
* Và quan trọng nhất: **Visual Studio vẫn giữ trải nghiệm quen thuộc**, không buộc phải thay đổi workflow hay lệnh CLI.

***

### 🔮 Tương lai của hệ sinh thái container trong Visual Studio

Sự kiện này chỉ là **khởi đầu**.\
Khi Podman được chấp nhận rộng rãi hơn, chúng ta có thể kỳ vọng Visual Studio sẽ mở rộng hỗ trợ cho các công nghệ container khác trong hệ sinh thái **OCI (Open Container Initiative)** như **Buildah** hoặc **Skopeo** – vốn cùng họ với Podman.

Microsoft có thể hướng tới:

* **Tích hợp sâu hơn với Kubernetes & OpenShift**, nhờ mô hình Pods tương thích.
* **Cải thiện trải nghiệm CI/CD** trong Azure DevOps và GitHub Actions dựa trên Podman runner.
* **Tối ưu hóa trải nghiệm cross-platform**, cho phép lập trình viên Windows, Linux, và macOS chia sẻ cùng một công cụ container backend.

### 🧱 Hướng dẫn cài đặt và cấu hình **Podman trong Visual Studio 2026**

Sẵn sàng trải nghiệm container không cần Docker?\
Dưới đây là hướng dẫn chi tiết từng bước để **thiết lập Podman và tích hợp trực tiếp với Visual Studio 2026 Insiders**.

***

#### 🔹 Bước 1: Cài đặt **Podman**

**💻 Trên Windows**

1. **Tải Podman Machine Installer** từ trang chính thức:\
   👉 <https://podman.io/getting-started/installation>
2. Chạy file cài đặt (`Podman-Setup.exe`) và làm theo hướng dẫn.
3. Sau khi hoàn tất, mở **Windows Terminal (hoặc PowerShell)** và khởi tạo máy ảo Podman:

   ```bash
   podman machine init
   podman machine start
   ```
4. Kiểm tra phiên bản:

   ```bash
   podman --version
   ```

   → Nếu hiển thị phiên bản (ví dụ: `Podman version 5.1.2`), bạn đã cài đặt thành công.

> 💡 *Podman trên Windows chạy thông qua một VM nhẹ tương tự Docker Desktop, nhưng không yêu cầu daemon.*

***

**🐧 Trên Linux**

Podman đã có sẵn trong hầu hết các kho phần mềm:

```bash
sudo apt install -y podman        # Ubuntu/Debian
sudo dnf install -y podman        # Fedora/RHEL
sudo pacman -S podman             # Arch Linux
```

Kiểm tra bằng:

```bash
podman info
```

Nếu bạn muốn chạy container rootless:

```bash
podman system migrate
```

***

**🍎 Trên macOS**

1. Cài đặt qua Homebrew:

   ```bash
   brew install podman
   ```
2. Khởi tạo Podman machine:

   ```bash
   podman machine init
   podman machine start
   ```
3. Kiểm tra:

   ```bash
   podman ps
   ```

***

#### 🔹 Bước 2: Cài đặt **Visual Studio 2026 Insiders**

1. Tải bản mới nhất tại:\
   👉 <https://msft.it/6184ssGAp>\
   👉 <https://podman.io/docs/installation>
2. Trong quá trình cài đặt, chọn **“Container Development Tools”** (nằm trong mục Workloads).
3. Sau khi hoàn tất, mở Visual Studio và xác nhận rằng **Container Tools** đã được bật:
   * Vào **Tools → Get Tools and Features → Individual Components**
   * Đảm bảo tùy chọn **“Container Tools”** được tick.

***

#### 🔹 Bước 3: Cấu hình Visual Studio để sử dụng Podman thay cho Docker

1. Mở Visual Studio → **Tools → Options**.
2. Điều hướng tới:

   ```
   Containers → Container Engine
   ```
3. Trong mục **Engine**, chọn:

   ```
   Podman (instead of Docker)
   ```
4. Visual Studio sẽ tự động phát hiện `podman` từ PATH hệ thống.\
   Nếu không, bạn có thể chỉ định thủ công đường dẫn đến `podman.exe`.

> 🧠 *Visual Studio sử dụng các lệnh CLI tương tự Docker, vì vậy bạn không cần chỉnh sửa Dockerfile hoặc task build.*

***

#### 🔹 Bước 4: Kiểm tra bằng dự án mẫu

1. Tạo dự án mới:\
   **File → New → Project → ASP.NET Core Web App (Containerized)**
2. Chọn **Enable container support**.
3. Khi được hỏi chọn công cụ container, chọn:

   ```
   Use Podman
   ```
4. Sau khi dự án được tạo, mở **Terminal trong Visual Studio** và chạy:

   ```bash
   podman ps
   ```

   Bạn sẽ thấy container của ứng dụng đang chạy.

***

#### 🔹 Bước 5: Debug ứng dụng containerized với Podman

Visual Studio 2026 cho phép bạn **gỡ lỗi (debug)** ứng dụng container tương tự như Docker.

* Nhấn **F5** để khởi chạy container.
* IDE sẽ tự động gắn debugger vào tiến trình trong container.
* Bạn có thể:
  * Đặt breakpoint
  * Xem biến, call stack
  * Theo dõi log container trực tiếp trong cửa sổ **Output**.

> 📸 *Hình minh họa gợi ý cho bài blog:*
>
> * Ảnh giao diện Visual Studio hiển thị “Podman Container Tools”
> * Ảnh container đang chạy trong **Container Explorer**
> * Ảnh breakpoint đang hoạt động trong Podman container

***

#### 🔹 Bước 6: (Tuỳ chọn) Gỡ lỗi nhiều container (multi-container)

Nếu dự án của bạn bao gồm nhiều service (ví dụ: API + Database), Visual Studio vẫn hỗ trợ khởi chạy và gỡ lỗi đồng thời với Podman thông qua **Compose hoặc Pods**.

* Sử dụng `podman pod create` để nhóm các container.
* Visual Studio sẽ tự nhận dạng các service trong cùng Pod và cho phép debug đa tiến trình.

***

#### 🔹 Bước 7: Tích hợp CI/CD với Podman

Khi đã cấu hình ổn định, bạn có thể mở rộng sang pipeline CI/CD:

* GitHub Actions: sử dụng `podman build` thay vì `docker build`.
* Azure DevOps: cài Podman trên agent và build image không cần Docker Desktop.

Ví dụ GitHub Action đơn giản:

```yaml
- name: Build container with Podman
  run: podman build -t myapp:latest .
```

***

### 🧭 Tổng kết

Sự tích hợp **Podman trong Visual Studio 2026 Insiders** không chỉ là một tính năng mới, mà là **tuyên bố chiến lược** của Microsoft:

> “Tự do chọn công cụ container bạn muốn, mà vẫn giữ nguyên trải nghiệm Visual Studio.”

Nhờ sự hỗ trợ Podman trong Visual Studio 2026, lập trình viên nay có thể:

* Xây dựng, chạy, và gỡ lỗi ứng dụng container **trực tiếp trong IDE**.
* **Không cần Docker Desktop**, giảm tải hệ thống.
* **Tận dụng bảo mật rootless**, an toàn hơn trong môi trường doanh nghiệp.
* Và **giữ nguyên trải nghiệm phát triển quen thuộc** – chỉ khác ở backend.

Visual Studio một lần nữa chứng minh vì sao nó không chỉ là IDE mạnh mẽ cho .NET, mà còn là nền tảng phát triển container hàng đầu trong kỷ nguyên cloud-native.

Với bước đi này, Visual Studio tiếp tục khẳng định vị thế **IDE hàng đầu cho phát triển containerized ứng dụng hiện đại**, nơi mà hiệu năng, bảo mật và trải nghiệm người dùng cùng song hành.

***

📦 **Tải ngay bản Visual Studio 2026 Insiders mới nhất và khám phá Podman:**\
👉 <https://msft.it/6184ssGAp>


# Podman Desktop & Podman: Lựa chọn thay thế Docker đáng cân nhắc cho Developer hiện đại

Trong bối cảnh hệ sinh thái container ngày càng phát triển, việc tìm kiếm một giải pháp vừa mạnh mẽ, vừa linh hoạt và tối ưu chi phí là điều mà bất kỳ developer nào cũng quan tâm.

Nếu bạn đang quen thuộc với Docker, thì **Podman** và **Podman Desktop** chính là hai cái tên đáng để bạn dành thời gian khám phá.

Bài viết này từ **Cẩm nang NQDEV** sẽ giúp bạn hiểu rõ:

* Podman là gì?
* Podman Desktop có vai trò gì?
* So sánh Podman vs Docker (thực tế & dễ hiểu)
* Khi nào nên chọn Podman?

***

### Podman là gì?

**Podman** là một công cụ quản lý container mã nguồn mở, được phát triển bởi Red Hat. Điểm đặc biệt của Podman là:

* **Không cần daemon (daemonless)** → giảm rủi ro bảo mật
* **Chạy rootless (không cần quyền root)** → an toàn hơn cho hệ thống
* Tương thích CLI với Docker → dễ chuyển đổi

👉 Nói đơn giản: nếu bạn đã quen với `docker run`, thì dùng `podman run` gần như giống hệt.

***

### Podman Desktop là gì?

Nếu Podman là “engine”, thì **Podman Desktop** là “bảng điều khiển trực quan” giúp bạn thao tác dễ dàng hơn.

#### Điểm nổi bật:

* Giao diện GUI thân thiện (giống Docker Desktop)
* Quản lý container, image, volume trực quan
* Tích hợp Kubernetes
* Hỗ trợ extension mở rộng

👉 Phù hợp cho:

* Người mới học container
* Developer thích UI thay vì CLI
* Team cần demo hoặc training

***

### So sánh Podman vs Docker: Khác biệt cốt lõi

#### 1. Kiến trúc (Architecture)

| Tiêu chí      | Podman                         | Docker           |
| ------------- | ------------------------------ | ---------------- |
| Daemon        | ❌ Không cần                    | ✅ Có daemon      |
| Bảo mật       | 🔒 Cao hơn (rootless)          | ⚠️ Thấp hơn      |
| Process model | Mỗi container là process riêng | Phụ thuộc daemon |

👉 Podman giúp hệ thống **ít điểm lỗi hơn** và dễ debug hơn.

***

#### 2. Bảo mật

* Podman chạy container dưới user thường → hạn chế rủi ro
* Docker daemon chạy với quyền root → nếu bị exploit thì nguy hiểm

👉 Trong môi trường production hoặc enterprise → **Podman là lựa chọn an toàn hơn**

***

#### 3. Trải nghiệm sử dụng

| Tiêu chí       | Podman         | Docker         |
| -------------- | -------------- | -------------- |
| CLI            | Giống Docker   | Chuẩn          |
| GUI            | Podman Desktop | Docker Desktop |
| Learning curve | Dễ             | Dễ             |

👉 Nếu bạn đã dùng Docker → gần như không cần học lại

***

#### 4. Kubernetes & Cloud Native

* Podman hỗ trợ generate YAML cho Kubernetes
* Tích hợp tốt với hệ sinh thái Red Hat (OpenShift)

👉 Rất phù hợp nếu bạn theo hướng DevOps / Cloud Native

***

### Khi nào nên chọn Podman?

#### ✅ Nên dùng Podman nếu bạn:

* Muốn **bảo mật cao hơn**
* Làm việc trong môi trường Linux server
* Làm DevOps / Kubernetes
* Muốn tránh phụ thuộc Docker daemon

#### ❌ Có thể vẫn dùng Docker nếu:

* Bạn cần ecosystem lớn hơn
* Team đã quen Docker lâu năm
* Dùng nhiều tool phụ thuộc Docker

***

### Góc nhìn thực tế từ NQDEV Platform

Trong các dự án triển khai trên **NQDEV Platform**, xu hướng đang dịch chuyển rõ rệt:

* Dev local: vẫn dùng Docker cho nhanh
* Production: chuyển sang Podman để tăng bảo mật
* CI/CD: kết hợp cả hai (hybrid)

👉 Đây là hướng đi thực dụng, không cực đoan.

***

### Kết luận

Podman không phải là “kẻ thay thế Docker”, mà là một **bước tiến tự nhiên** trong thế giới container:

* Nhẹ hơn
* An toàn hơn
* Linh hoạt hơn

Nếu bạn là developer hiện đại, việc hiểu và sử dụng Podman sẽ giúp bạn:

* Làm chủ hệ thống tốt hơn
* Tối ưu bảo mật
* Sẵn sàng cho DevOps / Cloud Native

***

📚 Đừng quên khám phá thêm nhiều bài viết chuyên sâu tại:\
👉 [**Cẩm nang NQDEV**](https://blogs.nhquydev.net/)


---

[Next Page](/llms-full.txt/1)